
GPU Direct 技术解决了什么问题,数据为什么可以绕过部分传统数据传输路径
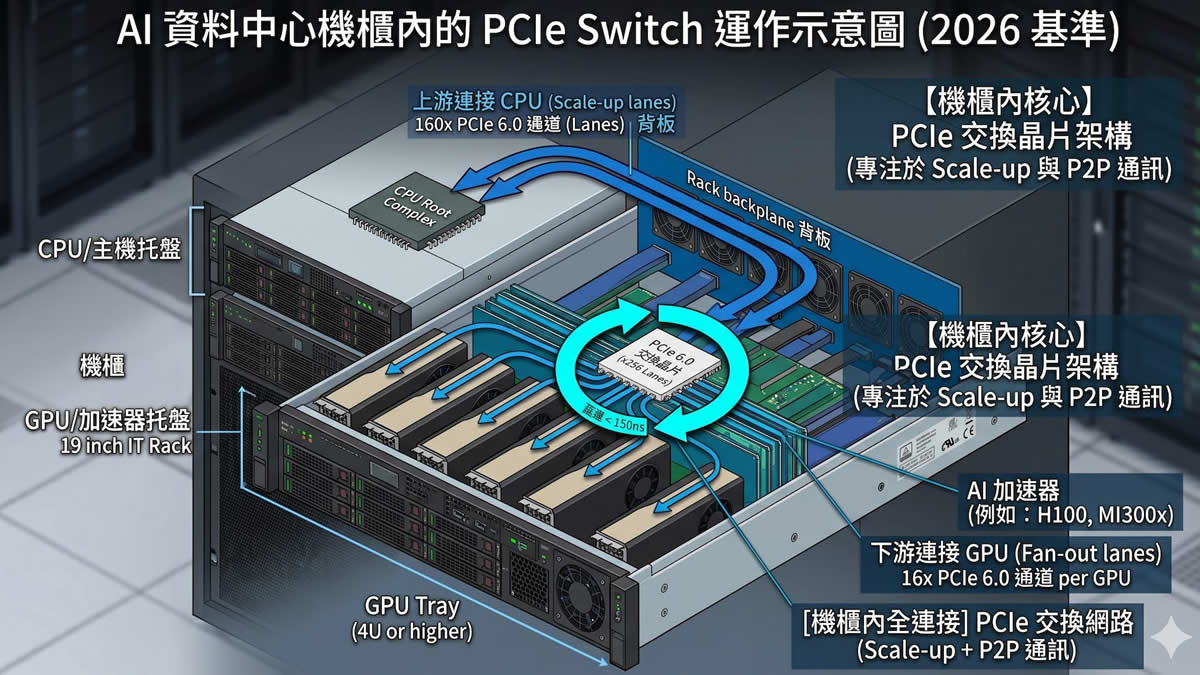
图片说明:示意图 图片来源:Public Domain(公有领域)
在普通计算机中,CPU长期承担着数据交换的中心角色。GPU处理任务时,数据经常需要在GPU显存、系统内存、CPU以及其他PCIe设备之间移动。如果数据量较小,这种方式通常不会造成明显问题,但在人工智能训练、高性能计算和大规模数据处理环境中,GPU每秒处理的数据量越来越大,数据搬运本身可能成为限制系统性能的重要因素。
GPU Direct技术出现的背景,就是减少这些不必要的数据搬运。它并不是简单地把CPU从整个数据传输过程里“删除”,而是通过硬件、驱动和软件协同,让不同设备之间在符合条件的情况下建立更加直接的数据通路,从而减少中间复制和CPU参与。
理解这项技术,首先要区分GPU Direct和GPUDirect RDMA。GPU Direct是一个技术体系,下面包含多种不同的直接数据访问机制。GPUDirect RDMA则主要针对GPU与网络设备之间的数据交换,例如服务器中的GPU与InfiniBand或支持RoCE的高速网卡之间进行通信。
传统的数据路径通常是这样的:网络数据先由网卡通过DMA写入主机内存,然后CPU或者软件网络栈参与数据处理,之后再把数据复制到GPU显存。如果GPU需要把计算结果发送给另一台服务器,也可能经历反向过程。对于需要频繁交换大量数据的分布式AI训练来说,这种反复复制会占用内存带宽、PCIe带宽和CPU资源。
GPUDirect RDMA改变的正是其中一部分路径。支持该机制的网卡可以通过DMA直接向GPU显存读写数据,而不必先把完整数据复制到主机内存,再由CPU参与一次中间搬运。数据路径因此可以从“网卡—主机内存—CPU参与的软件路径—GPU”,缩短为更直接的“网卡—GPU显存”路径。
这里有一个容易产生误解的地方:所谓“绕过CPU”,并不意味着CPU完全没有参与。CPU仍然负责建立通信、管理进程、配置设备和发起相关操作。被减少的是数据搬运过程中对CPU和系统内存的依赖,而不是让CPU从整个通信系统中消失。
这也是GPU Direct能够提高效率的原因之一。大型AI模型训练时,GPU之间需要不断交换梯度、参数以及其他中间数据。如果每一次通信都需要经过主机内存进行额外复制,不仅会增加延迟,还会消耗本来可以用于其他任务的内存带宽。直接数据通路减少了这些中间步骤之后,高速网络设备能够更加充分地把数据送入GPU。
在多GPU和多服务器环境中,这种变化尤其明显。以分布式训练中的AllReduce为例,多台服务器上的GPU需要不断交换计算结果。通信量达到很大规模以后,GPU本身的计算速度可能已经不是主要限制,网络通信和数据搬运反而可能成为瓶颈。GPUDirect RDMA配合高速网络,可以让GPU显存与远端节点之间建立更加高效的数据交换路径,从而减少通信过程中的额外复制。
不过,GPUDirect RDMA并不是单独存在的。它需要GPU、网卡、PCIe拓扑、驱动以及通信软件共同支持。服务器中GPU和网卡之间如何连接也非常重要。如果设备之间经过复杂的PCIe拓扑或者跨越不同的PCIe根节点,实际通信效率可能与理想状态存在明显差距。因此,部署高性能GPU服务器时,不能只看GPU和网卡各自的规格,还需要观察整台服务器的I/O拓扑。
GPU Direct涉及的另一个关键问题是内存注册和地址映射。网卡要直接访问GPU显存,并不是拿到一个显存地址就可以随意读写。系统需要通过驱动和硬件机制建立相应的内存映射和访问权限,确保设备能够访问指定的显存区域,同时避免越权访问。这个过程也是GPU Direct能够安全工作的基础。
数据一致性同样需要硬件和软件共同处理。GPU、CPU和网络设备可能同时参与数据生产与消费,因此系统必须明确什么时候数据已经准备完成、什么时候可以被另一个设备读取。高速通信环境下,如果同步机制设计不合理,即使数据传输速度很高,也可能因为等待和同步产生新的瓶颈。
GPU Direct的价值还体现在CPU负载下降。传统数据传输需要CPU参与较多的数据复制和缓冲管理工作,而直接设备间传输能够把更多的数据移动工作交给DMA等硬件机制完成。这样一来,CPU可以把更多时间用于业务逻辑、任务调度和其他计算,而不是反复处理大块数据复制。
但GPU Direct并不能解决所有性能问题。如果GPU计算能力不足、显存容量不够、网络带宽不足,或者应用程序本身的数据交换方式设计不合理,启用GPU Direct也不会自动获得明显提升。数据传输路径只是整个系统的一部分,最终效果取决于应用的通信模式以及软硬件之间是否形成了完整的高速通路。
在实际应用中,这项技术主要适合数据量大、设备之间通信频繁的场景。大型语言模型训练、分布式深度学习、高性能计算、科学模拟以及部分低延迟数据处理系统,都可能从中受益。尤其是在多GPU、多服务器集群中,当GPU计算速度不断提高以后,数据交换速度的重要性会越来越突出。
从计算机体系结构的发展来看,GPU Direct反映的是一个明显趋势:计算系统正在从以CPU为中心的数据搬运模式,逐渐转向让GPU、网卡、存储设备等加速器之间建立更加直接的通信路径。过去CPU不仅负责计算,也经常充当不同设备之间的数据中转站;现在越来越多的数据移动任务开始交给专门的硬件和DMA机制完成。
因此,GPU Direct的意义并不是简单地“让GPU绕过CPU”,而是减少没有必要的数据复制和中间环节。GPUDirect RDMA进一步把这种思路延伸到网络通信,让GPU显存能够在支持相应硬件和软件条件的情况下直接参与高速网络数据交换。对于需要处理海量数据的计算集群,减少一次数据复制、缩短一段传输路径,有时就可能成为提升整体系统效率的重要环节。
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP