
一个几百GB甚至上TB的AI模型,从服务器磁盘上的权重文件变成GPU可以直接参与计算的张量,并不是简单执行一次“读取文件,然后复制到显存”这么简单。中间至少涉及文件系统、存储控制器、CPU内存、操作系统虚拟内存、数据格式解析、模型参数初始化、CPU到GPU的数据传输、GPU显存分配,以及CUDA或ROCm运行时和深度学习框架的协调。
如果模型来自远程对象存储,还要再增加网络这一层。如果是多GPU模型,则还会涉及GPU之间的互联和参数分片。如果模型无法完整放入显存,还可能出现CPU offload、GPU间切分或者按层加载等完全不同的数据路径。
理解这条路径,对判断“为什么一个模型需要几分钟才能启动”“为什么SSD明明很快,GPU却没有吃满”“为什么增加GPU后加载速度没有同步增加”等问题非常重要。
模型文件首先只是磁盘上的字节
模型通常以某种序列化格式存储在NVMe SSD、本地文件系统、网络文件系统或者对象存储中。常见形式包括Safetensors、PyTorch checkpoint以及其他框架自己的权重格式。
此时磁盘里的模型只是字节序列,并不是GPU已经可以执行的张量。
假设一个模型的权重文件总大小为200GB,如果存储设备能够持续提供5GB/s左右的有效读取吞吐,那么仅仅把200GB数据从存储设备读取出来,理论下限就是几十秒量级。实际启动时间还要加入文件系统、读取队列、数据格式处理、CPU内存分配、权重转换以及GPU传输等开销。
因此,模型文件大小是决定冷启动时间的第一项硬约束。
不过不能简单用“SSD标称顺序读取速度”计算最终启动时间。消费级NVMe SSD在空载时可以达到很高的顺序读取速度,但AI服务器中的实际吞吐还取决于PCIe链路、SSD数量、RAID或软件并行方式、文件系统、队列深度、CPU处理能力以及同时运行的其他任务。
大量小文件尤其麻烦。
如果模型被拆成数百甚至数千个小文件,系统除了读取数据,还需要不断处理文件元数据和打开、关闭文件。大模型部署通常更倾向于使用合理大小的shard,把大量参数组织成较少数量的大文件,从而减少元数据和随机访问开销。
如果模型来自远程存储,网络会进入数据路径
本地NVMe并不是所有AI服务器的模型来源。
大型训练集群经常使用对象存储、并行文件系统、分布式文件系统或者其他网络存储系统。此时数据路径可能变成:
远程存储
↓
网络接口
↓
网络交换设备
↓
服务器网络接口
↓
CPU/内存
↓
GPU
100Gbps网络的理论线速约为12.5GB/s,400Gbps则约为50GB/s。实际应用吞吐会受到协议、网络拓扑、存储端能力、并发请求、拥塞以及软件栈影响。
因此,“100Gbps网络传输100GB文件需要10秒”只能作为理想带宽计算,不能再额外人为加入一个固定的“3到5秒协议开销”。网络协议并不存在一个适用于所有环境的固定开销时间。
如果远程存储能够提供足够高的并发吞吐,网络甚至可能比单块NVMe SSD更快;如果存储后端本身只有很低的吞吐,那么即使服务器拥有400Gbps网络,模型加载也不会凭空变快。
这也是AI基础设施中经常出现的一个问题:网络带宽很大,并不代表存储系统一定快。
CPU内存是GPU加载过程中的重要中间层
在最常见的模型加载路径中,模型数据首先进入主机CPU可访问的内存空间。
更准确地说,应用程序通过操作系统文件接口读取数据,操作系统和文件系统负责将数据从存储设备放入内核管理的内存页或直接交给应用程序的用户空间缓冲区。具体实现取决于读取方式和I/O栈。
这里不能简单理解成“磁盘把整个200GB模型一次性放进DDR”。
大型模型通常采用流式读取、分片加载、内存映射、异步预取或者其他方式控制内存占用。尤其当模型本身已经接近甚至超过服务器RAM容量时,把整个模型复制到内存再上传GPU显然不是一个合理方案。
CPU内存的作用也不只是“暂存”。
在模型加载过程中,CPU可能同时负责:
文件读取
数据解压
序列化格式解析
张量创建
dtype转换
量化/反量化
权重重排
内存分配
数据预取
因此,CPU本身也可能成为模型加载瓶颈。
例如一个权重文件采用压缩格式,NVMe很快地把数据读出来以后,CPU却需要大量时间解压,那么提高SSD速度并不会同比缩短启动时间。
mmap并不意味着模型直接进入显存
这是原稿中最需要纠正的地方之一。
内存映射,也就是memory mapping,可以让应用程序把文件映射到进程的虚拟地址空间。这样程序可以通过内存访问方式读取文件内容,而不需要传统意义上先把整个文件复制到一个巨大用户空间缓冲区。
但这里的“内存”指的是CPU侧的虚拟内存地址空间,并不是GPU显存。
例如某些框架或Safetensors加载方式可以利用memory mapping减少不必要的CPU侧复制,使权重能够更加高效地从文件进入CPU可访问内存,然后再执行:
文件
↓
CPU虚拟地址空间
↓
CPU可访问内存
↓
Host-to-Device传输
↓
GPU显存
所以:
mmap ≠ 磁盘直接映射到VRAM
GPU要参与计算,参数最终仍然必须位于GPU可访问的相应内存区域,除非程序采用了Unified Memory、CPU offload、按需分页或者其他特殊机制。
而且memory mapping并不要求“显存地址连续”。GPU内存分配和虚拟地址映射由CUDA运行时及GPU内存管理机制处理,并不是模型文件必须在物理显存中形成一块连续的巨大空间才能运行。
PCIe是CPU与GPU之间的重要数据通道
当权重位于CPU内存,而目标GPU使用独立显存时,需要经过Host-to-Device传输。
对于典型PCIe GPU,路径可以概括为:
CPU内存
↓
CPU内存控制器
↓
PCIe Root Complex
↓
PCIe链路
↓
GPU
↓
GPU显存
PCIe 4.0 x16每个方向的理论带宽约为16GB/s量级,实际应用吞吐会低于理论值。PCIe 5.0 x16则达到约32GB/s每方向的理论量级。
这里必须注意“每方向”。
PCIe是双向串行互联,把带宽简单写成一个数字很容易产生误解。GPU从主机读取数据和GPU向主机写数据属于不同方向,而实际程序还可能产生其他PCIe流量。
因此,一个200GB模型如果必须完整地从CPU内存传入GPU,PCIe本身就可能成为几十秒级的数据搬运限制因素。即使NVMe能够以10GB/s甚至更高速度读取文件,如果Host-to-Device路径只有十几GB/s量级,继续提高SSD读取速度也无法突破PCIe这一段。
PCIe延迟和带宽不是同一个概念
原稿把PCIe“约500ns”并与NVLink延迟直接比较,然后把它作为模型加载瓶颈,这种写法过于简单。
模型权重加载主要是大块数据传输,因此在很多场景中,吞吐比单次访问延迟更重要。
例如:
一次读取4KB
和:
连续读取4GB
对系统的要求完全不同。
前者更容易受到随机访问延迟影响,后者主要受到持续吞吐能力限制。
大模型权重通常是大量连续或相对连续的张量数据,因此在冷启动阶段,NVMe吞吐、CPU处理能力、Host-to-Device带宽和GPU内存写入能力往往比一个简单的“PCIe延迟数字”更有分析价值。
GPU显存带宽不是模型冷启动的唯一瓶颈
模型进入GPU以后,数据最终需要写入GPU显存。
这里要区分“PCIe传输带宽”和“显存带宽”。
例如NVIDIA A100使用HBM2e,而不是GDDR6,其显存带宽可以达到约1.5TB/s以上的级别。不同GPU架构的HBM或GDDR带宽差异很大。
但是,这并不意味着一个100GB模型一定可以在0.1秒左右完成加载。
因为模型数据首先必须到达GPU。假设Host-to-Device链路只能提供15GB/s左右,那么100GB数据单向传输的理论时间已经接近7秒。此时即使GPU内部显存拥有超过1TB/s的带宽,也不能把PCIe传输速度变成1TB/s。
这就是AI服务器中非常典型的“木桶效应”。
数据路径中最慢的关键阶段决定整体吞吐。
多GPU加载不是简单复制N次模型
当服务器拥有8张GPU时,情况更加复杂。
如果每张GPU都需要从CPU内存独立读取一份完整模型,那么服务器需要同时承受多条Host-to-Device数据流。
这时候可能出现:
NVMe → CPU内存
↓
PCIe Root Complex
↙ ↓ ↓ ↘
GPU0 GPU1 GPU2 ... GPU7
如果多个GPU共享相同PCIe Root Complex、PCIe Switch或者CPU socket,Host-to-Device带宽就可能产生竞争。
因此,“8张GPU就是8倍加载速度”显然不成立。
如果模型采用Tensor Parallel、Pipeline Parallel或者其他分片方式,每张GPU可能只需要加载整个模型的一部分参数,这时数据量本身发生变化,GPU之间还可能通过NVLink、NVSwitch或者PCIe进行后续通信。
NVLink的主要价值之一就是GPU-GPU之间的高速数据交换,而不是简单替代SSD到GPU的整个数据路径。
例如模型已经被分片到多个GPU,某些初始化或运行阶段需要GPU之间交换参数或激活,那么NVLink/NVSwitch就可能成为关键因素;但如果冷启动瓶颈发生在NVMe到CPU内存,那么增加GPU互联带宽不会自动解决存储问题。
模型加载不等于“把参数复制进去”
真正的模型启动通常还包含大量CPU和GPU端工作。
以一个深度学习框架加载checkpoint为例,大致会经历:
读取checkpoint
↓
解析文件格式
↓
确定tensor元数据
↓
创建目标tensor
↓
分配CPU/GPU内存
↓
读取权重
↓
必要时进行dtype转换
↓
Host-to-Device传输
↓
建立模型参数与模块的关联
↓
初始化运行时资源
↓
执行必要的warm-up
↓
进入推理或训练
如果模型使用FP32 checkpoint,而运行时需要BF16、FP16或者其他精度,加载过程中可能发生数据类型转换。
如果使用量化模型,还可能涉及量化格式解析、权重布局转换或者特定kernel要求的重排。
因此,“文件大小除以SSD速度”只能估计其中一部分时间。
训练和推理的加载方式并不完全一样
训练启动时,除了模型权重,还可能需要加载optimizer state、scheduler state以及checkpoint中的其他训练状态。
例如Adam类优化器通常需要额外的状态张量,因此一个看起来只有几十GB的模型checkpoint,实际恢复训练时可能需要处理远大于模型参数本身的数据。
而推理服务通常更加关注:
模型权重
Tokenizer
配置
量化参数
KV Cache相关配置
运行时kernel
并且推理服务器可能通过模型预加载,让GPU长期保持模型权重,避免每次请求重新加载。
这也是为什么生产环境通常不会采用“每来一个请求就从NVMe把模型重新复制到显存”的方式。
显存不足时,问题会发生根本变化
假设模型参数需要300GB显存,而单张GPU只有80GB。
这时候问题已经不是“怎样更快地把300GB复制进去”,而是“模型如何分布”。
可以使用多GPU模型并行,例如:
GPU0 → 一部分权重
GPU1 → 一部分权重
GPU2 → 一部分权重
GPU3 → 一部分权重
也可以使用CPU offload,让部分参数停留在主机内存,在执行相应计算时再搬入GPU。
还可以采用量化,使参数占用从FP16的约2字节/参数降低到更低的存储需求。
但这些方案都有代价。
模型分片会增加GPU之间的通信需求;CPU offload会受到CPU内存与GPU之间的数据传输限制;量化则可能影响计算精度、kernel效率和模型效果。
因此,“显存不够”并不是单纯增加软件层面的一个参数就能解决的问题,而是模型部署架构的问题。
为什么模型加载后还需要warm-up
模型权重进入显存以后,并不一定意味着第一次推理就能达到稳定性能。
CUDA运行时可能需要初始化上下文,框架可能需要选择或准备kernel,某些实现还会进行kernel编译、图捕获、内存池建立或者其他运行时初始化。
因此生产环境经常会在模型加载完成后主动发送若干warm-up请求。
这样做的目的不是“让显存变快”,而是让运行时完成必要的初始化,使正式请求避免承担首次执行的额外成本。
所以用户看到:
模型已经加载完成
并不一定意味着:
服务已经达到稳定吞吐
这两个时间点应该分开测量。
真正应该怎样测量模型加载瓶颈
专业环境中,不应该只看“模型启动用了多少秒”,而应该把整个过程拆成时间段。
例如记录:
T1:文件系统开始读取
T2:CPU收到主要权重数据
T3:权重解析完成
T4:Host-to-Device传输开始
T5:主要权重进入GPU显存
T6:模型初始化完成
T7:warm-up完成
T8:服务进入稳定状态
同时记录:
NVMe读取吞吐
CPU利用率
CPU内存带宽
主机RAM占用
PCIe吞吐
GPU显存占用
GPU HBM/GDDR活动
GPU功耗
GPU利用率
GPU间NVLink/NVSwitch流量
这样才能判断到底是哪一段限制了启动速度。
如果NVMe已经接近满吞吐,而PCIe利用率不高,应该调查存储。
如果NVMe很快,但CPU长期满载,则可能是解压、反序列化、dtype转换或其他CPU处理成为瓶颈。
如果CPU和SSD都很空闲,而PCIe Host-to-Device吞吐已经接近上限,则应该调查PCIe拓扑和GPU连接方式。
如果模型已经进入GPU但初始化仍然耗时,则需要进一步调查框架、CUDA runtime、kernel编译和warm-up。
多GPU服务器还要检查PCIe拓扑
在专业AI服务器中,“GPU有PCIe 5.0 x16”并不代表每张GPU永远都能够独占完整的PCIe带宽。
需要查看实际拓扑。
例如某些服务器可能采用:
CPU Socket 0
├── PCIe Root
│ ├── GPU0
│ ├── GPU1
│ └── NVMe
│
CPU Socket 1
├── PCIe Root
│ ├── GPU2
│ ├── GPU3
│ └── NVMe
NUMA结构、PCIe Root Complex、PCIe Switch以及GPU之间的互联方式都会影响数据路径。
在Linux环境下,可以使用:
lspci -tv
查看PCIe拓扑,也可以结合:
nvidia-smi topo -m
查看NVIDIA GPU之间以及GPU与CPU/NUMA节点之间的拓扑关系。
如果发现某几张GPU共享相同的PCIe资源,那么多GPU并行加载时出现吞吐下降并不奇怪。
优化模型加载不能只盯着SSD
如果目标是降低冷启动时间,优化顺序应该从完整数据路径出发。
第一层是减少需要搬运的数据量,例如使用合理的数据类型、量化以及适当的checkpoint格式。
第二层是提高存储端持续吞吐,例如使用更高性能NVMe、多个设备并行读取或者适合AI工作负载的分布式存储。
第三层是减少CPU侧无意义的数据复制,通过memory mapping、合理的buffer管理和异步I/O减少额外搬运。
第四层是提高Host-to-Device传输效率,包括检查PCIe链路宽度、链路速率、NUMA亲和性以及多GPU拓扑。
第五层是优化GPU端初始化,包括合理的显存分配、kernel准备和warm-up。
如果生产服务允许,最有效的方法往往不是继续优化“冷启动”,而是直接让模型常驻GPU。模型启动一次以后持续提供服务,后续请求就不再承担数百GB权重的重复搬运成本。
一个更准确的模型加载公式
对于一个简单的单GPU冷启动,可以把总时间粗略理解为:
总加载时间
≈ 存储读取时间
+ CPU解析/转换时间
+ Host-to-Device传输时间
+ GPU初始化时间
+ warm-up时间
其中不同阶段并不一定严格串行。
高性能系统会使用异步I/O、预取、pipeline和多线程,把多个阶段重叠起来。因此实际工程中的总时间不能简单把每一项机械相加。
而对于大模型,数据量、并行度和拓扑才是关键变量。
假设100GB权重需要从CPU内存进入GPU,PCIe有效吞吐只有约15GB/s,那么单纯这段数据搬运就需要数秒级时间。此时把SSD从5GB/s升级到10GB/s并不一定让整体加载时间减半,因为新的瓶颈可能已经转移到了PCIe。
这就是性能工程中非常重要的原则:不要优化已经不是瓶颈的那一段。
AI模型从磁盘进入GPU,本质上是一条完整的数据供应链,而不是某一个“加载函数”完成的动作。文件系统负责提供字节,CPU和操作系统负责读取、缓存和处理,主机内存承担中间数据通道,PCIe负责Host-to-Device传输,GPU内存系统负责保存最终权重,CUDA或ROCm负责设备运行时管理,PyTorch、TensorFlow以及其他框架则负责把这些资源组织成可以执行的模型。
当模型规模从几十GB进入数百GB甚至TB级以后,任何一个环节都可能成为瓶颈。NVMe很快,不代表GPU加载就快;GPU显存带宽达到TB/s级,也不代表模型可以通过PCIe以TB/s速度进入显存;8张GPU也不意味着模型加载速度自动变成8倍。只有把存储吞吐、CPU处理、RAM、PCIe拓扑、GPU显存、GPU互联和框架初始化放在同一条数据路径上测量,才能知道启动时间究竟消耗在哪里。
对于AI服务器工程,模型加载优化最终不是简单地“换更快的SSD”或者“增加GPU”,而是让数据以尽可能少的复制、尽可能高的并行度,从存储端持续供应到计算端,并让存储、CPU、PCIe、GPU显存和GPU互联之间的吞吐能力尽量匹配。模型一旦进入稳定运行阶段,还要进一步把问题从“如何加载得快”转向“如何让权重、激活、KV Cache和训练数据持续以足够速度供应计算单元”。这时,模型加载只是AI数据路径中最先暴露出来的一个瓶颈,而不是整个性能问题的终点。
AI 模型加载到 GPU 的过程是怎样的,从磁盘文件到显存完整解释
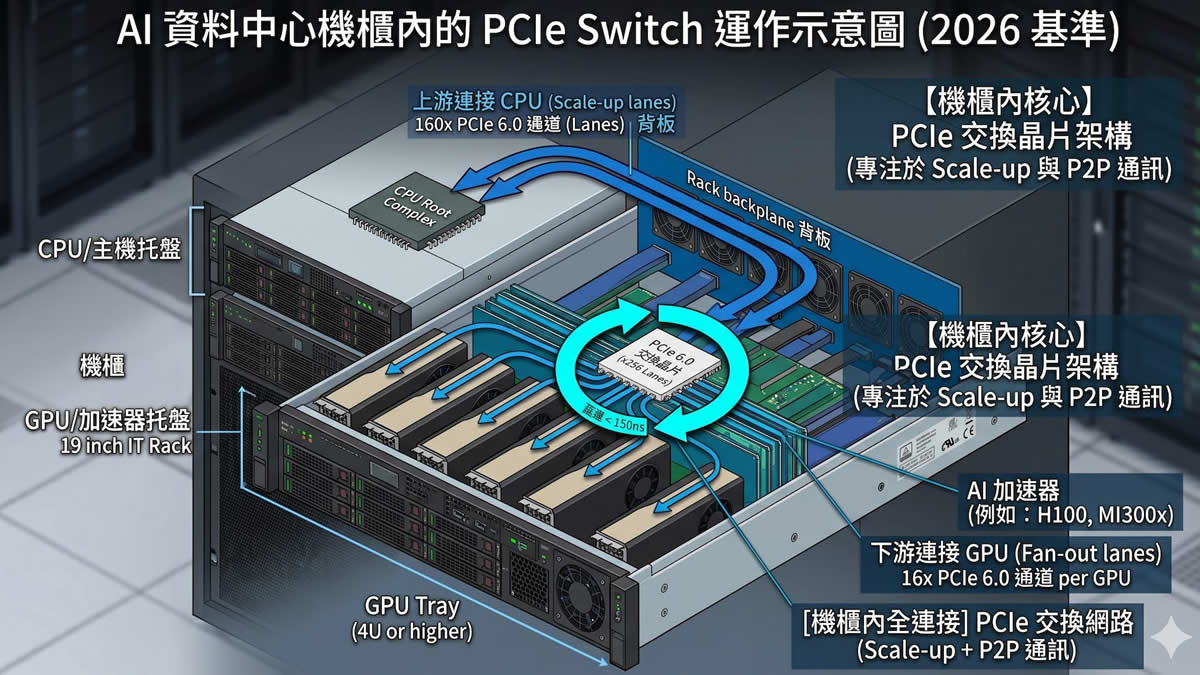
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP