
当一个AI模型只有几百MB或者几GB时,模型加载往往只是一个普通的文件读取问题。但当模型进入几十GB、数百GB甚至更大规模以后,情况就完全不同了。此时决定加载速度的已经不只是SSD或者网络存储的顺序读取速度,而是模型文件格式、文件数量、文件系统、CPU内存、GPU显存、PCIe拓扑、GPU之间的互连以及数据预取策略共同形成的一条完整数据通路。
这也是为什么大模型工程中会出现专门的checkpoint格式、分片管理、缓存和并行加载机制。模型权重本身通常是大量张量组成的数据集合,如果简单地把整个模型当成一个普通文件处理,存储系统很容易成为GPU计算资源启动之前的等待环节。
一个典型的大模型加载过程,大致需要经历“存储介质到主机内存,再到GPU显存”的数据移动。在某些分布式环境中,还可能涉及远程文件系统、网络接口以及GPU之间的数据交换。因此,优化模型加载的核心并不是单纯购买更快的SSD,而是减少不必要的数据复制,并让不同阶段尽可能并行运行。
模型文件格式就是其中一个容易被忽略的因素。传统的序列化方式可能需要较多的反序列化处理,而面向机器学习权重设计的格式可以把张量元数据和实际数据组织得更加适合读取。例如,Safetensors采用简单的元数据加原始张量数据结构,并支持零拷贝和延迟加载机制,可以减少不必要的数据复制,同时避免传统pickle反序列化可能带来的任意代码执行风险。
模型分片也是大型模型加载的重要环节。模型并不一定以一个巨大的文件存在,而可能被拆成多个权重文件,以便不同设备或者不同进程分别读取。这样做可以支持并行加载和分布式部署,但文件数量增加以后,文件系统元数据、打开文件的操作、目录查询以及远程存储的网络往返次数都可能进入性能关键路径。
不过,不能简单认为“超过1000个分片,传统文件系统就一定失效”。实际性能取决于文件大小、文件系统、存储设备、并发度、元数据服务以及模型加载程序的访问方式。大量小文件确实可能比少量大文件带来更多元数据和请求开销,但不存在适用于所有系统的统一分片数量临界值。
另一个经常被误解的问题是GPU显存碎片。模型加载时确实可能发生显存分配、释放以及临时缓冲区管理,但不能把它简单解释成“模型分片大小与GPU物理显存块不匹配,因此产生20%以上损耗”。现代GPU内存管理由驱动和运行时负责,实际问题更多来自多个张量分配、临时工作区、不同生命周期的缓冲区以及框架自身的内存分配策略。是否出现明显碎片,需要结合具体框架、分配器和加载方式进行测量,而不是根据参数量直接推算一个固定百分比。
数据搬运路径则更加复杂。GPU显存的带宽远高于普通存储设备,因此如果大量模型数据必须在CPU内存、存储和GPU之间反复复制,GPU可能需要等待数据到达。现代GPU服务器通过PCIe、NVLink和NVSwitch等互连技术缩短不同设备之间的数据交换路径,但这些技术承担的职责并不相同。
NVLink主要用于GPU之间的高速互连,而不是SSD读取模型文件的替代接口。以H100为例,第四代NVLink提供900 GB/s的GPU间互连带宽;NVIDIA目前不同代际产品的NVLink带宽还会进一步提高。因此,讨论NVLink时必须明确GPU型号、互连代际以及带宽口径。
真正与模型文件加载直接相关的,则是存储到GPU的数据通路。NVIDIA的GPUDirect Storage可以让支持的存储系统通过DMA直接把数据传输到GPU内存,减少经过CPU系统内存的额外复制,从而降低CPU负担并改善数据移动效率。
这并不意味着CPU从整个I/O过程中消失。GPUDirect Storage仍然需要软件发起和管理I/O请求,而且最终性能还受到PCIe拓扑、GPU与存储控制器的位置、网络接口以及文件系统等因素影响。NVIDIA自己的文档也特别强调,GPU、NIC、存储设备以及PCIe交换结构之间的拓扑关系会影响最终吞吐和延迟。
对于分布式模型,GPUDirect RDMA解决的是另一类数据移动问题。它允许兼容的网络设备直接访问GPU内存,减少通过CPU主机内存进行中间复制的需要。因此,在多节点训练或者推理环境中,网络通信、GPU之间的数据交换和存储I/O应该分别分析,不能把它们统称为“模型加载经过网络协议栈和内存映射”。
预取策略也是模型加载效率的重要组成部分。加载程序可以在GPU使用当前权重的同时提前读取后续数据,让I/O和计算重叠。如果预取太少,GPU可能因为下一批数据没有准备好而等待;如果预取过多,则会占用CPU内存、GPU显存或者缓存资源。
因此,预取窗口不存在一个适用于所有Transformer模型的固定最佳值。它受到权重分片大小、存储延迟、并发读取能力、网络带宽、GPU显存容量以及实际计算时间影响。最合理的做法不是给预取窗口规定一个固定数字,而是通过实际profiling观察I/O等待、GPU利用率和内存占用,然后调整并发读取和缓存策略。
大型模型加载还涉及一个容易被忽视的问题,就是“存储速度”和“有效加载速度”并不是同一个概念。SSD标称的顺序读取速度只是存储设备在特定测试条件下的峰值性能。如果模型由大量小块组成,或者存储系统需要处理大量并发请求和元数据操作,最终应用程序看到的有效吞吐可能明显低于设备规格。
远程存储的情况更加复杂。此时除了存储设备本身,还要考虑网络带宽、网络延迟、文件系统客户端、服务器端存储以及并发访问。如果大量GPU节点同时启动并读取同一个大型模型,瓶颈甚至可能从单块SSD转移到网络或者存储服务器。
因此,大模型的存储优化实际上是在优化一条完整的数据流水线,而不是单独优化某一个硬件。
比较合理的工程思路通常是先确定模型加载过程中究竟卡在哪里。如果GPU等待的是存储,就应该检查存储吞吐和延迟;如果CPU内存成为中间缓冲区瓶颈,就要考虑减少复制或者采用更合适的数据通路;如果多GPU之间存在大量权重交换,就应该检查GPU互连和拓扑;如果多节点同时启动造成网络拥堵,则需要从分布式文件系统、缓存以及节点间流量进行分析。
缓存也因此具有重要作用。对于频繁启动相同模型的推理服务,可以把热点模型权重保留在本地高速存储甚至内存中,避免每次启动都从远程存储重新读取。对于大型集群,则可以进一步考虑节点级缓存、分层存储和预热机制,把模型冷数据与频繁使用的数据分开处理。
这也解释了为什么现代AI基础设施越来越强调“数据路径”而不只是“计算能力”。GPU计算能力增长以后,如果模型加载、数据读取和设备间通信无法同步提高,昂贵的GPU就可能在等待数据。
对于模型部署,最终目标也不是追求某个固定的“加载速度提升40%”或者“性能提升60%”。不同模型、硬件、文件格式和存储架构之间的差异非常大。更可靠的方法,是通过端到端测试确定瓶颈,然后针对存储、文件格式、缓存、预取、PCIe拓扑和GPU互连逐层优化。
大模型时代的存储管理因此已经从传统的“把文件保存好”变成了计算基础设施的一部分。模型权重在哪里保存、如何切分、如何读取、经过哪些数据通路、什么时候进入GPU显存,以及多个GPU和节点怎样协同使用这些数据,都会影响最终的启动时间和计算资源利用率。模型规模越大,存储系统与计算系统之间的边界就越模糊,模型加载也越需要从整个数据流的角度进行设计,而不是单纯把问题归结为硬盘读写速度。
AI 模型文件为什么需要专门的存储管理,大模型加载过程有哪些隐藏的性能问题
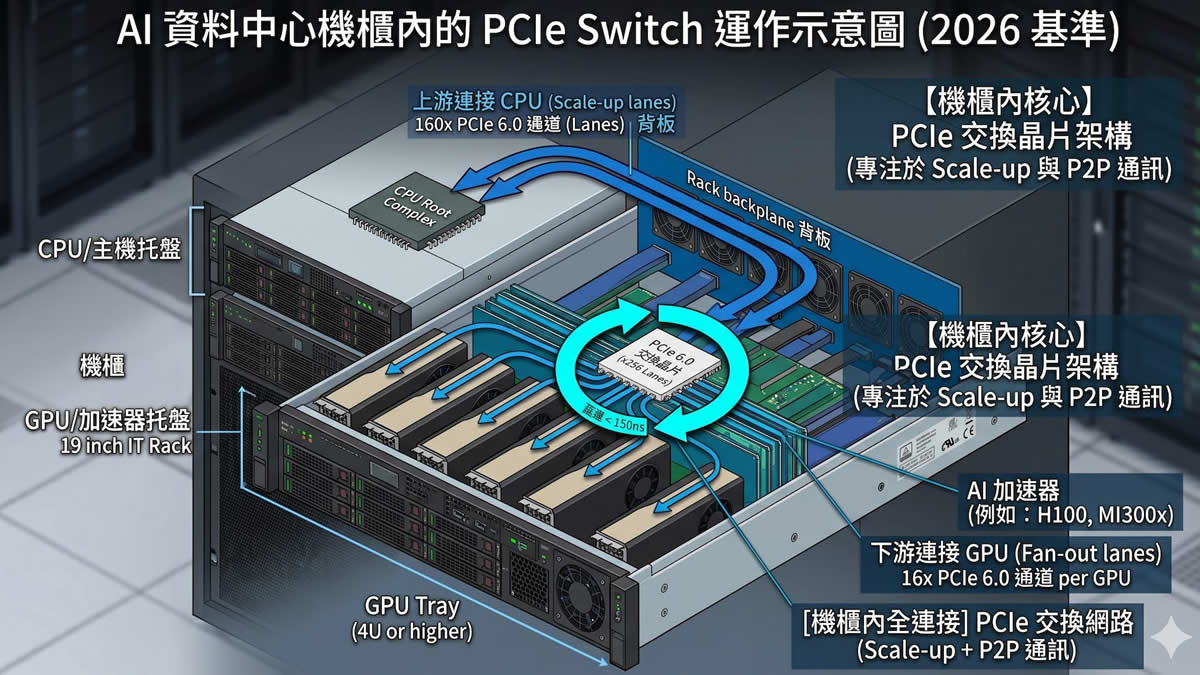
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP