
随着人工智能模型不断扩大,训练大模型已经从“单卡算力竞赛”逐渐进入“计算、显存与通信协同”的系统竞争阶段。很多人容易产生一个直觉:既然新一代GPU的计算能力越来越强,那么增加GPU之后,训练速度应该可以近乎线性提升。
实际情况却远没有这么简单。
当GPU本身越来越快,计算环节所需要的时间不断缩短,GPU之间交换数据所花费的时间就会越来越突出。换句话说,过去限制训练速度的可能是“算得不够快”,而今天越来越多的场景开始变成“算完以后等数据”。
这正是多GPU训练中通信开销不断受到关注的根本原因。
GPU不是各算各的,训练过程中必须不断交换数据
在最常见的数据并行训练模式中,每张GPU负责不同的数据批次,但运行的是同一个模型。每张GPU完成前向和反向计算后,都需要把梯度进行同步,使所有GPU上的模型参数保持一致。
PyTorch的DistributedDataParallel就是典型例子。不同GPU分别计算自己的梯度,然后通过集体通信操作进行梯度同步,其中AllReduce是核心机制之一。
这意味着,多GPU训练并不是简单地把一个任务拆成八份、十六份甚至几百份,然后让GPU各自独立工作。GPU之间必须不断“交流”。
如果计算速度很慢,这部分通信时间可能并不明显。例如GPU计算一次需要100毫秒,而通信需要10毫秒,通信只占整个过程的一小部分。
但是,如果新一代GPU把计算时间从100毫秒降低到20毫秒,而通信仍然需要10毫秒,那么通信的相对影响就会迅速扩大。
这就是所谓的“通信墙”。
GPU越快,等待数据的问题越明显
假设有一个简单的训练任务。
一张GPU完成计算需要20毫秒,数据同步需要5毫秒,那么一次训练步骤大约需要25毫秒。
如果换成性能更强的GPU,计算时间降低到10毫秒,而通信时间仍然是5毫秒,那么整个训练步骤变成15毫秒。
GPU计算能力提高了一倍,但整个任务只提高了约67%的速度。
如果计算进一步降低到5毫秒,而通信仍然需要5毫秒,那么理论上的计算能力又提高了一倍,实际训练速度却只能从15毫秒降低到10毫秒。
这就是为什么GPU性能提升到一定程度以后,继续堆算力并不意味着训练效率能够同步提升。
问题已经从“计算能力不足”转向了“计算和通信是否匹配”。
AllReduce为什么会成为重要瓶颈
在数据并行训练中,梯度同步是最典型的通信负担。
假设模型有数百亿甚至更多参数,每一次反向传播都会产生规模巨大的梯度数据。不同GPU完成计算之后,需要通过AllReduce等集体通信机制进行聚合。
PyTorch的分布式系统提供AllReduce、AllGather、Broadcast、Reduce等多种通信操作,而DDP还会把梯度组织成多个bucket,以便在反向传播过程中尽可能让通信与计算重叠,从而减少等待时间。
这说明一个非常重要的问题:大模型训练的性能已经不仅取决于GPU本身,还取决于GPU之间的数据交换效率。
当GPU数量从2张增加到8张、32张甚至数百张以后,通信拓扑、网络带宽、延迟以及通信算法都会直接影响最终的训练效率。
因此,真正的大规模AI训练集群,本质上已经不是简单的“GPU集合”,而是一台由GPU、内存、交换芯片、高速网络和软件系统共同组成的超级计算机。
为什么PCIe往往不够用了
普通PC中的GPU通常通过PCIe与CPU和其他设备通信。PCIe本身已经拥有很高的带宽,但对于大型AI训练,GPU之间需要交换的数据规模实在太大。
因此,高性能AI服务器会采用专门的GPU互联技术。
以NVIDIA的NVLink为例,Hopper架构的第四代NVLink可以提供每GPU最高900GB/s的双向带宽,NVIDIA也明确将其定位为大规模多GPU和AI模型通信的重要基础设施。
这背后的逻辑非常简单:GPU计算速度已经快到不能再依赖传统低速互联方式。
如果GPU每秒能够完成海量计算,却必须通过相对缓慢的通道等待数据,那么昂贵的GPU就可能处于等待状态。
从这个角度看,NVLink、NVSwitch以及高速网络并不是GPU的“附属设备”,而是现代AI计算系统的重要组成部分。
单机通信和跨服务器通信又是两个问题
多GPU训练还需要区分两种情况。
第一种是在同一台服务器内部使用多张GPU。这种情况下,可以通过NVLink、NVSwitch等高速互联技术减少GPU之间的数据交换成本。
第二种则是跨服务器训练。例如一个AI集群拥有几十台甚至数百台服务器,每台服务器安装多张GPU。
此时GPU之间的数据交换需要经过服务器之间的高速网络,通信问题会更加复杂。网络延迟、交换机性能、拥塞、拓扑结构以及通信库都会影响训练效率。
这也是为什么大型AI数据中心不能只购买大量GPU。
如果GPU服务器之间的网络没有同步升级,就可能出现一种非常昂贵的现象:GPU已经准备好计算,却在等待其他GPU的数据。
通信并不只有梯度同步
把多GPU通信简单理解成“传梯度”也不完全准确。
不同的并行方式会产生不同的数据交换需求。
数据并行主要涉及梯度同步;模型并行则需要不同GPU之间交换模型计算过程中产生的中间数据;张量并行需要多个GPU共同完成一个计算任务,因此通信更加频繁;大模型训练还可能采用流水线并行、参数分片等方式。
现代PyTorch已经支持包括DDP、FSDP2、Tensor Parallel等多种分布式训练方式,实际系统往往会根据模型规模和硬件架构组合使用不同的并行策略。
因此,模型越大,并不意味着简单增加GPU数量就一定能够获得同等比例的性能提升。
真正困难的是如何让这些GPU高效协同。
“GPU利用率低”有时候并不是GPU不够强
在AI训练集群中,一个非常值得关注的指标就是GPU利用率。
如果GPU利用率长期偏低,很多人第一反应可能是GPU性能不足。
实际上,情况可能恰恰相反。
GPU可能已经足够强,但因为通信系统跟不上,GPU在等待数据同步。此时GPU没有真正进行有效计算,而是在等待其他设备完成工作。
这也是为什么大型AI集群的性能分析不能只看GPU的理论TOPS或FLOPS,而必须同时观察显存带宽、网络吞吐、通信延迟、AllReduce耗时以及计算与通信重叠程度。
PyTorch的通信优化机制本身就强调通过gradient bucket等方式,把通信与反向计算尽可能重叠起来,以减少GPU等待。
解决通信瓶颈,不能只靠增加带宽
提高网络带宽当然是最直接的方法,但并不是唯一办法。
一种方法是采用更高速的GPU互联,例如NVLink和NVSwitch。
另一种方法是优化AllReduce等通信算法,减少不必要的数据传输。
第三种方法是进行通信与计算重叠,让GPU在等待某部分数据传输的同时继续执行其他计算。
第四种方法是采用梯度压缩、参数分片以及更加合理的并行策略,降低实际需要交换的数据量。
例如PyTorch已经提供FP16、BF16等通信压缩机制,通过降低通信数据精度来减少需要传输的数据规模。
因此,真正高效的AI训练系统追求的并不是单纯的“最快GPU”,而是让计算、显存和通信形成平衡。
AI算力竞争正在从GPU数量转向系统效率
过去几年,人工智能行业非常喜欢用“拥有多少张GPU”衡量一家公司的AI实力。
这种指标当然重要,但已经越来越不完整。
一座拥有1万张GPU、却存在严重通信瓶颈的数据中心,并不一定比拥有5000张GPU但通信效率更高的系统训练得更快。
这也是AI基础设施竞争正在发生变化的原因。
未来的大模型训练,不仅是GPU芯片之间的竞争,也是高速互联、网络交换、内存体系、通信算法、编译器和分布式训练软件之间的综合竞争。
GPU负责计算,网络负责让计算资源真正形成一个整体。当单张GPU越来越快之后,决定整个集群效率的,往往不再是“GPU能算多快”,而是“GPU之间能多快地交换数据”。
这也解释了一个看似反直觉的现象:GPU越强,网络的重要性反而越高。
因为当计算越来越便宜、越来越快之后,等待就会变得越来越昂贵。
而这,正是下一阶段AI基础设施竞争真正需要解决的问题。
多 GPU 训练中的通信开销从哪里产生,计算速度提升后为什么网络反而可能成为瓶颈
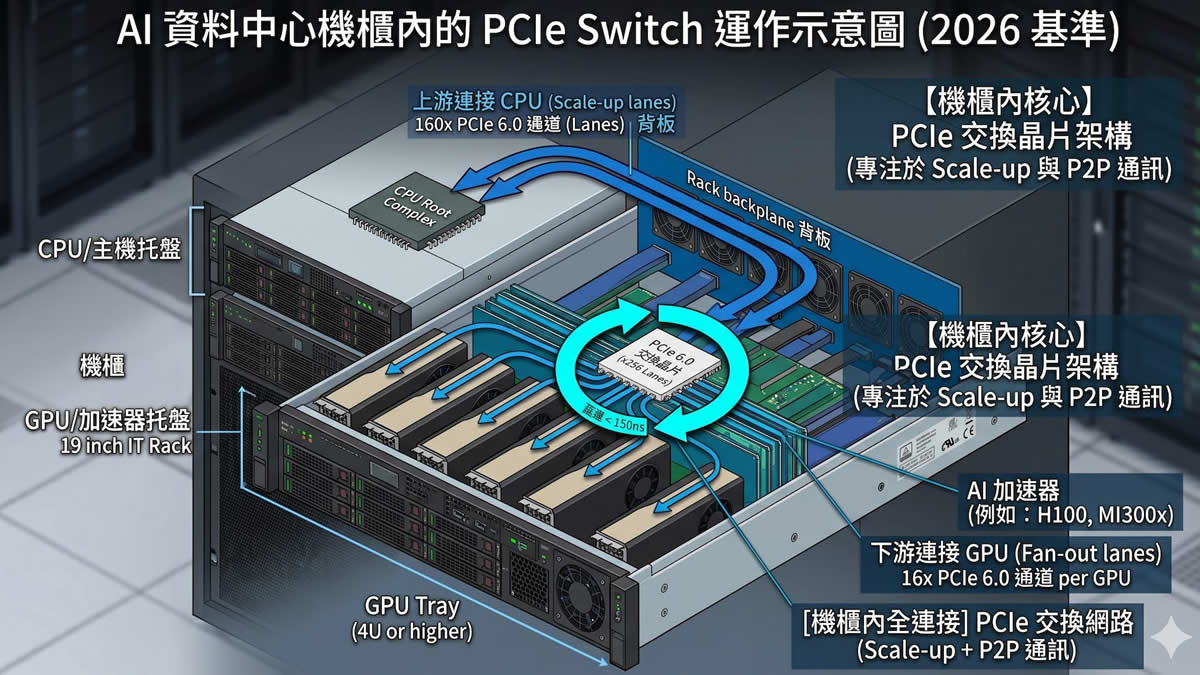
图片说明:示意图 图片来源:Public Domain(公有领域)

喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal):
https://www.paypal.me/observeccp
订阅中国观察电报 Telegram:
https://t.me/s/ObserveCCP