
在AI服务器监控面板上,GPU利用率往往是最醒目的数字。看到一台GPU长期保持90%以上,很多人第一反应就是“这台机器跑得不错”。但对于AI训练和推理系统来说,GPU利用率高只能说明GPU上的某些计算单元或相关工作较为繁忙,并不能直接证明整个系统性能优秀。一个数据预处理严重堵塞、CPU供不上数据、显存频繁搬运、PCIe成为瓶颈或者分布式通信效率很差的系统,同样可能出现很高的GPU利用率。
真正的性能判断应该从“GPU忙不忙”转向“单位时间到底完成了多少有效工作”。对于AI推理服务,首先要看吞吐量,也就是单位时间完成多少请求、多少token或者多少图像。大语言模型通常需要同时观察 tokens/s、requests/s,以及输入和输出token长度。单纯比较QPS很容易产生误导,因为一个请求可能只生成几个token,也可能生成数千个token。对于LLM,服务端更有意义的指标包括每秒生成token数、每个请求的Time to First Token,也就是TTFT,以及后续token之间的生成间隔,也就是Inter-Token Latency。
延迟也不能只看平均值。平均延迟经常会把少数严重变慢的请求隐藏掉,因此生产系统通常需要观察P50、P90、P95、P99甚至更高分位数。P50可以帮助了解典型请求速度,而P99更接近高并发情况下最差的一小部分用户体验。如果GPU利用率从70%提高到95%,吞吐量却几乎没有增加,同时P99延迟明显上升,那么系统很可能已经接近某个资源瓶颈。此时继续追求更高的GPU利用率,反而可能降低服务质量。
第二个关键指标是GPU真正执行的是什么。GPU利用率本身并不等同于Tensor Core利用率,也不等同于FP32、FP16、BF16或FP8计算吞吐。现代AI GPU中,计算核心、Tensor Core、显存控制器、L2 Cache以及不同类型的数据通路都有自己的性能特征。一个模型可能让GPU始终处于忙碌状态,却主要是在等待显存数据,而不是充分利用Tensor Core。因此,使用NVIDIA Nsight Systems、Nsight Compute以及DCGM等工具时,需要进一步观察SM occupancy、Tensor Core activity、内存吞吐、Kernel执行时间和Kernel launch间隔。
显存带宽尤其容易成为推理系统的瓶颈。某些模型的计算量并没有达到GPU算力极限,但模型权重和中间数据需要不断从HBM读取。如果显存带宽已经接近硬件上限,即使GPU利用率看起来很高,也很难通过简单增加计算线程获得明显性能提升。这类系统优化方向可能是降低数据搬运、改善kernel融合、优化batch、使用更合适的量化格式,或者选择具有更高内存带宽的GPU,而不是单纯增加GPU数量。
显存容量同样重要。模型能不能放进显存、KV Cache能够容纳多少token、batch size能做到多大,都会影响实际吞吐量。尤其是LLM推理,随着上下文长度和并发请求增加,KV Cache会占用越来越多显存。如果显存压力导致频繁的数据迁移、batch size受到限制,最终表现出来的可能就是GPU利用率很高,但每美元、每瓦特能够完成的有效token数量并不理想。
CPU和数据预处理也经常制造“GPU很忙但系统很慢”的情况。图像推理需要解码、缩放和预处理,语音系统需要音频解码和特征提取,LLM服务则涉及tokenization、请求调度、KV Cache管理以及网络数据处理。如果这些工作占用了大量CPU时间,GPU端可能出现kernel之间断续执行、数据等待或者批次大小不稳定。此时需要同时观察CPU利用率、CPU单核瓶颈、内存带宽、NUMA拓扑以及PCIe传输,而不能只盯着GPU百分比。
分布式AI系统还必须观察GPU之间的通信。多GPU服务器中,PCIe、NVLink或NVSwitch的拓扑直接影响数据交换效率;跨服务器训练和推理则进一步依赖InfiniBand或高速以太网。当All-Reduce、All-to-All等通信操作占据大量时间时,每张GPU可能都有很高的利用率,但整个集群的扩展效率却很差。增加GPU之后,如果八张卡的性能没有接近单卡性能的八倍,就应该进一步检查通信、同步、负载均衡以及并行策略。
功耗和温度也不能被忽略。GPU达到高利用率时通常意味着更高功耗,但真正需要关注的是单位功耗完成多少有效工作。例如两个系统都能够达到相同的tokens/s,其中一个持续运行在更高功耗和更高温度下,那么从数据中心运营角度看,它未必更有效率。服务器还需要观察GPU温度、功耗、时钟频率、功率限制以及是否发生thermal throttling。如果GPU因为散热、供电或功耗墙而降频,监控中的“利用率”仍然可能非常漂亮。
最后才是成本指标。AI基础设施真正关心的不是GPU利用率能不能从80%变成95%,而是每秒完成多少有效任务,以及每个任务需要多少GPU时间、多少电力和多少基础设施成本。推理服务可以计算cost per million tokens、每千次请求的GPU成本,视觉系统可以计算每百万张图像的GPU成本,训练系统则可以关注达到目标模型质量所需要的总GPU小时数。
所以,GPU利用率应该被看成一块仪表盘,而不是成绩单。真正有意义的监控体系至少应该把GPU利用率、Tensor Core使用率、显存容量与带宽、功耗和温度、CPU与内存、PCIe或NVLink通信、网络、吞吐量、P50/P95/P99延迟以及单位任务成本放在一起观察。对于LLM,还应该加入TTFT、Inter-Token Latency、tokens/s和KV Cache等指标。
一台GPU长期跑在95%,并不自动意味着它已经发挥出了全部价值;同样,一台GPU只有70%的利用率,也不一定代表它运行得差。如果70%的GPU利用率已经满足业务延迟目标,并且单位token成本更低,那么继续把利用率硬推到95%可能没有意义。AI基础设施优化的最终目标从来不是让监控面板上的某一个数字尽可能漂亮,而是让计算、内存、通信、软件调度和业务负载形成合理匹配,在满足延迟和可靠性要求的同时,用尽可能少的GPU资源完成尽可能多的有效工作。
GPU 利用率很高是否意味着 AI 系统性能很好,还有哪些指标必须同时观察
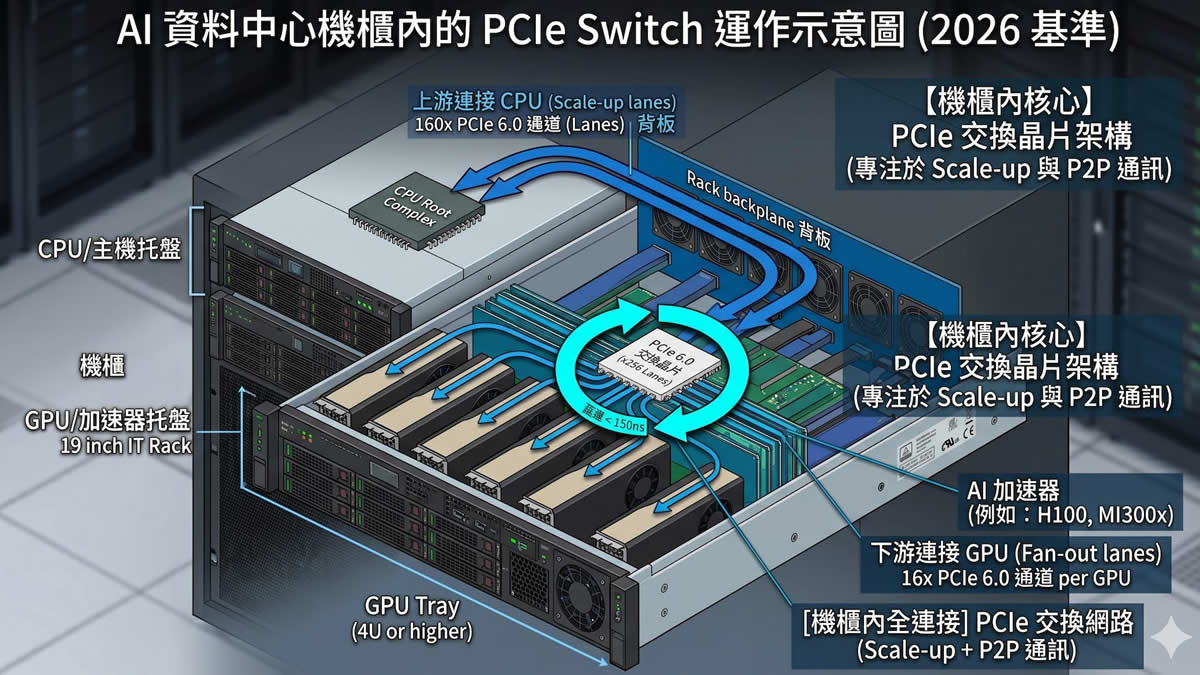
图片说明:示意图 图片来源:Public Domain(公有领域)

喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal):
https://www.paypal.me/observeccp
订阅中国观察电报 Telegram:
https://t.me/s/ObserveCCP