
GPU服务器为什么需要高功率供电?从GPU芯片一直看到数据中心电力系统
AI服务器与普通服务器最大的区别之一,就是计算芯片的功耗密度正在快速提高。传统服务器可能主要依靠CPU完成计算任务,而AI服务器往往同时安装多块高性能GPU,再配合高速内存、高速网络和大容量NVMe存储设备。单个节点的功耗因此从几百瓦迅速上升到数千瓦,面向大规模AI训练的整机甚至可能达到更高水平。
但GPU服务器需要高功率电力,并不意味着“GPU功耗加起来”这么简单。真正决定服务器供电需求的,是芯片功耗、供电转换效率、CPU与内存、网络设备、存储设备、散热系统以及电源冗余共同形成的整机功耗。
GPU本身是最大的功耗来源
现代GPU拥有数量庞大的晶体管和高度并行的计算单元。进行AI训练时,大量矩阵运算和向量运算会让计算单元长时间保持高负载,因此GPU成为整台AI服务器最主要的耗电设备。
不同GPU的功耗也不能简单用一个数字概括。例如,NVIDIA A100存在PCIe和SXM等不同形态,功耗规格并不完全相同;H100同样存在不同版本,部分数据中心版本的设计功耗明显高于A100。因此,在计算服务器总功耗时,不能只写一个“某型号GPU功耗”,而应该按照具体GPU型号、板卡形态和服务器设计规格进行计算。
尤其需要注意,TDP、TGP以及实际运行功耗并不是完全相同的概念。GPU在轻负载、推理和满负载训练状态下的实际耗电量都会发生变化。服务器电源的设计功率还必须为瞬时负载变化、其他组件以及安全余量预留空间。
GPU功耗为什么会越来越高
GPU功耗不断提高,与AI计算的发展方向密切相关。
现代AI模型需要处理越来越大的矩阵和张量。为了提高训练吞吐量,GPU厂商不断增加计算单元、提高时钟频率,并引入Tensor Core等专用计算硬件。同时,HBM等高带宽显存技术让GPU能够以极高速度读取和写入数据。
问题在于,计算能力提高之后,数据搬运同样需要付出能源成本。
GPU不仅需要给计算核心供电,还需要给显存、缓存、片上互联以及其他电路供电。特别是在大型模型训练中,计算核心和高带宽显存长期处于高负载状态,因此整块GPU的功耗可能长期维持在较高水平。
这里不能简单地用“显存容量乘以每GB功耗”来计算GPU功耗。显存的功耗受到芯片类型、数据访问频率、工作电压和运行状态等多个因素影响,GPU整板功耗也包含计算核心、显存以及其他电路部分。
从低电压芯片到服务器电源
GPU核心实际上并不是直接使用服务器电源提供的12V电压运行。
服务器电源系统首先将输入的交流电转换成服务器内部使用的直流电压,然后通过主板或GPU板卡上的电源转换电路,将电压进一步降低到GPU核心、显存等芯片所需要的工作电压。
这也是为什么GPU服务器需要非常强大的VRM,也就是电压调节模块。
GPU核心工作电压通常远低于12V,因此电源转换器必须在极高电流下保持稳定。GPU功耗越高,低电压侧所需要的电流就越大。例如一个假设功耗为700W、核心电压约1V的计算负载,其对应电流规模可以达到数百安培。实际GPU会通过多相供电等方式分散电流,从而降低单个供电通道的压力。
因此,高功率GPU服务器真正困难的地方并不是简单地“找一个更大的电源”,而是要让整个供电链条在高电流、高负载和快速负载变化条件下保持稳定。
服务器电源也不是简单的多路12V并联
一些早期服务器和资料容易把GPU服务器描述成“多路12V电源简单并联”。这种说法过于简单。
现代数据中心服务器通常采用高效率服务器电源模块,并根据具体平台设计配电和电源冗余方案。不同服务器可能采用不同的输入方式、电源模块数量和冗余等级。
例如常见的冗余设计会采用N+1或者其他形式,让服务器在一个电源模块发生故障时仍能够继续运行。对于关键AI训练节点,这种设计尤其重要,因为一次电源故障可能导致长时间运行的训练任务中断。
而且,服务器的额定电源功率也不能按照GPU数量简单相加。例如8张高功耗GPU并不意味着电源只需要“8×GPU功耗”。CPU、内存、主板、网络卡、SSD、风扇以及电源转换损耗都需要计算进去,同时还必须留出合理的峰值和冗余空间。
散热其实是高功率服务器的另一半电力问题
电能最终绝大部分都会转化成热量。
一台GPU服务器如果持续消耗5kW电力,那么从数据中心热管理的角度看,就需要持续处理接近5kW的热负荷。服务器功率越高,散热系统面临的压力也越大。
这也是为什么高密度AI服务器正在推动液冷技术的发展。
传统风冷依靠高速风扇和机房冷空气带走热量。当单机柜功率不断提高以后,仅靠增加风扇并不能无限制地解决问题。风扇本身也消耗电力,而且空气的导热和散热能力有限。
液冷则可以利用冷板等结构直接把GPU产生的热量传递给冷却液,再通过冷却系统将热量带走。对于高密度GPU集群,液冷可以提高散热能力,并有机会降低部分风冷系统的能耗。
但液冷并不意味着服务器“完全不耗电”。泵、换热设备、控制系统以及机房冷却基础设施同样需要能源。最终应该比较的是整个数据中心的综合能耗,而不是只看GPU附近的温度。
CPU、内存和网络同样会增加功耗
GPU虽然是主要耗电设备,但绝不是唯一耗电设备。
AI服务器通常需要高性能CPU负责数据预处理、任务调度、存储访问以及GPU之间的协调工作。大量内存也会产生持续功耗,特别是在内存容量达到数百GB甚至TB级别的服务器中,内存本身已经成为不可忽视的电力负载。
高速网络设备同样如此。
大型AI训练通常需要多个GPU甚至多个服务器共同工作。为了让GPU之间快速交换梯度、激活值和其他数据,服务器需要配置高速网络适配器和交换网络。高速网络设备确实会增加功耗,但不能简单认为一块100Gbps网络卡就必然消耗100W甚至更多。实际功耗取决于具体网卡、光模块、链路速率和工作负载。
存储设备也是类似情况。NVMe SSD会消耗电力,但在绝大多数GPU训练服务器中,其功耗通常远低于高性能GPU。把存储系统功耗描述成与GPU本身相当,并不符合一般服务器配置。
真正需要计算的是整机功耗
因此,评估GPU服务器的电力需求,比较合理的方法是建立整机功耗模型:
整机功耗≈GPU功耗+CPU功耗+内存功耗+网络设备功耗+存储功耗+主板及其他设备功耗+电源转换损耗。
例如,一台安装多块高功耗GPU的服务器,GPU可能占据整机功耗的大部分,但CPU、内存和高速网络设备仍然需要计算。然后还需要根据电源冗余方案确定电源模块的额定容量。
这里还必须区分“实际功耗”和“设计功率”。一台服务器配置了数千瓦电源,并不意味着它每时每刻都消耗这么多电力。电源额定功率代表系统能够安全提供的最大能力以及设计余量,而不是服务器的固定耗电量。
从服务器到数据中心,问题进一步扩大
当GPU服务器从一台增加到几十台、几百台甚至更多时,电力问题就不再只是服务器厂商的问题,而成为数据中心基础设施问题。
假设一个机柜安装多台高密度GPU服务器,机柜功率可能达到传统通用服务器机柜的数倍。此时,数据中心需要重新评估机柜配电、UPS容量、PDU规格、供电线路、备用电源以及冷却能力。
这也是AI数据中心与传统数据中心逐渐出现明显差异的原因。
传统数据中心可以通过增加服务器数量扩展计算能力,而GPU集群更加关注单位机柜的计算密度。计算密度提高以后,如果供电系统和冷却系统跟不上,即使购买了更多GPU,也无法真正转化成有效的计算能力。
为什么“买更多GPU”不一定等于获得更多性能
高功率GPU服务器还有一个容易被忽略的问题,就是计算资源、网络和供电之间必须匹配。
如果GPU能够高速计算,却因为网络通信速度不足而等待数据,那么增加GPU数量的收益就会迅速下降。
同样,如果GPU性能很强,但数据加载速度不足,GPU就可能处于等待状态。即使服务器安装了更大的电源,也无法解决数据通道上的瓶颈。
因此,AI基础设施设计实际上是一项系统工程。GPU决定计算能力,HBM决定高带宽数据访问能力,CPU和内存负责数据处理与调度,高速网络负责节点之间的数据交换,而供电和散热系统则决定这些硬件能否长期稳定运行。
未来AI服务器的竞争,也不会只是比较谁拥有更多GPU。
随着单颗GPU功耗和计算密度继续提高,服务器厂商需要同时解决供电效率、散热能力、高速互联和机柜功率密度问题。对于数据中心,真正昂贵的部分也可能逐渐从购买GPU本身扩展到电力基础设施和冷却系统。
从这个角度看,GPU服务器的高功率需求并不是简单的“显卡越来越费电”,而是AI计算规模扩大之后整个计算基础设施发生变化的结果。未来能够高效运行大规模AI模型的数据中心,拼的不只是芯片数量,更是能否把电力、计算、网络、存储和散热真正组织成一个高效而稳定的整体。
GPU 服务器为什么需要高功率供电,从芯片功耗到整机电力系统逐层分析
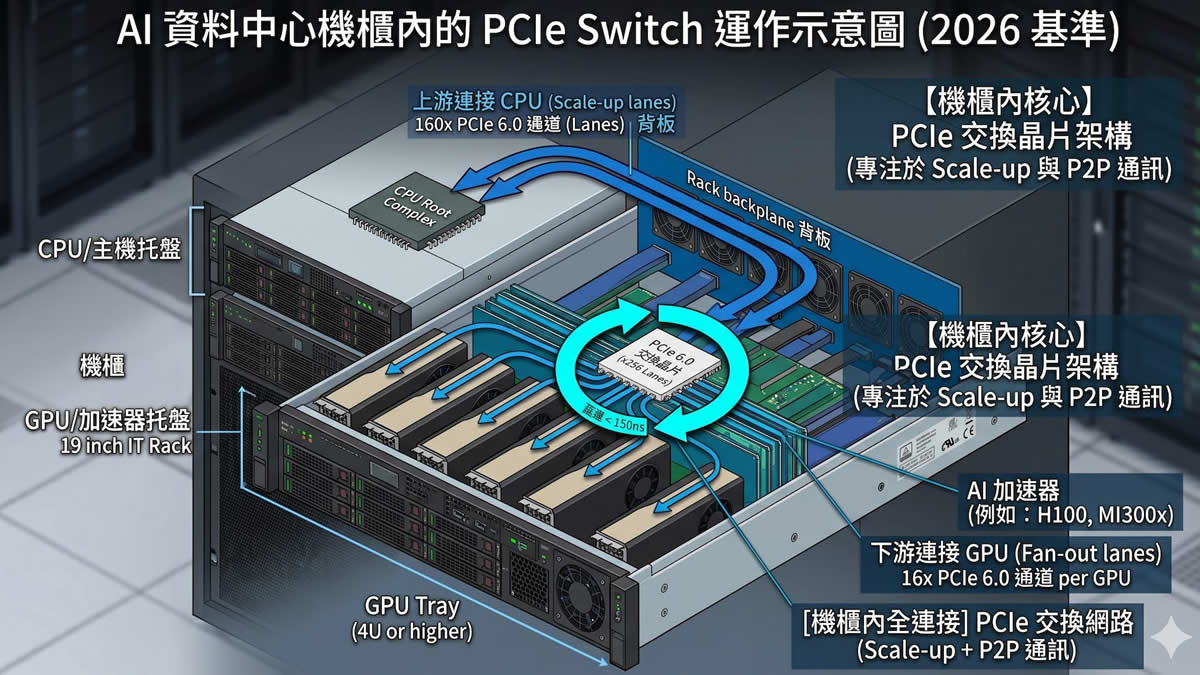
图片说明:示意图 图片来源:Public Domain(公有领域)

喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal):
https://www.paypal.me/observeccp
订阅中国观察电报 Telegram:
https://t.me/s/ObserveCCP