
大型人工智能模型最容易让人产生误解的地方之一,就是看到“1750亿参数”时,往往只想到模型有1750亿个数字,却没有意识到每一个数字都必须以某种数据格式存储,而且训练时GPU保存的远不只是这些参数本身。参数规模一旦进入数百亿、数千亿甚至万亿级别,数据类型的每一个bit都会被放大成数十GB甚至数百GB的显存需求。于是,模型能不能放进一张GPU、需要几张GPU,以及训练时GPU为什么很快就被显存吃满,本质上都与参数规模、数据精度、训练状态和计算图密切相关。
最基本的计算很简单。FP32使用32 bit,也就是4字节保存一个参数。假设一个模型有1750亿个参数,仅权重本身就需要1750亿×4字节,约为700GB的十进制容量。如果换成FP16或BF16,每个参数通常只需要2字节,那么同样的1750亿参数,权重存储量约为350GB。进一步采用8 bit格式,理论上的裸参数存储可以下降到约175GB。这个计算说明了为什么大型模型的参数精度会直接影响显存容量,但它只解决了“模型权重有多大”这个问题,并没有代表训练时的完整显存需求。
推理和训练必须分开计算。推理阶段通常不需要保存完整的反向传播状态,因此显存主要由模型权重、KV Cache、输入输出张量、临时计算缓冲区以及运行时框架开销构成。对于Transformer类大模型,长上下文场景下KV Cache甚至可能成为非常重要的显存消费者。也就是说,一个模型即使能够把全部权重塞进GPU,随着并发请求和上下文长度增加,显存仍然可能迅速上涨。
训练则完全是另一回事。训练过程中GPU不仅需要保存模型参数,还需要计算并保存梯度,同时还可能保存优化器状态、激活值以及大量临时缓冲区。对于使用Adam或AdamW一类优化器的训练任务,参数通常伴随着一阶矩和二阶矩状态;如果使用FP32保存这些训练状态,优化器部分可能远远超过模型权重本身。因此,“1750亿参数需要350GB显存”只能说明FP16/BF16权重的理论存储量,不能理解成“训练1750亿参数只需要350GB显存”。
以典型的混合精度训练为例,情况会更加复杂。很多训练系统不会简单地把所有数据都变成FP16然后一路计算到底,而是让矩阵计算使用FP16或BF16,同时保留更高精度的数据用于部分关键状态。具体实现取决于训练框架、优化器和硬件架构。某些方案会维护FP32 master weights,优化器状态也可能使用FP32;梯度则可能以BF16、FP16或FP32形式在不同阶段存在。因此,不能简单概括成“FP16计算、FP32保存梯度”,更准确的说法是混合精度训练根据数值稳定性和硬件能力,为参数、梯度、优化器状态和计算过程分别选择合适的数据格式。
这里还需要区分FP16和BF16。两者都是16 bit,但内部结构不同。FP16采用1 bit符号位、5 bit指数和10 bit尾数;BF16采用1 bit符号位、8 bit指数和7 bit尾数。FP16拥有更多尾数位,因此在某些范围内具有更高的相对精度,但指数范围明显小于BF16。BF16则保留了与FP32相同的8 bit指数宽度,因此在深度学习训练中通常具有更大的动态范围,也更适合处理梯度和激活值可能出现的大范围数值。现代AI加速器大量采用BF16,并不是因为它“比FP16更精确”,而是因为它在训练所需要的动态范围和显存效率之间提供了非常实用的折中。
FP32、FP16和BF16的显存差异基本可以直接从每个元素的字节数看出来。相同数量的参数,FP32需要4字节,FP16和BF16需要2字节。因此从FP32转换到16 bit格式,单纯权重存储量可以减少50%。但模型整体性能和显存并不会因此机械地下降50%,因为参数并不是唯一的数据来源。激活值、KV Cache、梯度、优化器状态、CUDA kernel workspace、通信缓冲区以及显存碎片都会改变最终结果。
8 bit格式进一步改变了模型的存储方式。FP8并不是一个单一格式,工程中常见的是E4M3和E5M2等不同编码方案,它们在指数范围和有效精度之间进行了不同取舍。FP8最大的价值之一,是在AI加速器支持相应硬件路径时,可以明显减少数据搬运量,同时提高单位显存容量能够容纳的数据量。对于大规模矩阵计算,这不仅仅是“少占显存”,还可能意味着更高的计算吞吐和更低的内存带宽压力。
INT8则与FP8存在本质区别。INT8是整数格式,通常需要通过量化尺度把浮点数映射到整数范围。推理阶段的INT8量化已经非常成熟,很多模型可以在合理的精度损失范围内获得明显的显存和计算效率优势。但不能简单说“INT8一定比FP16快一倍”或者“显存一定减少75%”。裸权重从FP32变成INT8确实可以从4字节降低到1字节,但模型运行时还需要scale、zero-point、激活、临时缓冲区以及特定kernel,因此最终显存下降比例取决于具体实现。
参数精度对训练和推理的影响,还必须放到GPU的内存层级中理解。模型计算并不是简单地把参数从显存读出来,然后交给计算核心一次就结束。现代GPU内部存在寄存器、共享内存、L1/L2 Cache以及HBM或其他显存层级,大规模矩阵运算需要持续在这些层级之间搬运数据。对于AI训练,HBM带宽经常成为重要瓶颈之一。降低数据精度后,同样的参数量需要搬运的数据量减少,在带宽受限的计算中可以获得明显收益。
以NVIDIA A100为例,其HBM显存带宽约为1.6TB/s。这意味着GPU每秒能够从高带宽显存向计算系统提供非常庞大的数据流,但这并不意味着PCIe接口也拥有1.6TB/s的传输能力。HBM带宽和PCIe带宽属于不同的数据通道,不能把两者混为一谈。GPU内部计算主要依赖自身的高带宽显存体系,而GPU与CPU、其他GPU之间的数据交换则可能受到PCIe、NVLink、NVSwitch或者网络互联的限制。
这也是为什么大型模型训练不能简单理解成“显存够不够”。当单张GPU无法容纳模型时,可以使用数据并行、张量并行、流水线并行、参数分片等技术,把模型状态和计算任务分布到多张GPU上。但多GPU并行又会引入通信成本。参数、梯度或者激活值需要在GPU之间交换,如果GPU计算速度提高以后,通信网络跟不上,系统就可能从“计算受限”变成“通信受限”。
对于训练系统来说,还有一个经常被忽略的因素,就是激活值。反向传播需要利用前向计算产生的一些中间结果,因此训练框架通常需要保存大量activation。模型参数规模相同的情况下,batch size、sequence length、层数、隐藏维度以及注意力结构都会改变激活显存。使用activation checkpointing可以通过重新计算部分前向结果来减少激活存储,但代价是增加计算量。这说明显存优化并不是单纯降低参数精度,而是在存储和计算之间进行交换。
如果从硬件维修和AI服务器部署的角度观察,参数精度还会影响GPU的实际工作模式。FP32、FP16、BF16和FP8对应的计算吞吐能力并不相同,具体速度取决于GPU架构以及Tensor Core等专用计算单元是否支持相应的数据类型。不能根据“FP16只有一半大小”就直接推导出“FP16一定快两倍”。如果工作负载受到显存容量限制,降低精度首先解决的是容量问题;如果受到HBM带宽限制,降低精度可能减少数据搬运;如果受到矩阵计算吞吐限制,则必须看GPU对应精度的硬件计算能力。
对于服务器故障诊断,这种区别也非常重要。如果AI训练过程中出现CUDA out of memory,首先需要判断究竟是模型权重、optimizer state、activation、KV Cache还是临时workspace占用了显存,而不是简单更换更大容量的GPU。如果GPU利用率很低但显存已经接近满载,也不能直接判断GPU算力不足,很可能是内存容量、数据加载、通信或者显存分配问题。如果GPU计算单元长期满载而HBM带宽并未成为瓶颈,则继续降低精度未必能够解决性能问题。
参数精度最终改变的是一个完整的系统成本模型。FP32提供更高的数值精度,但存储和带宽成本最高;FP16和BF16已经成为现代深度学习训练的重要工作格式;FP8进一步降低数据搬运和存储需求,并在支持它的AI加速器上提供更高的计算密度;INT8及更低比特量化则更多用于高效率推理,也可以根据训练方案进入更复杂的量化训练流程。
因此,判断一个模型究竟需要多少显存,不能只拿“参数量×每参数字节数”做结论。这个公式只能得到模型权重的裸存储量。真正的GPU内存需求还取决于训练还是推理、参数和优化器状态采用什么精度、batch size、sequence length、KV Cache、activation、并行策略以及运行时缓冲区。对AI服务器,显存容量决定模型能否装下,显存带宽决定数据能否持续供应,GPU计算单元决定矩阵运算速度,而GPU之间的互联则决定多卡系统能否把这些计算能力有效组织起来。
大型模型时代,所谓“降低精度”已经不是简单地把数字从32 bit改成16 bit。它实际上改变了模型在存储层、内存带宽、计算单元和多GPU通信体系中的数据流。理解这一点之后,才能解释为什么同一个模型可能在一张GPU上无法运行,却可以通过量化装入更小显存;也能理解为什么某些任务从FP16切换到FP8后不仅显存下降,吞吐量还会明显提高,而另一些任务即使降低精度,性能也几乎没有变化。模型规模只是第一层,数据精度、内存系统和计算架构共同决定了最终的工程成本。
模型参数为什么需要占用大量显存,参数精度变化会对显存需求产生什么影响
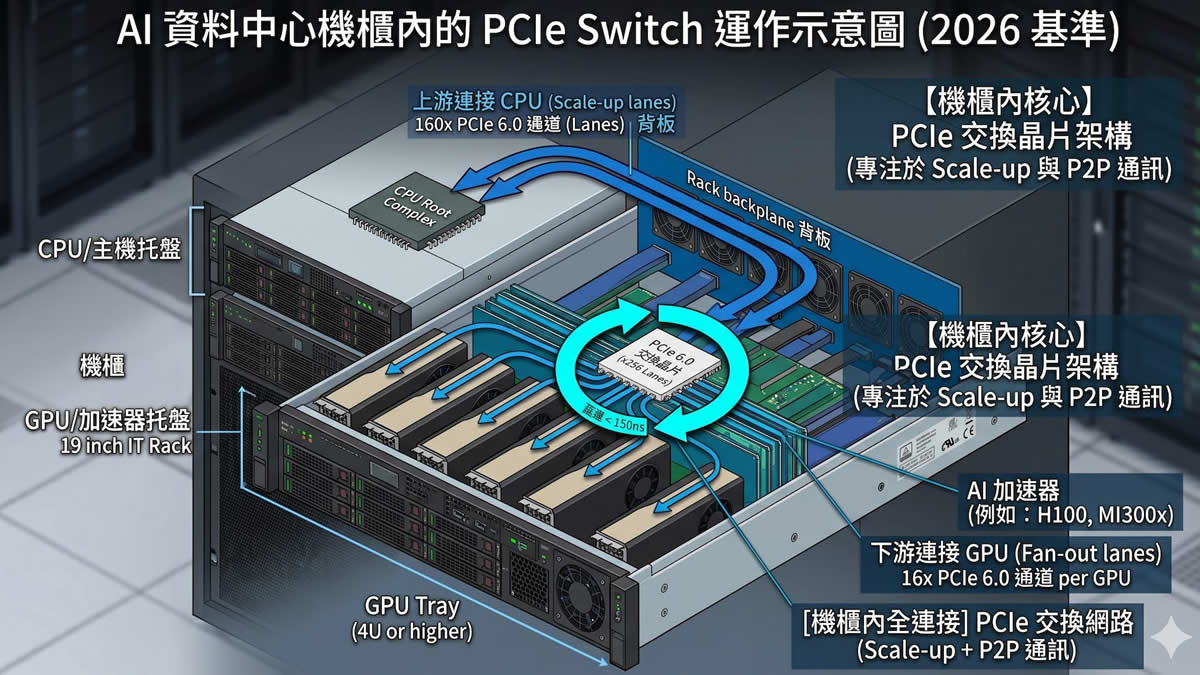
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP