
AI Gateway 在大模型平台中承担什么职责,从 API 请求到模型服务器完整分析
AI Gateway在大模型平台中承担着连接外部请求与模型服务的核心桥梁作用。其职责覆盖从API请求解析到模型服务器通信的全链路,涉及协议转换、负载均衡、模型路由、安全验证、资源调度等多个技术层级。本文将从请求处理流程、技术实现细节和系统瓶颈三个维度展开分析。
一、请求处理流程与技术实现
API请求解析
当用户通过REST API或gRPC接口发送请求时,AI Gateway首先需要解析请求头中的内容类型、认证令牌和请求体。对于大模型推理场景,关键参数包括模型名称、输入文本、上下文长度、流式输出以及并发控制参数等。请求解析阶段需要处理不同的数据格式,如JSON、Protocol Buffers等,并验证请求体的格式和参数是否合法。
负载均衡与路由决策
Gateway通过负载均衡和路由策略将请求分发至合适的模型服务器。常见的负载均衡算法包括轮询(Round Robin)、加权轮询(Weighted Round Robin)和最少连接数(Least Connections)。在分布式架构中,还可以结合服务发现机制,例如Kubernetes的Service和服务注册机制,动态获取可用的模型实例。
对于需要保持会话状态的场景,还可以采用会话亲和或一致性哈希等方式,使相关请求尽可能路由到相同的模型实例。不过,对于大模型推理,具体采用哪种路由方式,还要结合KV Cache、实例负载以及请求长度等因素综合判断。
协议转换与数据封装
外部应用通常通过HTTP/REST或gRPC调用AI Gateway,而后端模型服务可能采用专门的推理服务框架和通信接口。Gateway可以负责不同接口之间的数据转换和请求封装,将客户端提供的模型名称、输入内容、生成参数等信息转换为后端推理服务能够识别的格式。
需要注意的是,分词(Tokenization)通常由模型服务或专门的推理层完成,并非所有AI Gateway都负责这一工作。Gateway更适合承担请求路由、参数校验和协议适配等职责,以避免自身成为计算瓶颈。
安全验证与访问控制
在请求进入模型服务之前,Gateway通常负责完成身份认证和权限校验,例如OAuth 2.0、API Key或JWT等机制。对于敏感数据,还可以结合TLS加密、数据脱敏和访问审计等措施。
在分布式环境中,Gateway还需要确保后端服务之间的访问权限受到控制,避免未经授权的服务调用。同时,可以在Gateway层实施请求速率限制、并发限制和配额控制,防止恶意请求或资源滥用导致模型服务过载。
二、技术实现细节与系统瓶颈
通信协议与推理框架
AI Gateway与模型服务器之间可以采用HTTP、gRPC等通信方式,而具体的模型推理则可能由TensorRT-LLM、vLLM等推理框架负责。需要区分的是,TensorRT-LLM并不是一种通信协议,而是一套用于优化大模型推理性能的工具和运行时组件;OpenAPI则主要用于描述和规范HTTP API接口。
因此,在设计Gateway时,应分别考虑API接口规范、网络通信协议和后端推理框架,而不是将它们视为同一层面的技术。
资源调度与并发控制
Gateway需要根据后端模型实例的运行状态进行请求调度。在大模型推理场景中,需要关注GPU显存、GPU计算资源、CPU、网络带宽以及KV Cache等资源。
尤其是在长上下文和高并发场景下,KV Cache可能快速占用大量显存。如果单纯根据请求数量进行限流,而忽略每个请求的上下文长度和生成长度,就可能出现请求数量看似不高、GPU显存却迅速耗尽的情况。因此,更合理的调度策略通常需要同时考虑请求数量、输入输出Token数量以及模型实例当前的资源状态。
网络通信瓶颈
模型服务通信涉及多个层级。客户端到Gateway之间主要受到网络距离、带宽和连接数量影响;Gateway到模型服务器之间则需要考虑网络延迟和服务端处理能力。在GPU服务器内部,还存在PCIe、NVLink等高速互联技术,它们主要负责CPU、GPU以及GPU之间的数据传输,与普通的网络通信属于不同层次。
对于大规模分布式模型服务,跨服务器通信可能成为性能瓶颈,因此可以根据具体硬件环境采用高速网络、RDMA或InfiniBand等技术进行优化。
显存与带宽的协同优化
大模型推理过程中,KV Cache的大小与模型结构、上下文长度、并发请求数量以及KV Cache的数据精度等因素有关。因此,不能简单用某一个固定数值判断所有模型的显存需求。
在实际部署中,应根据模型参数规模、量化方式、上下文长度和并发量进行估算。例如,同一个模型在短上下文低并发和长上下文高并发情况下,其KV Cache占用可能存在很大差异。此时除了显存容量之外,显存带宽也会影响推理吞吐和响应延迟。
三、系统瓶颈分析与优化策略
GPU利用率瓶颈
当GPU利用率低于预期时,原因可能来自CPU供数不足、请求批次过小、显存带宽限制或者模型本身的计算特征。对于大模型推理,还需要关注连续批处理(Continuous Batching)等机制,通过动态合并多个请求提高GPU利用率。
对于KV Cache占用较高的模型,可以从缓存管理、上下文长度控制以及请求调度等方面进行优化,而不是单纯依靠增加GPU数量解决问题。
网络通信瓶颈
在分布式训练中,AllReduce等通信操作可能成为性能瓶颈,因为训练过程需要频繁进行参数或梯度同步。但在本文所讨论的AI Gateway和在线推理场景中,更值得关注的是请求分发、模型实例之间的通信以及流式响应传输。
对于跨服务器的大模型推理,需要根据模型并行方式评估网络带宽和延迟,并在必要时采用RDMA或InfiniBand等高速网络技术。
资源调度瓶颈
当多个模型服务同时争夺GPU资源时,Gateway或者其背后的调度系统需要根据实时负载进行合理分配。例如,可以综合考虑GPU利用率、显存占用、请求队列长度和平均响应时间,将新请求发送到更加合适的模型实例。
对于高并发场景,还可以采用动态资源分配和自动扩缩容机制。同时需要监控CPU、系统内存、GPU显存以及存储IOPS,避免模型加载和数据读取成为新的瓶颈。
协议转换与性能开销
协议转换和数据序列化、反序列化都会产生一定的计算开销。如果Gateway承担过多的数据处理任务,在高并发环境下自身也可能成为性能瓶颈。
因此,应尽量保持数据处理链路简单,并采用高效的序列化格式,例如Protocol Buffers。在请求量较大的场景下,还可以通过连接复用、异步处理和批量请求等方式降低额外开销。
在实际部署中,AI Gateway的性能优化需要综合考虑硬件架构、软件栈和网络环境。例如,在采用NVLink互联的多GPU服务器中,应重点关注GPU之间的数据传输效率;在云原生环境中,则需要结合Kubernetes的服务发现、资源调度和自动扩缩容能力。
AI Gateway本身并不是简单的“API转发器”,而是大模型平台中连接用户、业务系统和模型基础设施的重要控制层。它需要同时处理认证、路由、限流、配额、协议适配和监控等任务,并根据后端模型的实时状态做出调度决策。只有合理划分Gateway、推理服务和底层基础设施之间的职责,才能在保证安全性和稳定性的同时,充分发挥GPU集群的计算能力。
AI Gateway 在大模型平台中承担什么职责,从 API 请求到模型服务器完整分析
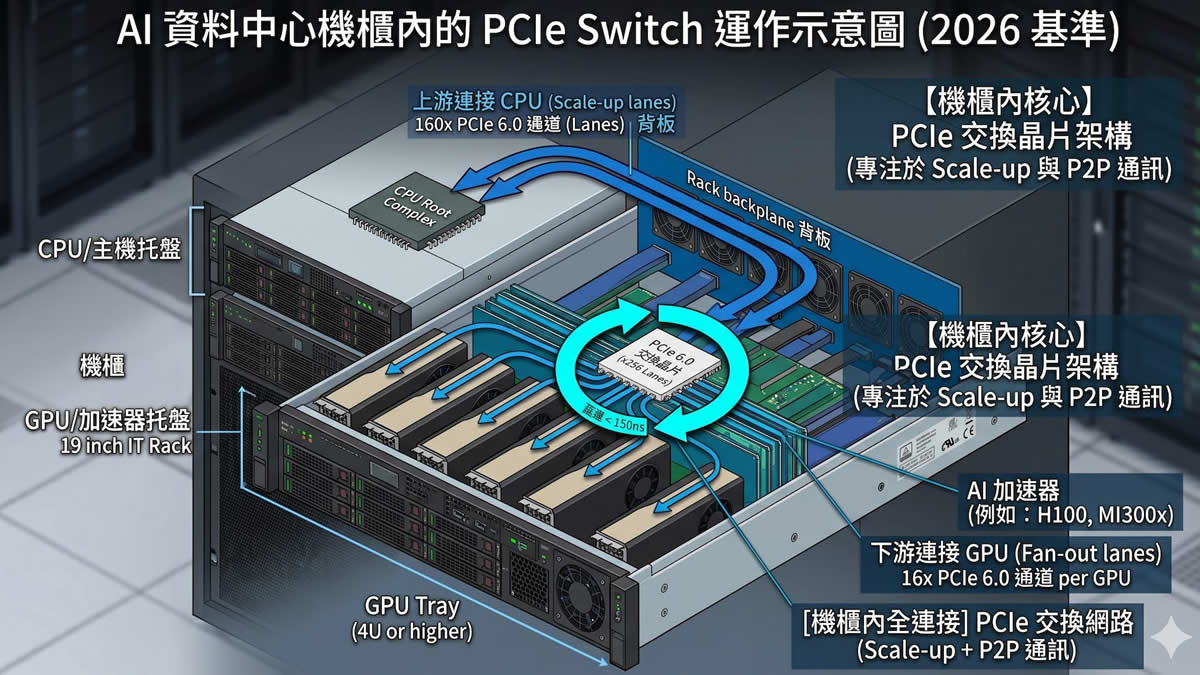
图片说明:示意图 图片来源:Public Domain(公有领域)

喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal):
https://www.paypal.me/observeccp
订阅中国观察电报 Telegram:
https://t.me/s/ObserveCCP