
在深度学习训练服务器上,GPU利用率忽高忽低,是最容易被误判的一类性能问题。很多人打开nvidia-smi,看到GPU利用率从90%掉到20%,再升回95%,第一反应就是“GPU没有吃满”。但这句话其实没有告诉我们真正发生了什么。GPU可能正在等待CPU准备数据,也可能在等待PCIe或NVLink传输,也可能卡在NCCL通信,甚至可能只是模型本身由大量短小Kernel组成。要判断瓶颈在哪里,不能只盯着一个百分比,而要观察一次完整训练step究竟花时间等什么。
最典型的数据管道瓶颈,是GPU计算完一个batch之后,下一批数据还没有准备好。CPU端可能正在读取文件、解压数据、JPEG解码、随机裁剪、数据增强、tokenization或者执行其他预处理。如果DataLoader、worker线程、内存缓存或者存储系统跟不上,GPU就只能等待。监控上经常表现为一种比较规律的锯齿形曲线:GPU执行一段时间后突然掉到低利用率,过一会儿数据准备完成,GPU再次冲高。如果这种低谷与batch边界高度同步,而且CPU端同时出现worker忙碌、I/O等待或者数据队列见底,那么数据管道就非常可疑。
不过,“GPU利用率下降”并不自动等于数据加载慢。现代训练系统通常采用prefetch,让CPU提前准备多个batch,因此即使数据处理本身比较重,只要预取队列始终没有耗尽,GPU仍然可以保持连续计算。反过来,即使磁盘I/O并不高,也可能因为worker数量不足、Python处理开销、锁竞争、内存拷贝或者数据格式不适合并行处理而让GPU等待。因此真正值得观察的是“GPU等待期间,谁在工作”。
如果GPU始终处于高负载,但训练速度仍然没有达到预期,就应该转向计算瓶颈。此时不能只看GPU utilization,还应该看SM利用率、Tensor Core使用情况、显存带宽、L2 Cache、Kernel执行时间以及每个Kernel的占比。一个GPU显示接近100%的利用率,并不意味着Tensor Core一定已经达到最佳效率。某些模型可能主要进行内存访问,GPU看起来非常忙,实际算力却没有充分发挥;也可能大量时间消耗在低效率的小Kernel上。
这也是为什么“GPU利用率95%就是性能很好”并不是可靠结论。GPU utilization更多描述设备是否正在执行工作,而不是说明这些工作是否高效。真正的训练性能应该结合每秒处理多少token、samples/sec、step time、TFLOPS以及硬件理论峰值来判断。对于Transformer训练,还可以进一步观察矩阵乘法Kernel是否能够使用合适的数据类型和Tensor Core路径。如果模型尺寸、batch size或者张量shape不理想,即使GPU utilization看起来很高,也可能没有达到应有的吞吐量。
另一个经常被忽视的瓶颈是GPU之间的通信。在多GPU数据并行训练中,每个GPU完成本地计算之后,需要通过AllReduce等集体通信操作交换梯度。如果计算速度越来越快,而GPU之间的通信没有同步提高,那么训练时间可能越来越多地消耗在通信上。此时你可能看到所有GPU利用率同时出现规律性下降,或者不同GPU之间出现明显不同步。有些卡已经进入下一阶段计算,另外一些卡还在等待通信,整个训练step最终必须等最慢的设备。
这时候应该重点检查NCCL通信时间、AllReduce耗时、PCIe拓扑、NVLink状态、InfiniBand或其他高速网络,以及多机训练中的网络吞吐和延迟。对于分布式训练,“GPU没满”并不一定是坏事。如果GPU正在等待另一个GPU完成AllReduce,那么增加DataLoader worker数量基本没有意义。你给存储系统加速,也无法解决一个纯粹的网络通信瓶颈。
专业排查时,nvidia-smi适合做第一层观察,但不适合承担全部诊断任务。它可以告诉你GPU利用率、显存占用、温度、功耗以及部分时钟信息,却无法告诉你一个训练step里面究竟是哪一个CUDA Kernel在等待。更深入的分析应该使用Nsight Systems观察CPU、CUDA、GPU Kernel、数据传输和通信之间的时间关系,再用Nsight Compute分析具体Kernel的计算效率和内存访问行为。PyTorch Profiler也非常适合定位训练代码中的CPU与CUDA时间分布。
例如,如果时间线上出现“CPU DataLoader处理完成→Host to Device拷贝→GPU Kernel执行→GPU空闲→下一批数据准备完成”的重复模式,那么首先应该检查DataLoader、prefetch、pin_memory以及数据预处理。如果时间线显示GPU Kernel连续执行,但大量时间消耗在内存访问,那么方向应该转向显存带宽、Cache命中率和Kernel设计。如果GPU计算结束后长时间出现NCCL AllReduce,则应该调查通信拓扑和分布式同步。
Host-to-Device数据传输本身也可能成为瓶颈。使用固定页内存,也就是pin_memory,可以减少部分CPU到GPU传输的开销;配合non_blocking传输和合理的预取机制,可以让数据拷贝与GPU计算产生更多重叠。但这些优化不是万能药。如果数据本身在CPU端就没有准备好,GPU再快也只能等。
Batch size也是一个重要变量。过小的batch可能导致Kernel规模不足、调度开销比例增加,GPU无法发挥高吞吐计算能力;过大的batch则可能受到显存容量、通信以及数据准备速度影响。因此不能简单地认为“把batch调大就一定更快”。对于Transformer训练,还要考虑sequence length、padding比例以及动态batch造成的计算量变化,因为两个batch虽然样本数相同,实际token数量可能完全不同。
优化器同样需要放在正确的位置理解。AdamW等优化器会带来额外的参数和状态读写,但不能简单地通过一句“换成LAMB就能提高GPU效率”解决问题。真正应该做的是通过Profiler确认优化器更新在整个step中占用了多少时间,再决定是否需要融合Kernel、调整实现方式或者采用适合当前模型规模的优化方案。
判断GPU波动究竟来自哪里,可以采用一个非常实用的顺序:先看step time是否稳定,再看GPU计算时间和空闲时间;如果存在明显空闲,再检查CPU DataLoader和H2D传输;如果GPU持续工作,则检查Kernel计算效率和内存带宽;如果多GPU之间存在等待,再检查NCCL和网络;最后再回到模型本身检查batch size、tensor shape、算子融合、混合精度和Kernel选择。
对于训练服务器维护人员来说,还应该同时关注CPU核心利用率、内存带宽、NUMA拓扑、磁盘或对象存储吞吐、PCIe链路状态以及GPU温度和功耗。如果GPU因为功耗限制、温度导致的降频或者硬件错误而频率下降,那么软件层面看到的“GPU利用率异常”实际上可能是硬件运行状态发生变化。尤其在多GPU服务器中,PCIe拓扑和NUMA绑定配置错误,也可能让原本应该高速传输的数据绕远路,最后表现成GPU等待。
因此,一条忽高忽低的GPU曲线本身并不是诊断结论,它只是一个症状。真正有价值的是把GPU曲线与训练step时间、CPU数据准备、H2D传输、CUDA Kernel、NCCL通信和存储I/O放在同一条时间线上。只要能够回答“GPU下降的时候,谁在占用时间”,计算瓶颈和数据管道瓶颈通常就能迅速分开。
在实际工程中,最值得追求的也不是让nvidia-smi上的GPU utilization永远显示99%,而是让整个训练系统形成稳定的流水线:数据提前准备,CPU与GPU传输能够与计算重叠,GPU Kernel保持足够规模和效率,多GPU通信不成为主要等待点,最终让每个training step以稳定且可预测的时间完成。GPU百分比只是仪表盘上的一个指针,真正决定训练集群价值的,是单位时间到底完成了多少有效计算和多少有效数据处理。
训练任务中 GPU 使用率忽高忽低意味着什么,如何判断是计算还是数据管道问题
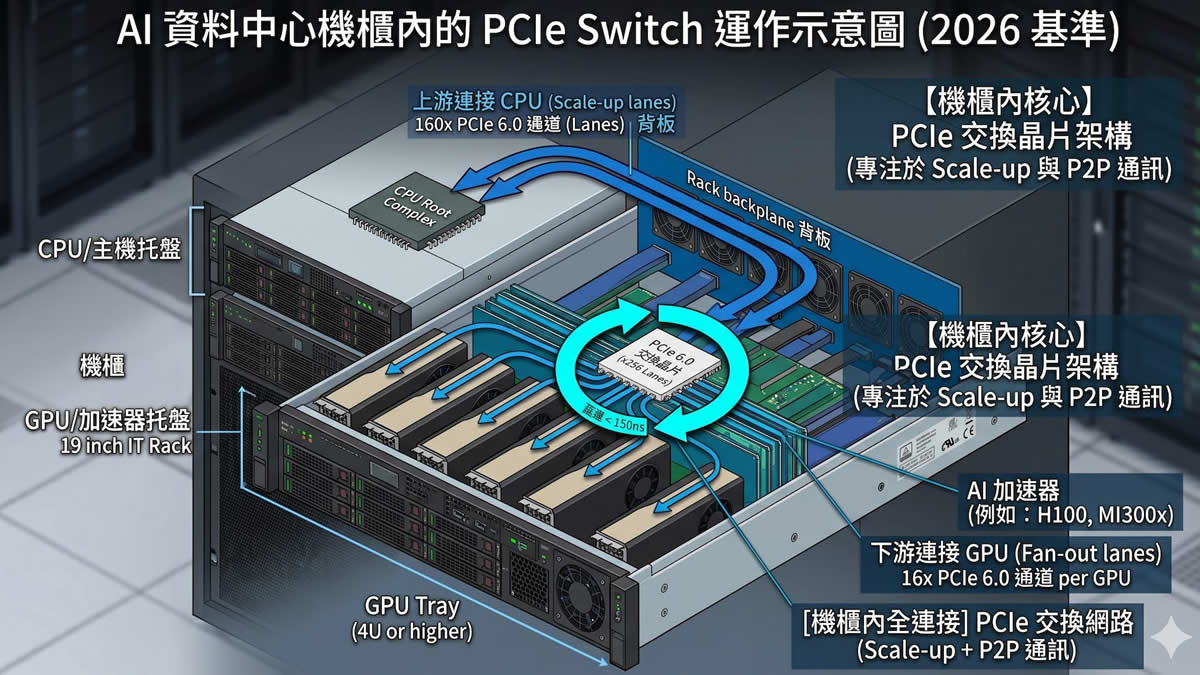
图片说明:示意图 图片来源:Public Domain(公有领域)

喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal):
https://www.paypal.me/observeccp
订阅中国观察电报 Telegram:
https://t.me/s/ObserveCCP