
大型 AI 集群为什么需要分布式文件系统 单台存储服务器到底卡在哪里
当 AI 训练集群从几台 GPU 服务器扩大到几十台、几百台甚至更大的规模以后,存储系统很容易从“后台基础设施”变成整个计算平台的瓶颈。GPU 的计算能力可以通过增加节点不断扩张,但训练数据并不会凭空出现在显存里。每一个训练 Step 都需要持续完成数据读取、预处理、主机内存缓存以及 Host-to-Device 数据传输。如果存储系统供不上数据,GPU 再昂贵也只能等待。
这也是为什么大型 AI 集群通常不会简单地在机架上增加一台容量更大的 NAS,然后让所有 GPU 节点共享一个目录。单台存储服务器当然可以承担大量工作,而且对于中小型 AI 集群来说,成熟的 NAS、全闪存阵列或者对象存储完全可能比复杂的分布式文件系统更合适。但当并发计算规模、数据集容量和吞吐需求继续增长以后,单节点架构会逐渐暴露出容量、网络、控制器、故障域以及并发访问等方面的限制。
单台存储服务器最大的限制不是硬盘容量
很多人谈到单台存储服务器的限制,第一反应是“硬盘插满以后容量不够”。容量确实是问题,但在 AI 训练环境中,容量通常不是最先撞上的墙。
假设一台存储服务器安装了大量 NVMe SSD,理论上可以获得非常高的本地存储吞吐。但这些 SSD 的数据最终必须通过存储服务器的 CPU、PCIe 总线、存储软件栈和网络接口送到 GPU 服务器。
因此,真正需要计算的是完整的数据路径,而不是只看 SSD 标称速度。
如果一台服务器内部有几十块高速 NVMe,每块盘都能提供数GB/s的顺序吞吐,那么所有 SSD 加起来可能达到数十甚至上百GB/s。但如果服务器到计算集群只有一组有限带宽的网络链路,那么这些本地 SSD 的理论性能根本无法全部传递给远端 GPU 节点。
这就是典型的“后端存储能力远大于前端出口能力”。
例如 100GbE 链路的理论线速大约是 12.5GB/s,200GbE 大约是 25GB/s,400GbE 大约是 50GB/s。实际应用吞吐还要受到协议栈、网络拓扑、存储软件、CPU、RDMA、TCP/IP、文件系统以及数据访问模式等因素影响。因此不能简单地拿 NVMe 的标称读写速度与网络带宽直接比较,然后得出系统性能结论。
对于 GPU 集群,最重要的指标不是“服务器里有多少块 SSD”,而是最终能够稳定提供多少有效数据吞吐,以及在真实并发访问条件下延迟是否可控。
AI 训练对存储的要求与普通文件服务器完全不同
普通办公文件服务器的访问模式可能是几十甚至几百个用户随机打开 Word、Excel、PDF 或图片。系统只要保证基本响应速度即可。
AI 训练完全不同。
假设有数百台 GPU 服务器,每台服务器又运行多个 DataLoader worker,那么瞬间产生的文件访问请求数量可能非常高。如果训练数据由大量小文件组成,系统除了传输数据本身,还必须处理大量 open、stat、目录查询、权限检查、元数据更新等操作。
因此,AI 存储性能不能只用 IOPS 衡量。
对于大型训练任务,更应该同时关注有效吞吐量、平均延迟、P95/P99 延迟、元数据操作能力、并发连接数量、网络利用率、客户端缓存命中率以及 GPU 等待数据的时间。
一个存储系统即使随机 IOPS 非常高,如果面对大量小文件时元数据服务成为瓶颈,训练性能仍然可能非常差。
反过来,如果训练数据已经被整理成适合顺序读取的大型数据分片,系统对随机 IOPS 的需求可能下降,而持续吞吐能力反而成为主要指标。
单台 NAS 并不是一定不能做 AI
原稿把传统 NAS 描述成存在“单点访问瓶颈”,这个说法过于绝对。
现代企业级 NAS 和高端并行存储设备本身就可以采用多控制器、多个网络接口、SSD 缓存以及横向扩展架构。某些 NAS 产品完全可以承担大型 GPU 集群的一部分数据工作。
真正的问题是架构规模和工作负载是否匹配。
如果只有十几台 GPU 服务器,训练数据规模几TB到几十TB,而且数据读取模式比较稳定,那么一套高性能 NAS 加上合理的缓存,可能已经足够。为了几十台 GPU 强行部署复杂的分布式文件系统,反而会增加运维、监控、故障排查和一致性管理成本。
当 GPU 节点不断增加以后,单一存储系统的出口带宽、控制器处理能力、元数据能力和故障域才可能逐渐成为限制因素。
因此,不能简单用“NAS不好,分布式文件系统好”概括。真正应该问的是:训练集群需要多少有效吞吐,峰值并发是多少,数据是大文件还是小文件,访问是否高度并发,是否需要 POSIX 文件语义,允许多高的数据丢失风险,以及预算和运维能力能否承担相应复杂度。
分布式文件系统解决的是横向扩展问题
分布式文件系统的核心优势,是可以把容量和数据服务能力分散到多个存储节点。
假设整个训练数据集达到PB级别,如果所有数据都集中在一台服务器,那么这台服务器同时承担容量、网络、CPU、文件系统和故障处理任务。
分布式架构则可以把数据切分到多个存储节点,让不同客户端请求落到不同的数据服务节点。随着节点增加,系统可以在一定范围内同时增加存储容量、网络出口和后端磁盘吞吐。
但这里必须强调“在一定范围内”。
分布式系统并不会自动产生线性扩展。
如果网络交换架构存在过载,元数据服务只有一个瓶颈节点,数据分布严重倾斜,副本重建占满网络,或者客户端访问模式高度集中,那么增加存储节点以后性能可能增长很少,甚至因为系统协调成本增加而下降。
所谓横向扩展,真正的前提是数据、网络、元数据和计算路径都能够同步扩展。
元数据有时候比数据吞吐更容易成为瓶颈
AI 存储系统经常出现一个非常典型的问题:数据本身没有那么难传,难的是管理大量文件。
假设训练集包含数十亿个小文件,即使每个文件只有几十KB,总数据量可能并没有大到不可管理,但客户端需要进行大量目录访问、文件打开和属性查询。
这时 GPU 看到的可能不是“存储吞吐不足”,而是 DataLoader 不断等待文件系统响应。
因此大型 AI 数据集通常会进行数据集重构,例如将大量小文件整理成更适合训练的分片格式,通过较少数量的大对象或者大型数据 shard 提供连续读取。
这样做不仅能够减少元数据压力,还可以提高网络传输效率,让预取和缓存更加容易。
数据布局本身就是 AI 存储架构的一部分,而不是存储系统部署完成以后才考虑的问题。
分布式文件系统也不是简单复制三份数据
另一个常见误解,是认为分布式文件系统就是“把数据复制到三台服务器”。
副本确实是很多分布式存储系统使用的容错机制,但这只是其中一种设计。
系统还可能使用纠删码、分片、数据重平衡以及不同的副本放置策略。
例如三副本意味着存储空间开销明显增加,但读取和故障恢复策略比较直接。纠删码可以降低冗余空间成本,但编码、解码和小写入处理会增加计算和 I/O 复杂度。
对于训练数据来说,如果数据本身是不可变的、可以从原始数据源重新生成,那么采用更高效的存储编码可能比对所有数据进行高成本多副本保护更合理。
对于检查点则完全不同。
训练 Checkpoint 往往非常大,而且一旦损坏或者丢失,恢复训练的成本可能非常高,因此通常需要独立的可靠性和生命周期策略。
数据集、Checkpoint、日志和临时缓存并不应该使用完全相同的存储策略。
GPU 训练最怕的不是存储慢,而是 GPU 空转
判断 AI 存储系统是否足够快,最直接的方法不是盯着存储服务器上的磁盘利用率,而是观察 GPU 是否因为数据供给不足而等待。
假设 GPU 理论计算能力极高,但训练过程中 DataLoader 经常阻塞,那么 GPU 利用率可能出现周期性下降。
这时候应该进一步检查 CPU worker 是否繁忙、网络是否饱和、存储延迟是否升高、数据预处理是否耗时、Host-to-Device 传输是否成为瓶颈,以及训练框架是否进行了有效的 Prefetch 和异步数据加载。
如果 GPU 始终处于计算饱和状态,那么即使再增加一套高速存储系统,也未必能够提高训练速度。
反过来,如果 GPU 每隔几秒就出现明显空闲,而存储或数据加载链路恰好存在等待,那么优化存储系统才有实际价值。
所以 AI 基础设施优化最终应该围绕端到端训练吞吐量,而不是某一个组件的峰值性能。
本地 NVMe 和分布式文件系统通常可以同时存在
大型 AI 集群也不意味着所有数据都必须直接从共享分布式文件系统读取。
一种常见架构是把共享存储作为权威数据源,然后利用计算节点本地 NVMe 建立缓存。
第一次读取数据时,从共享存储获取并写入本地 NVMe;后续训练任务如果再次使用相同数据,就可以直接从本地高速存储读取。
这种架构可以降低共享存储的压力,同时减少跨网络读取。
不过本地缓存不是数据源,也不能简单当成备份。
缓存需要处理数据版本、失效策略、容量限制、命中率以及多节点一致性问题。对于不可变训练数据,这件事情比较容易处理,因为数据集可以使用版本号、Manifest 或内容哈希标识。
如果训练数据经常变化,则缓存失效问题会明显复杂。
网络架构决定分布式存储能不能跑起来
分布式文件系统的性能很大程度上取决于网络。
如果存储节点通过有限的上行链路连接到交换机,那么增加更多 SSD 或存储节点并不能自动解决问题。
AI 集群通常需要根据 GPU 节点数量、存储节点数量以及预期吞吐量设计网络拓扑,并考虑链路聚合、交换机端口速率、东西向流量、拥塞控制以及 RDMA 等技术。
这里还需要区分 GPU 互联网络与存储网络。
NVLink 是 GPU 或 GPU 节点内部高速互联技术,不能把它简单理解成“服务器之间的存储网络”。如果存储系统使用 RDMA,实际承载 RDMA 的通常是 InfiniBand 或支持 RoCE 的高速以太网环境。
网络拓扑没有设计好,存储系统本身再强也可能因为交换机或者上行链路拥塞而无法发挥性能。
故障恢复也不能简单写成毫秒级
原稿提出“分布式系统能够实现毫秒级故障恢复”,这种说法缺少工程条件。
一个存储节点发生故障以后,客户端是否立即感知、服务是否继续、数据是否需要重建、网络是否需要重新连接以及副本是否完整,都会影响实际恢复时间。
对于读取已经存在多个副本的数据,系统可能很快切换到其他副本;但如果需要进行大规模数据重建,恢复时间可能是分钟、小时甚至更长。
更重要的是,故障恢复本身会消耗存储节点和网络资源。
例如一台容量很大的存储节点突然损坏,系统开始重建数据副本。重建流量如果过高,可能反过来影响正在运行的训练任务。
因此真正成熟的存储系统需要设计故障域、数据放置策略、重建速度限制以及后台恢复优先级,而不是简单追求“故障后马上恢复”。
AI 存储架构需要根据数据类型分层
一个成熟的 AI 集群通常不会让所有数据都使用完全相同的存储方式。
原始训练数据可以放在对象存储等容量型系统中;经过清洗和分片的数据可以放在高吞吐共享文件系统;正在运行的训练任务可以利用本地 NVMe 缓存;Checkpoint 则可以采用高可靠存储策略;日志和监控数据又可以使用完全不同的数据系统。
这种分层的目的不是追求架构复杂,而是让不同类型的数据使用适合自己的成本和性能模型。
容量型数据不一定需要最高 IOPS;临时缓存不一定需要最高可靠性;Checkpoint 则需要关注写入吞吐、可靠性和恢复速度。
把所有数据都放进一套最昂贵的全闪存分布式文件系统,通常也不是最经济的解决方案。
什么时候单台存储服务器仍然是正确答案
对于规模较小的 AI 环境,单台高性能存储服务器完全可能是更合理的方案。
例如只有几台 GPU 服务器,训练数据规模有限,数据读取模式稳定,而且本地 NVMe 能够承担大量缓存,那么使用一台配置合理的存储服务器,再通过高速网络提供共享数据,可能已经足够。
这种架构最大的优势就是简单。
存储节点少,故障点少,系统组件少,监控简单,维护成本低。出了问题也更容易定位。
只有当容量、吞吐、并发、可用性或者故障域开始超过单节点架构能够合理承受的范围时,才有必要进入分布式存储。
大型 AI 集群真正需要解决的并不是“单台服务器太小”这么简单,而是计算规模已经让一个存储节点承担不了整个数据服务路径。
当 GPU 节点数量增长以后,数据读取会从单纯的磁盘问题变成一个包括存储介质、文件系统、元数据、缓存、CPU、PCIe、网络和数据加载框架在内的系统工程。分布式文件系统的价值,就是把原本集中在一个故障域和一个性能瓶颈中的能力拆开,让容量、吞吐和故障处理可以随着集群规模扩展。
但分布式并不等于性能自动翻倍。数据分片是否合理、元数据是否成为瓶颈、网络是否足够、缓存是否有效、训练数据是否适合顺序读取,以及 GPU 是否真的受到存储限制,最终决定了这套系统有没有价值。对于 AI 基础设施,最昂贵的错误往往不是少买了几块 SSD,而是在 GPU 已经等数据的时候,才发现整个存储架构从一开始就没有按照并发计算规模设计。
大型 AI 集群为什么需要分布式文件系统,单台存储服务器有哪些明显限制
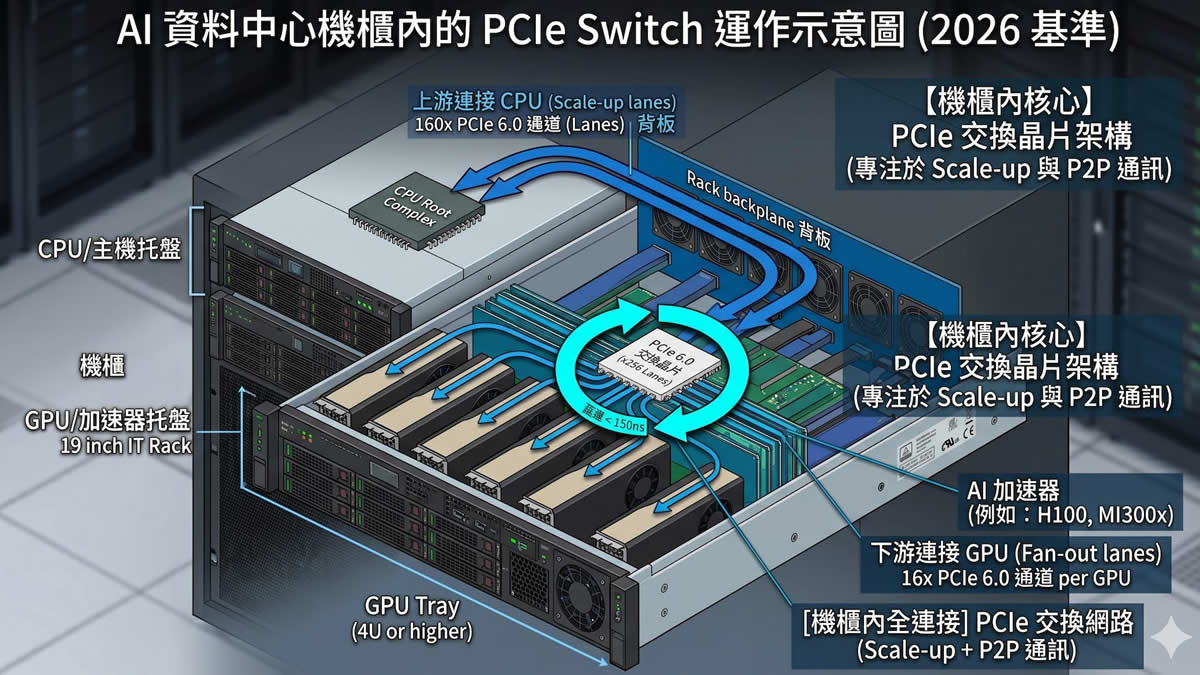
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP