
【中国观察北京时间2026年08月16日】
GPU利用率只有几十个百分点时,最容易出现的误区是直接认为GPU性能不够,或者马上增加GPU数量。实际上,GPU利用率只是一个现象,并不能单独说明系统到底出了什么问题。
对于AI训练、推理或者多GPU任务来说,GPU没有持续处于忙碌状态,可能是因为计算任务本身不足,也可能是在等待CPU、内存、存储、网络通信,甚至可能是程序主动进行了同步等待。因此,排查GPU利用率低的问题,关键不是寻找一个固定的百分比阈值,而是找出GPU究竟在等待什么。
一、先确认GPU利用率低是不是真的影响了性能
第一步不是修改程序,而是确认业务到底有没有性能问题。
例如一个推理服务的GPU利用率只有几十个百分点,但请求量很低,而且延迟和吞吐都已经满足业务要求,那么这种利用率并不一定需要优化。
相反,如果GPU利用率长期偏低,同时训练速度明显下降、推理延迟升高或者吞吐量达不到目标,就值得进一步排查。
因此应该同时观察GPU利用率、GPU显存使用、任务吞吐、请求延迟、CPU使用率、内存使用、存储和网络等指标,而不是只盯着一个GPU百分比。
二、第一层排查计算链路
GPU需要CPU和其他系统组件不断准备任务。如果CPU端准备数据、执行程序逻辑或者进行数据预处理的速度跟不上,GPU完成当前任务后就可能等待下一批工作。
例如训练过程中,数据需要经过读取、解码、预处理,然后送到GPU。如果这些步骤耗时较长,GPU计算完成以后没有新的数据可以处理,就会出现利用率下降。
这时候可以观察CPU各核心的负载、数据加载进程以及程序的执行情况。
但也不能简单地认为CPU利用率高就是CPU瓶颈。CPU可能有很多任务处于等待状态,也可能只有少数核心繁忙。因此需要进一步观察CPU核心负载、进程和线程状态,以及数据加载和预处理所占用的时间。
另一个容易忽视的问题是GPU本身的计算任务太小。
如果模型、Batch Size或者单次请求的计算量比较小,GPU可能很快完成一个计算阶段,然后等待下一项任务。此时增加GPU数量通常不会自动解决问题,因为原来的工作量并没有增加。
三、显存容量和显存带宽也要分开看
GPU出现利用率低的时候,还需要检查显存。
但显存使用量高并不等于显存带宽已经成为瓶颈。
显存容量主要决定模型权重、激活值、KV Cache以及其他数据能否放入GPU显存;显存带宽则影响数据在显存与计算单元之间移动的速度。
例如一个模型可能只占用部分显存,但运行过程中需要频繁读取和写入大量数据,这时仍然可能受到显存带宽或者内存访问模式的影响。
因此不能简单看到显存没有用满,就认为GPU资源没有问题,也不能看到显存占用很高,就直接判断显存带宽不足。
四、第二层排查数据读取
如果CPU和GPU之间的工作衔接存在明显等待,就应该进一步检查数据读取链路。
训练数据可能来自本地NVMe、普通磁盘、网络存储或者对象存储。数据从存储系统读取以后,还可能经历解压、解码、格式转换和预处理,最后才能进入GPU。
因此所谓数据读取瓶颈,并不一定意味着硬盘速度慢。
例如存储本身读取速度足够快,但数据格式需要大量CPU解码;也可能是文件数量太多,导致文件系统操作成为负担;还可能是数据来自远程存储,网络传输速度限制了数据供给。
排查时可以观察存储吞吐、IOPS、读写延迟、CPU数据处理时间以及数据加载队列。
如果GPU经常在等待下一批数据,而存储读取或者数据预处理时间明显较长,那么数据供应链就可能成为瓶颈。
五、为什么不能简单说NVMe越快越好
NVMe通常能够提供较高的存储性能,但并不是所有AI任务都需要极高的随机IOPS。
训练数据如果主要是连续读取的大文件,系统可能更关注顺序读取吞吐;如果是大量小文件,则文件系统操作和随机访问可能更加重要。
因此判断存储是否是瓶颈,应该看实际工作负载,而不是看到NVMe或者普通硬盘的名称就直接下结论。
一个更可靠的方法是比较两个时间:
数据准备需要多久,GPU计算需要多久。
如果GPU很快完成计算,但下一批数据很久才能准备完成,那么优化方向应该放在数据管线,而不是继续增加GPU。
六、第三层排查多GPU之间的网络通信
单GPU任务和多GPU任务的排查方式并不完全一样。
单机多GPU可能主要受到GPU之间互联、PCIe拓扑以及CPU与GPU连接方式影响;多服务器GPU集群则还需要考虑服务器之间的网络通信。
分布式训练中,不同GPU通常需要交换梯度、参数或者其他中间数据。
例如AllReduce是一种常见的集体通信操作,它可以让多个GPU对各自的数据进行计算后,再交换并聚合结果。
如果GPU已经完成自己的计算,却必须等待其他GPU完成通信,那么GPU利用率就可能出现周期性的下降。
这时候问题不一定在GPU计算能力,而可能在通信链路。
七、如何判断网络是不是瓶颈
不能看到GPU利用率低,就直接认为网络有问题。
更可靠的方法是观察GPU计算和通信是否存在明显的等待关系。
如果多个GPU经常同时出现计算结束,然后进入通信,再等待通信完成,随后重新开始计算,这种模式就值得检查通信性能。
进一步可以检查:
GPU之间的通信量是否很大?
通信是否集中在某些GPU或者某些网络链路?
是否存在网络拥塞?
网卡是否正常工作?
GPU与网卡之间的拓扑是否合理?
RDMA等通信机制是否正常?
分布式框架的通信操作是否耗时过长?
这些问题需要结合具体集群架构和性能数据判断,不能使用一个固定的网络带宽数字作为判断标准。
八、不要把InfiniBand和RoCE混为一谈
AI集群经常使用RDMA技术减少网络通信开销。
RDMA是一类允许系统以较低CPU参与度进行远程内存数据传输的技术。InfiniBand和RoCE都是常见的高速网络通信路线,但两者并不是同一个东西。
RoCE是在以太网上实现RDMA,而InfiniBand使用的是独立的高速互联体系。
因此排查网络问题时,首先应该确认实际使用的是哪种网络架构,再检查对应的网卡、驱动、交换机配置、通信路径以及分布式框架配置。
不能看到RDMA就直接把InfiniBand和RoCE当成同一种网络。
九、程序同步也可能让GPU空闲
有些GPU利用率低的问题,既不是计算能力不足,也不是存储和网络速度不够,而是程序本身存在等待。
例如一个计算阶段完成后,程序要求多个GPU同步,然后才能进入下一阶段。如果其中一个GPU或者某个节点执行速度较慢,其他GPU就可能等待。
这种情况下,即使所有服务器的CPU、GPU、存储和网络硬件都没有明显故障,整体利用率仍然可能不高。
因此分布式AI任务需要特别关注同步点。
尤其是GPU数量增加以后,计算本身可能变得更快,但通信和同步的相对成本也可能增加。这也是为什么增加GPU数量以后,实际性能不一定按照GPU数量同比增长。
十、训练和推理的排查重点不同
训练任务通常需要重点观察数据加载、前向计算、反向传播、梯度同步以及检查点等环节。
如果每个训练Step都需要等待数据,那么应该检查数据管线;如果计算完成后大量时间用于AllReduce等通信操作,则应该检查GPU之间的通信;如果某些GPU明显比其他GPU慢,则还需要检查负载是否均衡。
推理任务则有所不同。
推理需要关注请求进入、排队、Batch、模型执行、KV Cache、上下文长度、并发以及输出生成等因素。
例如一个大语言模型推理服务的GPU利用率并不高,可能只是请求数量不足,也可能是Batch太小、请求长度差异较大,或者模型执行阶段本身存在等待。
因此不能拿训练任务的判断方法直接套到推理服务上。
十一、真正有效的排查顺序是什么
面对GPU利用率只有几十个百分点的问题,可以按照一条比较简单的路径排查:
先确认业务性能是否真的受到影响。
然后确认GPU是在计算,还是在等待。
如果在等待,再判断是在等待CPU和数据准备,还是等待存储,还是等待网络通信。
单GPU任务重点检查CPU、内存、数据加载、存储和程序执行。
单机多GPU还需要检查GPU互联和PCIe拓扑。
多服务器训练则进一步检查网络、RDMA、通信操作和节点之间的同步。
如果这些硬件指标都正常,就需要回到模型和程序本身,检查Batch Size、并行方式、数据管线、同步机制以及模型计算特征。
十二、最重要的是找到GPU的等待时间
GPU利用率低本身不是最终答案。
真正有价值的问题是:
GPU为什么没有继续工作?
如果它在等数据,就检查数据管线。
如果它在等CPU,就检查数据预处理和程序执行。
如果它在等存储,就检查读取吞吐和延迟。
如果它在等网络,就检查GPU之间的通信。
如果它在等其他GPU,就检查负载均衡和同步。
如果它没有等待,只是计算任务本身很小,那么问题可能根本不是硬件瓶颈,而是工作负载没有足够的并行度。
因此,排查GPU利用率低的问题,不能建立在某个固定百分比或者某个固定硬件指标之上。几十个百分点可能只是一个现象,真正需要定位的是从数据进入系统,到CPU准备任务,再到GPU计算,以及多GPU之间通信的完整链路。
对于AI基础设施来说,最有效的优化通常不是看到GPU利用率下降就立即增加GPU,而是先找到GPU没有获得足够工作的真正原因。只有确定瓶颈位于计算、数据、网络、存储、同步还是软件执行之后,才能知道应该优化哪一个环节。
GPU 利用率只有几十个百分点时应该从哪里排查,计算、网络和数据读取如何定位瓶颈
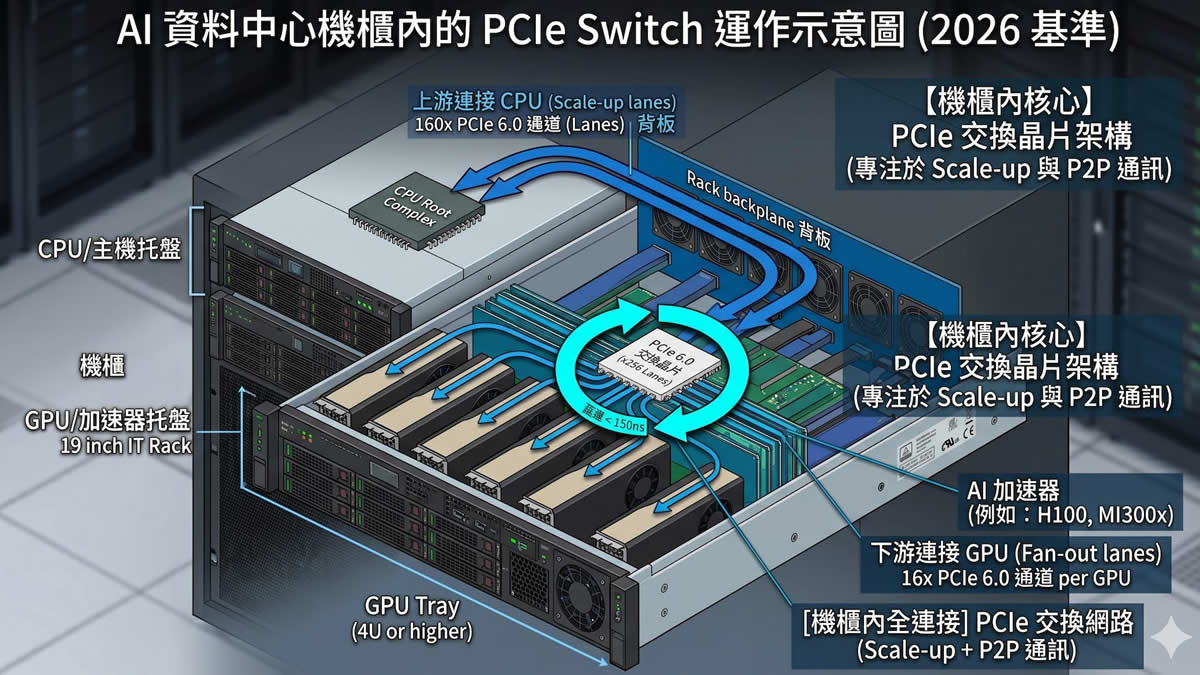
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP