
【中国观察北京时间2026年08月19日】在人工智能训练和推理系统中,GPU的计算能力只是整个系统性能的一部分。当模型规模扩大到需要多块GPU甚至多个服务器共同运行时,真正决定系统效率的往往不再只是GPU能够完成多少次计算,而是数据能否及时到达正确的GPU。
一个看似简单的过程,例如将一个张量从GPU A交给GPU B,实际上可能涉及GPU显存、GPU内部互联、PCIe、CPU内存、网络适配器、数据中心交换机以及另一台服务器中的GPU等多个环节。数据究竟经过哪条路径、每个环节能够提供多少带宽以及通信延迟有多高,都会直接影响训练和推理效率。
理解GPU之间的数据传输,不能只看某一项“带宽数字”,而应该从整个数据移动路径来看。
GPU首先从自己的显存读取数据
GPU执行计算时,大量模型参数、输入数据、中间激活值以及梯度都需要存放在显存中。现代高性能AI GPU通常使用HBM,也就是高带宽内存,通过先进封装和多通道内存接口为GPU提供非常高的内存带宽。
以NVIDIA A100为例,其不同版本采用HBM2或HBM2e,并提供高达约1.6 TB/s的显存带宽。这里需要注意,显存带宽与GPU之间的互联带宽是两个不同概念。前者描述GPU访问自身显存的能力,后者描述不同GPU之间交换数据的能力。
GPU拥有非常强大的计算能力,并不意味着它能够无限快地从其他GPU获取数据。如果计算单元等待远端数据到达,GPU的部分计算资源就可能处于空闲状态。因此,在大规模AI系统中,数据移动本身已经成为与计算能力同等重要的性能因素。
单机多GPU首先要面对GPU之间的互联
一台服务器安装多块GPU之后,这些GPU需要交换数据。最基本的连接方式之一是PCIe。
PCIe是一种通用高速I/O互联技术,也是大量GPU服务器连接CPU、GPU、网卡和其他设备的重要基础设施。例如PCIe 5.0 x16链路的理论单向带宽约为64 GB/s,双向合计理论带宽约为128 GB/s。实际可用带宽会受到协议开销、平台设计和拓扑结构等因素影响。
因此,在大量GPU之间需要频繁交换数据的AI训练场景中,仅依赖PCIe往往不是最理想的方案。
高端GPU服务器通常还会使用专门的GPU互联技术,例如NVIDIA的NVLink。NVLink通过专用高速链路直接连接GPU,可以提供明显高于传统PCIe连接的GPU间通信能力。
需要注意的是,NVLink的带宽并不是一个固定数字。不同GPU架构、不同NVLink版本以及具体服务器拓扑之间存在明显差异。因此,讨论NVLink性能时,必须明确具体GPU型号和互联配置,而不能简单地说“NVLink就是1TB/s”。
GPU之间传输数据时,数据到底经过哪里
假设GPU A需要把一批数据交给GPU B,最理想的情况是两块GPU之间存在高速直接互联。
在这种情况下,数据可以通过GPU之间的高速互联链路传输,而不需要把所有数据先复制到CPU内存,再从CPU内存复制回另一块GPU。
如果两块GPU之间没有合适的直接互联,数据则可能需要通过PCIe以及服务器内部的CPU或PCIe交换结构完成转发。
因此,同一台服务器中的两块GPU,虽然物理距离很近,但它们之间的实际通信速度仍然取决于服务器主板、PCIe拓扑、GPU之间的连接方式以及平台设计。
这也是为什么购买一台“8 GPU服务器”并不意味着八块GPU之间天然拥有完全相同的通信性能。
在实际系统中,有些GPU之间可能存在高速直接连接,而另一些GPU之间则需要经过PCIe交换结构。软件通信库需要根据硬件拓扑选择更加合适的通信路径。
GPU访问CPU内存又是另一条数据路径
GPU并不只使用自己的显存。在一些应用中,GPU需要读取CPU内存中的数据,或者将计算结果写回系统内存。
传统PCIe GPU系统中,GPU与CPU之间的重要通信路径就是PCIe。因此,如果大量数据频繁在GPU显存和CPU内存之间来回移动,PCIe带宽以及CPU平台的内存和I/O结构都可能成为瓶颈。
但现代GPU平台已经发展出更加复杂的内存访问和数据移动机制。统一虚拟地址、GPU直接内存访问以及不同平台上的内存共享技术,可以减少部分数据移动开销。
因此,“GPU访问CPU内存必须把数据完整复制到CPU再处理”这种理解已经过于简单。
真正需要关注的是数据位于什么位置、由哪个设备访问、使用什么互联方式以及是否发生了不必要的数据复制。
跨服务器以后,问题就从GPU互联变成了网络通信
当多块GPU分布在不同服务器中时,GPU之间已经不能只依靠服务器内部的NVLink或PCIe。
此时,数据必须通过网络从一台服务器传输到另一台服务器。
在AI训练集群中,高性能网络通常采用InfiniBand或者基于以太网的RoCE等技术,并配合RDMA,也就是Remote Direct Memory Access,让数据能够更加直接地在不同服务器的内存和设备之间传输,从而减少传统网络通信过程中CPU参与和数据复制带来的开销。
例如,在多机多卡训练中,一台服务器中的GPU需要把梯度或其他张量数据发送到另一台服务器。数据可能从GPU显存进入高速网络适配器,再经过数据中心交换机,最后到达另一台服务器的网络适配器,并进入目标GPU可以访问的内存空间。
因此,一次跨服务器GPU通信实际上是一个完整的数据路径,而不是简单的“GPU把数据通过网线发送出去”。
InfiniBand和RoCE有什么区别
InfiniBand长期以来一直被大量高性能计算和AI集群采用。它从设计之初就针对高性能计算和低延迟通信进行了优化。
RoCE则是在以太网基础上实现RDMA能力的一种技术路线。它能够利用现代高速以太网基础设施,同时提供低延迟、高带宽的数据通信能力。
两者都可以用于大规模AI训练集群,但实际性能不仅取决于“100G、200G还是400G”这样的链路速度,还受到网络拓扑、交换机、网卡、拥塞控制、软件栈以及服务器配置等多种因素影响。
因此,在比较AI集群网络时,仅仅比较网络标称带宽并不充分。
为什么AI训练经常需要AllReduce
在数据并行训练中,每块GPU通常处理不同的数据批次,但它们需要共同维护模型参数。
一次训练迭代完成后,不同GPU会产生各自的梯度。为了让所有GPU继续保持模型参数一致,这些梯度需要进行聚合,然后将结果同步给参与训练的GPU。
AllReduce就是解决这一问题的重要集合通信操作。
简单理解,AllReduce就是让多个GPU共同计算一组数据的聚合结果,并最终让每个GPU都获得相同的结果。
如果只有少量GPU,通信量可能还比较容易控制;当GPU数量扩大到数百甚至数千块之后,梯度同步就可能成为整个训练系统的主要瓶颈。
因此,大规模AI训练系统不仅需要高性能GPU,还需要高带宽、低延迟的GPU互联和网络。
AllReduce并不是简单地把数据集中到一台机器
一种直观但效率较低的理解,是把所有GPU的数据全部发送到某一个节点,由这个节点完成计算,再把结果发送回所有GPU。
这种方式容易形成中心节点瓶颈。
实际高性能通信库通常会根据GPU和网络拓扑采用更加复杂的集合通信算法,例如Ring AllReduce、Tree以及针对具体硬件拓扑进行优化的通信方案。
NVIDIA GPU集群中,NCCL是非常重要的GPU集合通信库。它能够根据GPU之间的互联以及网络拓扑选择通信路径,并针对AllReduce、AllGather、ReduceScatter等常见集合通信操作进行优化。
这也是现代AI训练系统中软件和硬件高度结合的一个典型例子。
数据并行、模型并行的通信方式并不相同
不同的分布式训练方法,对通信系统的要求也不同。
数据并行通常让不同GPU处理不同的数据,然后在训练过程中同步梯度,因此通信压力主要集中在梯度聚合。
模型并行则是把模型计算本身拆分到不同GPU。不同GPU可能负责不同的模型层、张量分片或者计算阶段,因此在计算过程中就需要频繁交换中间结果。
当模型规模非常大时,还可能使用参数、梯度和优化器状态的分片策略,将原本无法放入单块GPU显存的数据分散到多个GPU。
这意味着模型规模越大,并不只是需要“更多显存”,同时也意味着GPU之间的数据通信设计变得越来越重要。
显存带宽和GPU互联带宽是两个概念
AI硬件讨论中非常容易出现一个误区,就是把HBM带宽和GPU之间的互联带宽混为一谈。
例如,一块GPU拥有超过1 TB/s的显存带宽,意味着它访问自己显存的数据速度非常高;但如果另一块GPU需要把数据发送给它,实际速度则取决于两块GPU之间的互联方式。
如果GPU之间通过高速NVLink连接,通信带宽可能远高于传统PCIe连接;如果数据必须跨服务器,则最终还会受到网络带宽和通信协议的限制。
因此,AI服务器的性能实际上受到多个“带宽层级”的共同影响:GPU内部计算能力、GPU与HBM之间的带宽、GPU之间的互联带宽、服务器内部I/O带宽以及服务器之间的网络带宽。
任何一层成为瓶颈,都可能限制整个系统的效率。
为什么网络速度必须跟上GPU计算能力
现代AI GPU的计算能力增长非常快,但网络速度和数据移动能力并不一定能够以完全相同的速度增长。
假设GPU可以在很短时间内完成一批计算,却需要更长时间等待另一台服务器的数据,那么GPU的计算能力就没有得到充分利用。
这就是所谓的通信瓶颈。
在实际AI集群中,工程师通常会通过增加网络带宽、优化GPU拓扑、减少不必要的数据交换、采用通信与计算重叠以及优化集合通信算法等方式降低这一问题。
所谓通信与计算重叠,就是在GPU进行下一部分计算的同时,让另一部分数据在后台传输,从而尽量避免GPU因为等待网络而完全停下来。
混合精度为什么也能减少通信压力
降低数据精度不仅可以减少显存占用,还可以降低部分通信的数据量。
例如,FP32每个数值通常占4字节,而FP16和BF16通常占2字节。如果某些通信数据能够使用更低精度表示,那么相同数量的数据就可以用更少的字节传输。
这并不意味着“使用FP16就一定让所有通信速度提高一倍”,因为实际性能还受到通信协议、算法、计算能力、数据布局以及硬件支持等因素影响。
但在AI训练中,混合精度已经成为非常重要的性能优化手段。
推理场景与训练场景并不完全相同
GPU之间的数据传输在训练和推理中的特点并不一样。
训练需要不断计算梯度,并在多个GPU之间进行参数或梯度同步,因此通信量通常非常大。
推理则更加依赖模型部署方式和请求规模。一个模型可以完整放在单块GPU上,也可以通过张量并行、流水线并行等方式分布在多块GPU上。
对于大型语言模型,当单块GPU无法容纳完整模型或者需要提高并发能力时,多GPU推理就会产生大量GPU间通信。
此时,通信延迟不仅影响单个请求的响应时间,也会影响整个系统能够处理的请求数量。
因此,推理系统并不是单纯地“GPU越多越快”。如果增加GPU以后带来的通信开销超过了计算收益,系统整体性能反而可能下降。
从整个系统来看,GPU通信是一条完整的数据链
如果把整个过程串起来,可以看到一个相对完整的数据移动路径。
模型数据首先从存储系统加载到CPU内存或者其他系统缓冲区,然后进入GPU显存。GPU从HBM读取模型参数和输入数据完成计算。如果计算需要其他GPU的数据,就通过PCIe、NVLink等服务器内部互联完成GPU之间的数据交换。
如果目标GPU位于另一台服务器,则数据需要进一步经过高速网络适配器、交换机以及远端服务器的网络接口,最终进入另一块GPU可以访问的数据区域。
在分布式训练中,这个过程会被大量重复,并与GPU计算同时进行。
因此,真正决定AI集群性能的不是某一个孤立的“GPU带宽”,而是从显存、GPU互联、PCIe、网络到通信软件整个系统能否协调工作。
GPU性能竞争正在从单纯的算力竞争转向系统级竞争
随着大型AI模型不断扩大,GPU数量已经从单机几块逐渐扩展到几十、数百甚至更多。GPU之间如何通信,已经成为AI基础设施设计的重要组成部分。
未来的高性能AI系统不会只关注单块GPU能够提供多少计算能力,还需要同时考虑GPU显存带宽、GPU之间的互联、CPU和I/O架构、网络带宽、交换机拓扑以及通信软件。
这也是为什么现代AI数据中心越来越强调“系统级设计”。GPU、网络、存储和软件不再是完全独立的组件,而是共同构成一个数据处理系统。
从一块GPU的HBM读取数据,到两块GPU通过高速互联交换张量,再到不同服务器之间通过RDMA网络完成集合通信,看似只是数据从一个地方移动到另一个地方,实际上背后涉及内存架构、总线、专用互联、网络协议、通信算法和软件调度等多个层面。
理解这条完整的数据路径,也就能够理解为什么在大规模AI系统中,GPU之间能以多快的速度交换数据,有时并不比GPU本身能完成多少计算更重要。
GPU 之间的数据究竟如何传输,从显存读取到跨服务器通信完整梳理
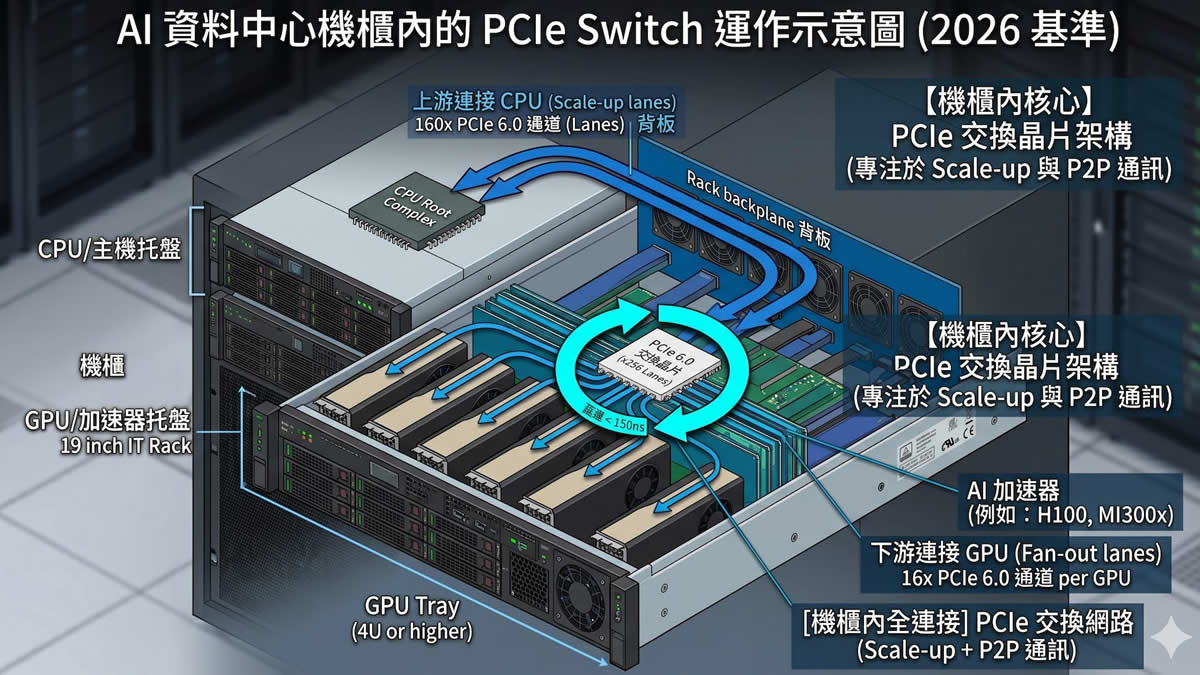
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP