
AI集群性能下降时,最容易犯的错误就是打开nvidia-smi,看见GPU利用率只有50%,然后马上认定“GPU没有跑满”。实际上,GPU利用率只是一个现象指标,并不能直接告诉你性能瓶颈在哪里。一套AI集群可能GPU利用率很高,但tokens/s很低;也可能GPU利用率只有60%,系统的实际吞吐却已经接近硬件和模型的合理上限。真正专业的排查,应该先定义性能指标,再从应用层一路向下追到GPU、CPU、内存、PCIe、NVLink、网络和存储。
第一步应该回答一个最基本的问题:到底是什么性能下降了。训练任务通常关注samples/s、tokens/s、step time、每步耗时、GPU有效计算时间和扩展效率;LLM推理则要分别观察吞吐量、Time to First Token,也就是TTFT,以及生成阶段的TPOT或Inter-Token Latency。vLLM目前直接提供TTFT、ITL、端到端延迟、prefill时间、decode时间以及请求排队等指标,因此看到“响应变慢”以后,可以进一步判断究竟是排队、prefill还是decode阶段出了问题。
这一步非常重要,因为“GPU变慢”和“用户感觉变慢”完全可能是两回事。例如请求量突然增加,GPU实际上一直在高负载运行,但请求排队时间增加,用户看到的是TTFT和P99延迟上升。反过来,如果GPU利用率下降,同时CPU使用率、数据加载等待或者网络通信时间增加,那么真正的问题可能根本不在GPU。
确定性能指标以后,第二步才是查看GPU本身。nvidia-smi可以观察GPU利用率、显存占用、功耗、温度、时钟频率以及运行进程,但不要把GPU-Util当成最终答案。对于H100这样的GPU,硬件本身拥有非常高的Tensor Core计算能力和HBM带宽。H100 SXM的HBM带宽为3.35TB/s,NVLink带宽为900GB/s,PCIe Gen5接口带宽则是128GB/s。 如果GPU利用率只有50%,需要进一步判断另外50%的时间究竟是在等待CPU、等待数据、等待通信,还是模型本身就没有足够的计算工作。
尤其需要观察GPU时钟和功耗。如果某张卡的计算利用率突然下降,同时功耗和SM时钟也明显低于其他GPU,就要检查温度、功率限制、GPU降频、驱动状态以及硬件异常。如果八张GPU中只有一张明显异常,那么优先怀疑单卡、PCIe链路、散热或者节点级问题,而不是马上修改整个模型的并行策略。
第三步是检查CPU和数据输入链路。很多AI训练任务看起来像GPU任务,实际上GPU可能一直在等待CPU准备下一批数据。DataLoader worker不足、Python处理过重、数据解压耗时、网络文件系统延迟、NUMA绑定错误,都可能让GPU出现周期性空转。使用PyTorch Profiler观察CPU、GPU以及分布式操作的时间线,通常比单独看nvidia-smi更加有价值。PyTorch Profiler本身就提供分布式训练视图,可以观察不同worker之间的计算、通信和负载差异,并帮助发现straggler,也就是拖慢整个同步步骤的慢节点。
接下来检查GPU之间的通信。如果是多GPU训练,单卡性能很好并不意味着八卡、几十卡甚至几百卡能够线性扩展。DDP、Tensor Parallel、Pipeline Parallel以及各种ZeRO策略都会产生不同的通信模式。此时需要观察NCCL collective,例如all-reduce、all-gather、reduce-scatter等操作到底占用了多少时间。
如果怀疑节点之间的网络,不能只运行一个普通的iperf然后宣布“网络正常”。对于InfiniBand环境,可以使用NVIDIA NCCL文档推荐的perftest工具,例如ib_write_bw测试节点之间的带宽,并进一步比较主机内存路径和GPU内存路径。对于GPUDirect RDMA,还应该确认HCA、RDMA、DMA-BUF、驱动和网络配置是否正常。
GPU之间的链路也需要单独判断。NVLink、PCIe和跨节点InfiniBand解决的是不同层级的问题,不能简单用某一个理论带宽数字替代实际应用性能。比如模型需要频繁进行跨GPU同步,那么通信延迟、消息大小、拓扑结构和collective算法都会影响结果。即使交换机标称带宽很高,如果GPU之间的实际拓扑不理想,或者某个节点的网络路径存在异常,整个分布式任务仍然可能被最慢的worker拖住。
这也是为什么分布式训练必须观察“每个rank”,而不能只看整个集群的平均值。假设32张GPU中31张卡每一步需要1秒,而其中一张卡因为数据读取或网络问题需要1.5秒,那么同步训练的整体step时间很可能接近最慢worker,而不是32张卡的平均时间。PyTorch Profiler现在能够进一步关联分布式collective事件,对定位这种通信和straggler问题尤其有帮助。
第四步才是检查显存和KV Cache。显存使用率高并不等于性能有问题,真正需要关注的是显存是否已经接近容量上限、KV Cache是否持续增长、是否发生频繁的缓存驱逐或请求抢占,以及batch和sequence length是否发生变化。以vLLM为例,其生产指标包括KV Cache使用率、等待请求数量、运行请求数量、KV block驱逐等信息,这些指标比单纯查看nvidia-smi上的显存占用更能解释推理性能变化。
如果TTFT突然增加,但decode阶段速度基本没有变化,应该优先检查prefill、输入token数量、请求排队以及调度,而不是马上增加GPU。反过来,如果TTFT正常而ITL明显恶化,则更应该检查decode阶段的batch、KV Cache压力、GPU计算或内存带宽。vLLM甚至提供了queue、prefill、decode等阶段性的时间指标,可以把一个看似简单的“模型变慢”进一步拆解成几个具体问题。
第五步才轮到模型和运行时优化。训练场景需要检查batch size、gradient accumulation、sequence length、mixed precision、activation checkpointing、ZeRO配置以及tensor、pipeline和data parallel的组合。推理场景则需要检查batching策略、并发度、KV Cache、CUDA Graph、量化方式以及模型的Tensor Parallel配置。这里尤其不能把“GPU数量增加”当成默认解决方案。如果瓶颈已经从计算转移到通信,那么继续增加GPU反而可能让通信比例更高。
对于LLM服务,吞吐和低延迟本身就是两个可能发生冲突的目标。较大的batch通常能够提高总体tokens/s,但可能增加单个请求的等待时间;较小的batch可能改善交互延迟,却无法充分利用GPU。vLLM目前也区分偏向交互延迟和偏向吞吐的运行模式,因此实际调优应该根据业务目标选择,而不是追求一个所谓“GPU利用率100%”的数字。
第六步检查存储和数据路径。训练集如果来自网络文件系统、对象存储或者共享NAS,磁盘和网络I/O可能直接影响GPU供给。可以通过iostat、fio以及系统级监控检查设备队列、IOPS、吞吐和延迟。需要特别注意的是,SSD随机读取快并不意味着整个训练任务一定更快,因为数据格式、缓存、解压、预取和DataLoader设计同样可能成为瓶颈。
最后才是硬件和软件版本之间的组合问题。CUDA、NVIDIA驱动、PyTorch、NCCL、通信插件、容器版本和GPU固件之间存在依赖关系。性能突然下降尤其应该检查“发生下降之前改了什么”:驱动有没有升级,容器镜像有没有改变,模型有没有换版本,batch有没有变化,节点有没有增加,网络配置有没有调整,Kubernetes调度规则有没有改变。很多性能事故并不是硬件突然变慢,而是某次软件或配置变更改变了执行路径。
因此,一套真正有效的AI集群诊断路径应该形成一个从业务指标向硬件指标逐层收敛的过程:先确认吞吐、step time、TTFT、TPOT和P99延迟,再判断问题属于计算、排队、数据、通信还是内存;随后比较不同GPU和不同rank,定位异常节点;然后进入NCCL、PCIe、NVLink、RDMA、CPU、存储和GPU硬件层;最后才修改batch、并行策略、缓存和模型配置。
真正专业的性能优化不是让某个监控面板上的数字看起来漂亮,而是找到一条可以被数据证明的因果链。例如“P99上升→请求排队增加→prefill backlog增加→GPU计算资源已经饱和”,或者“step time上升→某rank通信时间增加→RDMA带宽下降→网络链路异常”。一旦能够把性能下降拆成这样的链条,AI集群就不再是一个只能靠经验猜测的黑箱,而变成一个可以通过时间线、计数器、带宽、延迟和profiling数据逐层定位的工程系统。
AI 集群性能出现下降时应该从哪里开始排查,建立一套完整的诊断路径
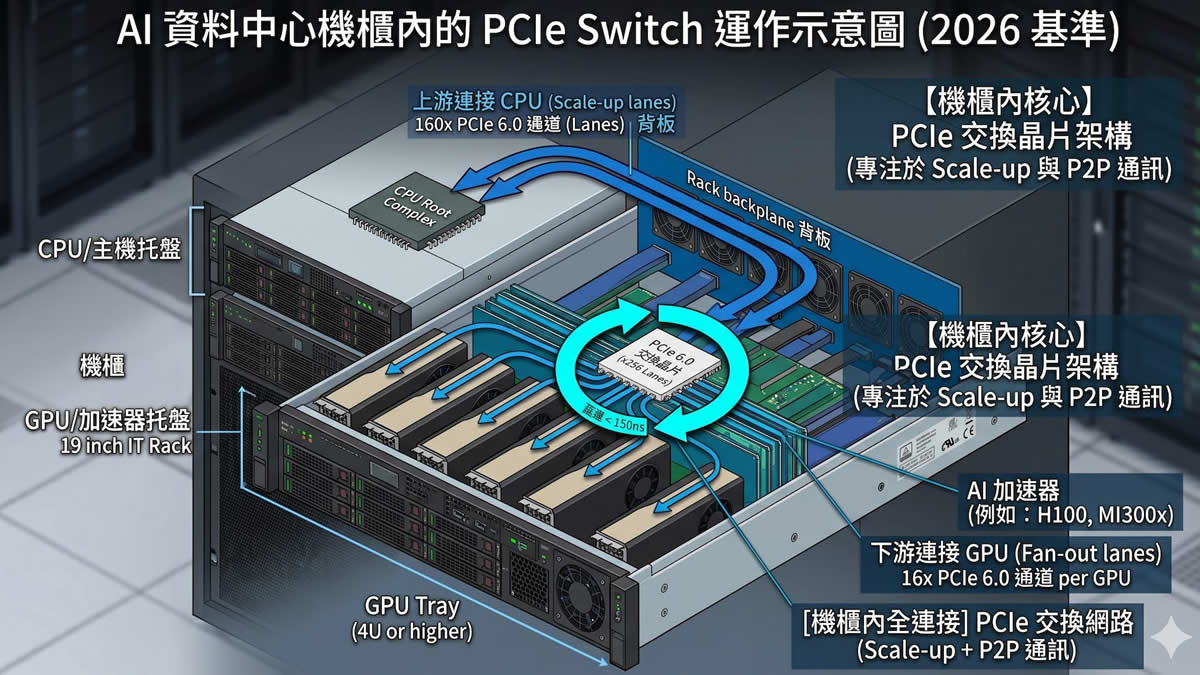
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP