
AI应用的性能并不只取决于GPU有多少计算核心,也不只是看芯片标称的算力。对于很多训练和推理任务来说,数据能否及时到达计算单元,同样决定了硬件到底能够发挥多少性能。
GPU最擅长的是大规模并行计算,但它通常不能直接把CPU系统内存当成自己的本地高速显存使用。当一个计算任务需要的数据位于CPU内存,而下一阶段计算必须在GPU上完成时,就需要经过CPU内存、PCIe或者其他互联链路把数据送到GPU显存。反过来,如果GPU计算完成后又必须把结果交给CPU处理,同样会产生数据移动。
问题并不是“复制”这个动作本身有多神秘,而是不同内存层级之间存在明显的带宽和延迟差异。GPU的本地显存通常具有很高的内存带宽,而CPU内存、PCIe、网络以及存储设备各自具有不同的性能特征。当一个程序频繁跨越这些层级移动数据时,计算速度很快的GPU反而可能在等待数据。
以PCIe为例,PCIe 4.0 x16的单向理论带宽大约为32 GB/s,PCIe 3.0 x16则大约为16 GB/s。这里说的是接口的理论传输能力,并不意味着任何应用都能达到这个数字。实际吞吐量还会受到设备、主板拓扑、传输大小、驱动、内存类型以及程序访问方式等因素影响。
因此,不能简单拿PCIe带宽与GPU显存带宽进行比较,然后得出“PCIe一定是AI系统瓶颈”的结论。很多训练任务会把模型参数、激活值和梯度尽可能保存在GPU显存中,计算过程中并不会每执行一个算子就从CPU内存重新复制一次数据。只有当模型采用CPU offload、数据准备跟不上GPU、显存不足或者应用存在频繁的主机与设备交互时,CPU-GPU数据传输才可能成为突出瓶颈。
另一个容易混淆的问题是GPU之间的通信。
在多GPU训练中,数据并不一定需要经过CPU。现代服务器通常提供GPU之间的高速互联,例如NVLink,具体带宽取决于GPU型号、互联代际以及服务器拓扑。对于分布式训练,还可能通过高速网络和RDMA进行GPU之间的数据交换。
RDMA的价值在于让网络设备能够直接访问内存中的数据,减少传统网络路径中的CPU参与和数据复制。但RDMA并不意味着“网络完全绕过CPU,也不需要PCIe”。实际系统仍然受到GPU、NIC、PCIe根复杂体、内存以及交换机拓扑等多个环节限制。对于支持GPU Direct RDMA的系统,NIC可以直接与GPU显存进行数据交换,从而进一步减少CPU内存作为中间缓冲区的需求。
这也是为什么大型AI集群的性能优化不能简单归结为“减少CPU到GPU复制”。当GPU数量增加以后,GPU之间的通信、网络拥塞、同步等待以及通信拓扑都可能成为重要因素。
训练数据加载则是另一个完全不同的问题。
假设训练数据存放在NVMe SSD上,程序需要先从存储设备读取数据,再经过CPU内存,最后把处理后的batch传输到GPU。这里存在一条数据路径:存储设备、CPU内存、GPU显存,然后才进入GPU计算。
如果数据读取、解码和预处理速度跟不上GPU消费速度,GPU就可能出现空闲。解决办法通常不是简单地把“所有数据一次性放进GPU显存”,因为大型训练数据往往远远超过显存容量。更常见的方法是使用数据预取、批处理、多线程或多进程数据加载、CPU缓存以及异步Host-to-Device传输,让下一批数据在GPU计算当前batch时提前准备。
Pinned Memory,也就是页锁定主机内存,在CUDA数据传输中也有重要作用。使用合适的页锁定内存可以让主机与GPU之间的数据传输更加高效,并配合异步复制实现计算与传输的重叠。但它并不是“固定内存地址”这么简单,也不是使用得越多越好。页锁定内存会占用操作系统管理下的物理内存资源,因此需要根据数据加载方式合理使用。
异步传输的价值也不只是让复制速度变快。
如果CPU正在准备下一批数据,而GPU正在计算上一批数据,两者可以在一定程度上并行工作。这样即使数据传输本身需要时间,也可以把部分传输延迟隐藏在GPU计算时间里面。
因此,AI性能优化经常追求的不是让数据移动完全消失,而是让数据移动与计算重叠,使GPU尽可能少等待。
推理服务同样存在类似问题,但具体表现与训练不同。
例如一个在线推理系统收到请求以后,如果输入数据需要频繁在CPU和GPU之间来回转换,或者模型被拆分在不同设备上,就可能增加延迟。对于高并发推理,还要考虑batching、请求调度、显存容量以及KV Cache等因素。
KV Cache本身并不是简单的“减少数据搬运”技术。它主要通过保存已经计算过的注意力相关状态,避免生成每一个新token时重复计算过去的部分。这样可以降低重复计算,但代价是需要占用GPU显存,而且随着上下文长度、并发请求、模型层数、KV head数量和数据类型变化,KV Cache的规模也会发生明显变化。
因此,不能简单规定“2048个token就需要多少GB KV Cache”,也不能把KV Cache直接等同于CPU-GPU数据复制优化。对于大型推理服务,如何让KV Cache留在合适的高速内存层级、如何管理显存,以及如何在不同请求之间调度这些缓存,才是更实际的工程问题。
模型量化也属于类似情况。FP16、BF16、FP8以及更低精度的数据类型可以减少模型参数和部分中间数据占用,从而降低显存压力和内存带宽需求。但量化的主要作用并不是直接减少CPU和GPU之间的复制次数,而是减少数据规模,并可能提高计算和内存访问效率。具体收益还取决于硬件、算子和模型。
对于多GPU和多节点训练,数据移动的问题则进一步扩大成通信问题。
以AllReduce为例,训练过程中不同GPU需要交换梯度或者其他状态。随着GPU数量增加,通信量、同步时间以及网络拓扑的重要性都会提高。Ring AllReduce等算法并不是随着GPU数量呈指数增长,而是通过特定的数据分片和通信步骤完成聚合。真正影响大规模训练效率的因素包括通信带宽、网络延迟、节点之间的连接方式、交换机拥塞以及GPU计算和通信之间能否有效重叠。
这也是为什么大型AI服务器会非常重视GPU、NIC和CPU之间的拓扑关系。即使两台机器拥有相同型号的GPU,如果GPU到GPU、GPU到NIC的物理连接路径不同,也可能产生不同的通信性能。
实际工程中,减少数据移动通常应该从数据流开始分析,而不是看到GPU利用率低就立即增加GPU数量。
第一步是确认GPU到底在等待什么。可以观察GPU利用率、显存使用、CPU利用率、PCIe传输、数据加载时间以及网络通信情况。如果GPU计算利用率很低,但CPU持续进行数据解码和预处理,那么问题可能在输入流水线,而不是GPU算力不足。
如果GPU利用率正常,但Host-to-Device传输占据大量时间,则应该检查batch大小、数据布局、Pinned Memory和异步复制策略。
如果单机多GPU之间通信时间明显增加,则应该检查GPU互联和PCIe拓扑,而不是继续优化CPU到GPU的数据复制。
如果多节点训练中通信占据大量时间,则应该进一步检查网络、RDMA、NIC到GPU的连接、AllReduce策略以及通信与计算的重叠程度。
如果模型因为显存不足而频繁进行CPU offload,那么问题又回到了内存层级设计。此时需要考虑模型量化、batch大小、序列长度、显存管理、分片以及offload策略,而不是单纯提高PCIe带宽。
从更大的角度看,AI系统的数据路径通常是一条多层级链路:存储设备到CPU内存,CPU内存到GPU显存,GPU显存到GPU显存,GPU到网络,以及网络到其他节点。每一层都有自己的带宽、延迟和容量限制。
性能优化的关键,是找到当前工作负载中最慢或者最容易造成等待的那一段。
如果GPU本身已经被计算任务充分利用,那么减少一次无关紧要的CPU-GPU复制可能没有明显效果。相反,如果GPU因为等待输入数据而频繁空闲,那么优化数据预取和Host-to-Device传输可能带来明显收益。
因此,GPU与CPU之间的数据复制确实可能成为AI应用的瓶颈,但它只是整个数据移动体系中的一个环节。对于现代AI系统,更准确的思路不是简单追求“少复制”,而是让数据尽量停留在合适的内存层级,让必要的数据传输与计算并行进行,并根据GPU、CPU、PCIe、网络和存储设备的实际拓扑安排数据路径。
当模型规模从单GPU扩展到多GPU,再扩展到多节点集群以后,性能问题也会从单纯的内存复制逐渐演变成整个计算、内存、互联和网络系统之间的协同问题。只有把完整的数据流画出来,再用实际性能指标找到等待发生的位置,优化才有可能落到真正影响吞吐量和延迟的地方。
GPU 与 CPU 之间的数据复制为什么可能拖慢 AI 应用,如何减少不必要的数据移动
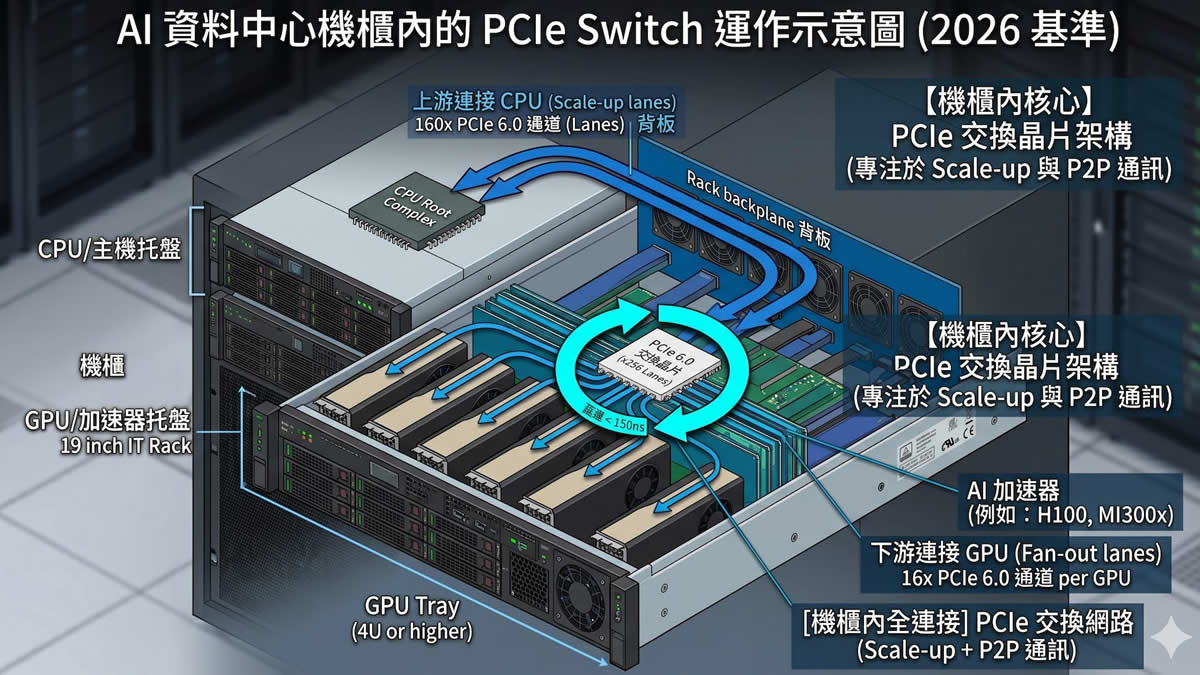
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP