
AI训练任务最麻烦的一种故障,并不是直接报错,而是昨天还跑得好好的,今天突然慢了一截。GPU没有死机,CUDA没有报错,训练程序也没有退出,只是每个step越来越慢。监控面板甚至可能显示GPU利用率还有七八十个百分点,看起来一切正常,实际上训练集群正在“集体等人”。
遇到这种问题,第一件事不是重启服务器,也不是马上增加GPU,而是先确定到底是哪一个环节变慢了。专业排查应该从训练吞吐量和step time开始,然后沿着数据加载、CPU预处理、GPU计算、GPU之间通信、节点之间网络以及存储一路往下追。核心思路只有一句话:找到时间到底花在哪里。
首先记录正常状态和异常状态下的step time、samples/sec或tokens/sec。如果原来每个step需要400毫秒,现在变成650毫秒,那么先不要猜原因。把这250毫秒拆开,看看是data loading等待、forward/backward计算增加,还是optimizer step和distributed synchronization增加。对于大语言模型训练,还应该关注tokens/sec、sequence length、padding比例以及有效token数量,因为“每秒样本数”并不能完整反映实际训练工作量。
数据输入往往是最容易被忽视的瓶颈。PyTorch的DataLoader如果worker数量不足、磁盘读取变慢、数据解压突然增加或者数据增强变重,GPU就会出现周期性的空闲。此时nvidia-smi可能显示GPU利用率不断从高位掉到低位,再重新升上去,看起来像GPU性能不稳定,实际上GPU只是在等CPU把下一批数据送过来。
排查时可以直接观察DataLoader等待时间、CPU利用率、worker状态和page cache命中情况。对于图像模型,还要检查JPEG或PNG解码、随机裁剪、颜色转换等CPU操作;对于LLM训练,则要检查tokenization、sequence packing、padding以及数据预处理是否突然发生变化。如果训练数据本身没有变化,却发现CPU预处理时间突然增加,就应该继续检查数据格式、worker进程、NUMA绑定和CPU频率,而不是先动GPU配置。
Batch size也需要重新确认,但不能简单地认为“显存使用超过70%就是危险”。现代深度学习框架通常会尽可能利用GPU显存,显存占用率高本身并不意味着计算效率下降。真正需要关注的是是否发生OOM、频繁的显存分配释放、memory fragmentation、activation checkpointing带来的额外计算,以及batch size或sequence length是否发生变化。
GPU层面的第一指标也不是单纯看utilization百分比。应该同时观察SM利用率、显存带宽、功耗、时钟频率、温度、PCIe吞吐量以及实际kernel执行时间。如果GPU utilization突然下降,同时CPU端在等待,问题可能在输入流水线;如果SM持续接近满载而step time却变长,则需要检查模型计算量是否增加、时钟是否下降以及kernel性能是否发生变化。
对于NVIDIA GPU,可以使用nvidia-smi查看基础状态,再根据问题严重程度使用Nsight Systems和Nsight Compute进行进一步分析。Nsight Systems适合观察整个训练过程的时间线,可以看到CPU线程、CUDA kernel、数据拷贝和通信事件如何排列;Nsight Compute则更适合深入单个kernel的occupancy、memory throughput和执行效率。
还要检查GPU是否出现降频。高温、功耗限制、散热问题或者硬件异常,都可能让GPU时钟下降。这里不能使用一个固定温度或者功耗数字判断“正常”还是“异常”,因为具体限制取决于GPU型号、机箱散热、功率上限和运行环境。最有价值的办法,是把异常节点与正常节点进行横向比较。
多GPU训练进入下一层就是通信。单机多卡和跨节点训练都可能受到NCCL通信影响。典型表现是GPU计算kernel结束以后,大量时间消耗在all-reduce、all-gather、reduce-scatter等collective operation上。此时GPU并不一定完全空闲,而是大量时间用于等待其他GPU或者其他节点。
NCCL_DEBUG等日志可以帮助确认通信路径和拓扑,NCCL Tests中的all-reduce、all-gather等测试则可以帮助判断硬件和网络通信性能是否偏离正常水平。排查时尤其应该比较正常节点和异常节点,而不是拿一个所谓“超过10毫秒就是故障”的固定标准套所有集群。
跨节点训练还要检查InfiniBand或RoCE链路、RDMA状态、PCIe、交换机端口错误、链路速率以及拥塞情况。网络问题有时并不会让程序直接报错,而只是让collective operation完成得越来越慢。某个节点的NIC降速、链路错误或者交换机端口异常,都可能让整个distributed job跟着变慢,因为同步训练最怕的就是“最慢的人决定大家什么时候继续”。
GPU之间的拓扑也非常重要。比如NVLink、PCIe以及不同NUMA节点之间的连接路径不同,GPU之间的数据传输成本可能差别很大。如果服务器更换过GPU、BIOS设置发生变化或者PCIe设备重新枚举,训练性能突然下降,就值得重新检查GPU拓扑。nvidia-smi topo -m能够提供一个很直接的起点。
存储则是另一条经常被误判的线路。训练数据从本地NVMe读取,和从NFS、Ceph或其他网络存储读取,瓶颈完全可能不同。不要只看磁盘“IOPS够不够”,因为训练到底受限于IOPS、吞吐量、平均延迟还是小文件数量,取决于数据访问模式。
例如数百万个小文件可能让元数据操作成为瓶颈,即使SSD的顺序读取带宽非常高也没有意义。相反,如果数据已经打包成大文件并进行顺序读取,吞吐量可能比IOPS更加重要。使用iostat、pidstat、fio以及文件系统自身的监控工具,可以进一步判断是设备、文件系统还是网络存储的问题。
NFS尤其需要关注网络延迟、吞吐量、客户端缓存和服务器端负载,但同样不能规定一个“5毫秒就是瓶颈”的万能数字。对于一个每step只读很少数据的训练任务,5毫秒可能完全不重要;对于大量小文件、频繁metadata操作的pipeline,远低于这个数字也可能造成明显等待。
还有一个非常容易被忽略的原因:训练任务本身发生了变化。
例如sequence length从2048变成4096,token数量增加,attention和activation计算都会明显变化;数据过滤规则改变,导致每个epoch实际样本数量变化;gradient accumulation调整,改变了optimizer和通信节奏;mixed precision配置发生变化,Tensor Core利用方式也可能不同。此时服务器和网络可能全部正常,只是“工作量”变大了。
因此,排查AI训练性能时最好建立一条固定的时间链:数据什么时候准备好,CPU什么时候完成batch,host-to-device copy花了多久,GPU kernel执行多久,NCCL collective花多久,optimizer什么时候结束,然后进入下一step。
如果时间线显示GPU kernel之间存在明显空洞,就去查数据和CPU;如果GPU一直计算但kernel本身变慢,就查GPU频率、计算量和kernel效率;如果大量时间停留在NCCL,就查GPU拓扑和网络;如果数据加载本身就在等待磁盘,就转向存储。这样排查的好处是,每一步都有证据,不需要靠“感觉GPU好像不够快”来猜。
对于突然发生的性能下降,最有效的办法往往还是做横向对比:同一份代码、同一个容器、同一个模型、同一个batch,在正常节点和异常节点各跑一次。如果只有一个节点慢,问题通常更容易缩小到硬件、驱动、PCIe、GPU、NIC或本地存储;如果所有节点同时变慢,则应该优先检查数据版本、训练参数、软件环境、共享存储和网络基础设施。
真正专业的AI训练性能诊断,最终不是寻找一个神奇的“GPU利用率低于多少就算故障”的数字,而是建立因果链。训练速度下降只是结果,数据加载、CPU预处理、GPU计算、显存访问、GPU间通信、网络和存储才是可能产生等待的地方。
所以,当一个AI训练任务突然从每秒几百个样本掉到几十个样本时,最有效的第一反应不是“换GPU”。先把正常和异常状态的step time拆开,再沿着数据、计算、通信、存储四条链逐项确认。只要能回答清楚“这一秒钟到底是谁在等谁”,训练性能问题通常就已经解决了一大半。
AI 训练速度突然下降时应该检查什么,数据、GPU、网络和存储如何逐层定位
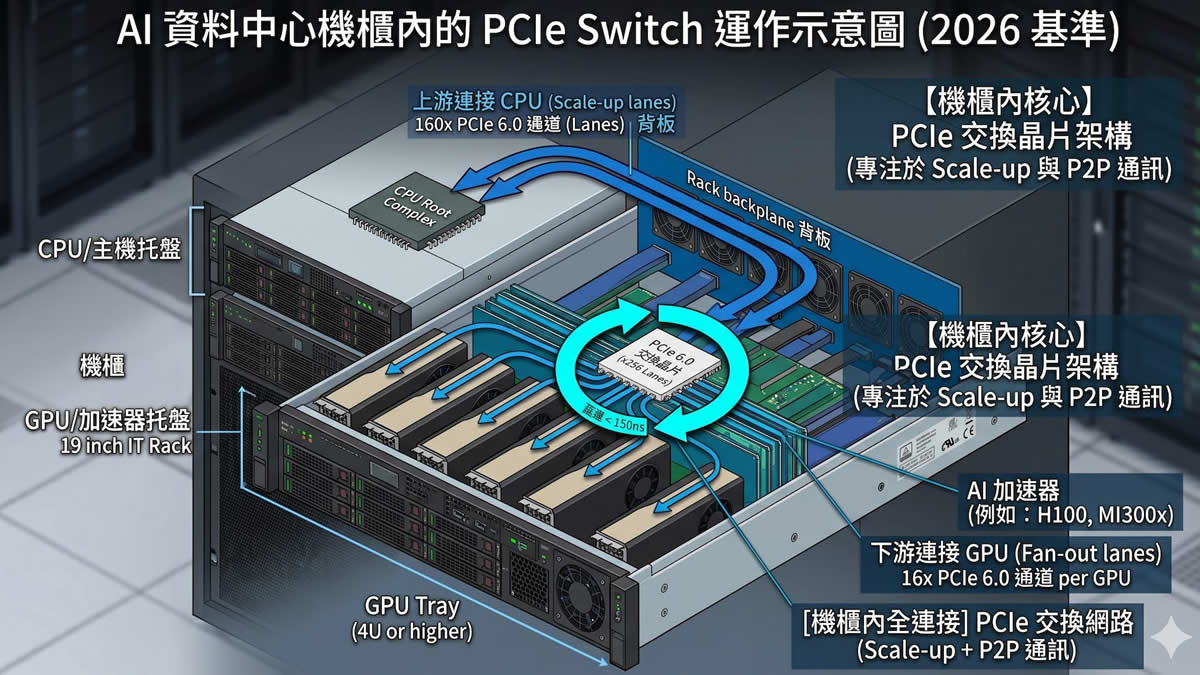
图片说明:示意图 图片来源:Public Domain(公有领域)

喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal):
https://www.paypal.me/observeccp
订阅中国观察电报 Telegram:
https://t.me/s/ObserveCCP