
AI 服务器中的内存带宽为什么重要,CPU 内存与 GPU 显存之间有哪些性能差异
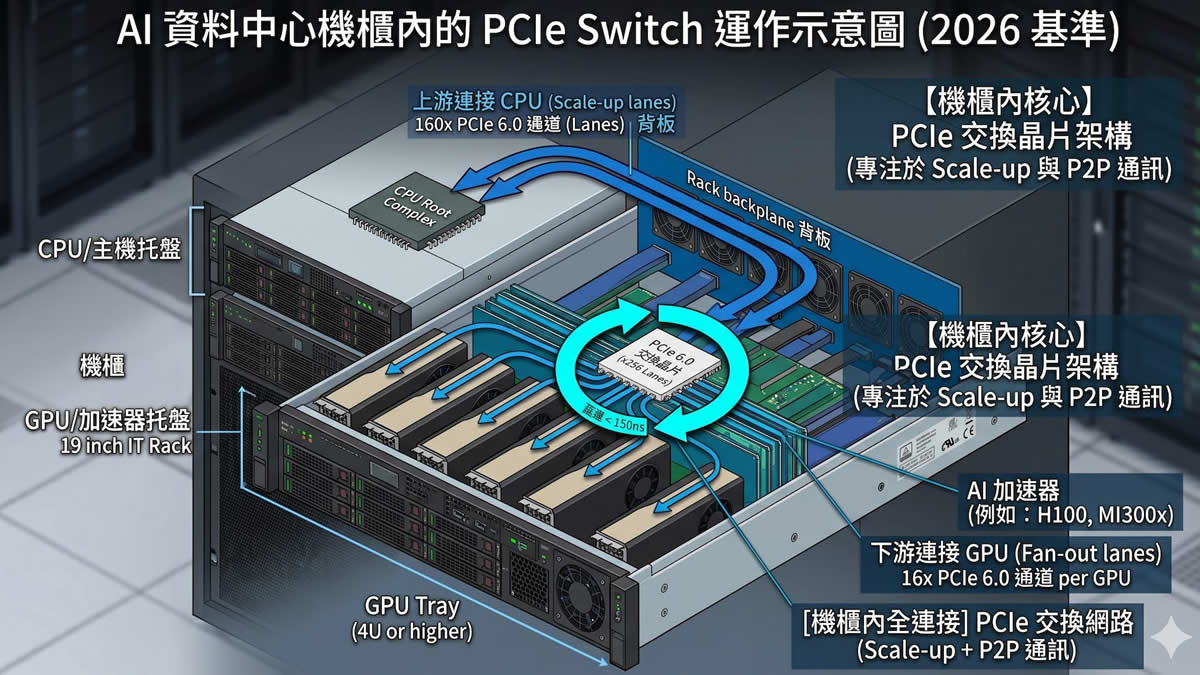
图片说明:示意图 图片来源:Public Domain(公有领域)
AI服务器的性能竞争,表面上看是GPU算力的竞争,实际上大量工作都发生在“数据搬运”上。
一个大模型训练或者推理任务运行起来之后,模型参数、激活值、输入数据、KV Cache以及中间计算结果,需要不断在不同层级的存储和计算单元之间移动。GPU即使拥有非常强的矩阵计算能力,如果数据不能及时送到计算单元,计算核心就可能处于等待状态。
这也是为什么AI服务器的硬件规格中,除了GPU数量和算力之外,内存容量、内存带宽、GPU显存容量、显存带宽、PCIe、NVLink以及GPU之间的互联带宽都会成为重要指标。
但这里有一个很容易产生的误解:CPU内存和GPU显存并不是两种简单的“快内存”和“慢内存”。它们服务的是完全不同的计算架构,性能差异必须放到整个数据流中理解。
CPU内存为什么需要大容量和较强带宽
服务器CPU使用的主内存通常是DDR5 RDIMM等类型。它的主要任务是为CPU提供容量较大的工作空间,同时承担操作系统、数据预处理、程序运行以及各种无法全部放进GPU显存的数据。
现代服务器CPU通常具有多个内存通道。以英特尔Xeon 6为例,部分处理器支持最多12个DDR5内存通道,并支持DDR5-6400以及更高速的MRDIMM方案。英特尔公布的Xeon 6资料显示,MRDIMM的数据传输速率最高可以达到8800 MT/s。
这里需要纠正一个常见概念。
Intel UPI并不是“CPU内存通道”。UPI是多路CPU系统之间的处理器互连,用来连接不同CPU插槽及其相关系统资源。真正决定CPU访问本地DDR内存带宽的是内存控制器、内存通道数量、内存速率以及具体服务器配置。
所以,评价服务器CPU内存性能时,不能简单写成“UPI提供了多少GB/s的DDR带宽”。
CPU内存的另一个重要特点是容量扩展能力。服务器可以配置数百GB甚至TB级系统内存,这一点对于AI数据预处理、大型数据集缓存以及CPU侧运行大型程序非常重要。
但容量大并不意味着GPU可以同样高效地使用这些数据。
GPU为什么需要HBM
GPU的计算方式和CPU完全不同。
CPU擅长复杂控制逻辑、分支判断以及大量不同类型的通用任务,而GPU拥有大量并行计算单元。AI模型中的矩阵乘法、向量运算等任务具有高度并行性,因此GPU可以同时处理大量数据。
问题是,这些计算单元需要非常大的数据吞吐量。
如果GPU计算能力越来越强,而显存提供数据的速度跟不上,新增的计算单元就可能无法得到足够的数据。于是GPU的峰值算力无法完全转化为实际应用性能。
这就是HBM受到AI产业高度重视的原因。
HBM通过3D堆叠和宽接口设计,在GPU封装附近提供非常高的内存带宽。现代AI加速器已经把HBM带宽做到数TB/s级。
例如,AMD Instinct MI300X配备192GB HBM3,峰值理论显存带宽达到5.3TB/s;NVIDIA H200则配备141GB HBM3e,显存带宽达到4.8TB/s。
这与普通服务器DDR5内存形成了数量级上的差异。
但这并不意味着HBM可以简单替代DDR5。
HBM的价值首先是给GPU提供极高的本地数据吞吐能力,而DDR内存则承担容量更大、扩展性更强的系统级工作空间。两者在AI服务器里通常是互补关系。
HBM为什么能够获得这么高的带宽
HBM的关键不是简单地把“内存频率提高很多”。
传统DDR内存主要依靠多个内存通道扩展带宽,而HBM采用非常宽的内存接口,并通过先进封装把多个DRAM die进行垂直堆叠,使GPU能够同时从大量存储通道获取数据。
因此,HBM的设计重点是“宽接口、高并行度和高带宽密度”。
这也是为什么不能用普通DDR内存的思路直接理解HBM。
HBM的巨大优势是带宽,而不是它在所有类型的访问上都一定拥有更低的延迟。原稿把GPU显存写成“10至30纳秒”,然后把原因归结为HBM通过TSV缩短信号路径,这种说法过于简单,也容易把带宽和延迟两个完全不同的指标混为一谈。
AI服务器最重要的问题其实是数据在哪里
假设一台AI服务器有大量CPU内存,但模型实际运行在GPU上。
CPU负责读取训练数据,然后将数据送往GPU。数据通常需要经过主机内存、PCIe等I/O路径进入GPU显存。这个过程的速度和延迟都会影响GPU能否持续获得数据。
如果CPU侧数据处理速度跟不上GPU,GPU就可能出现空闲。
但这并不意味着“CPU内存带宽不够”一定是问题。
瓶颈可能来自数据解码、数据增强、文件系统、NVMe存储、PCIe传输、CPU线程调度、内存NUMA拓扑、GPU显存访问模式,甚至训练框架的数据加载器。
因此,在AI服务器中讨论内存带宽,必须问第二个问题:数据正在从哪里流向哪里。
GPU显存带宽也不是越高越好
一个GPU拥有5TB/s甚至更高的显存带宽,并不意味着任何AI模型都可以获得相应比例的性能提升。
如果模型的主要瓶颈是计算量,增加显存带宽可能帮助有限。
如果模型属于典型的memory-bound workload,也就是大量时间花在从显存读取参数和中间数据,那么提高显存带宽就可能产生明显效果。
大型语言模型推理就是典型例子之一。
尤其是在较小批量、较长上下文以及解码阶段,GPU需要不断读取模型权重,并处理KV Cache等数据。此时,显存容量和显存带宽都可能成为重要限制。
NVIDIA在介绍H200时就特别强调了更大的HBM3e容量和更高的带宽对于大语言模型推理的作用,并指出更高显存带宽能够缓解部分memory-bound工作负载的瓶颈。
这也是为什么一张GPU的显存容量和显存带宽不能只看其中一个。
显存容量决定模型和数据能不能放进去,显存带宽则影响放进去以后能够多快地被计算单元持续读取。
GPU显存放不下模型,带宽再高也没有意义
这是AI服务器采购中一个非常重要的现实问题。
如果一个模型或者推理工作集无法放进单张GPU的本地显存,就需要进行模型切分、张量并行、流水线并行,或者采用其他内存管理方案。
一旦数据必须频繁跨GPU甚至跨服务器传输,问题就从“显存带宽”升级成了“GPU之间的互联带宽”。
这两个指标完全不是一回事。
例如AMD的MI300X单卡拥有192GB HBM3和5.3TB/s峰值显存带宽,同时平台内部还通过Infinity Fabric连接多张GPU。AMD公布的八GPU MI300X平台拥有1.5TB HBM3,并提供高达896GB/s的聚合双向GPU互联带宽。
这意味着八张GPU虽然各自拥有TB/s级的本地显存带宽,但GPU之间的数据交换走的是另一条互联链路。
如果一个分布式模型需要频繁交换大量数据,那么GPU本地显存再快,也不能完全掩盖GPU之间通信带宽和延迟的限制。
从单机到集群,瓶颈还会继续移动
当AI服务器从一台机器扩展到多台服务器,数据流又增加了一层。
单机内部可能是GPU与HBM之间的访问,以及GPU之间的高速互联。
跨服务器以后,还需要经过网络适配器和高速网络。
因此,大型AI集群实际上存在多层带宽:
GPU计算单元与HBM之间的显存带宽;
CPU与DDR内存之间的内存带宽;
CPU与GPU之间的PCIe等I/O带宽;
GPU之间的专用互联带宽;
服务器之间的网络带宽。
任何一层成为瓶颈,都可能限制最终训练或推理性能。
这也是为什么AI数据中心的服务器不能简单按照“买更多GPU”来建设。
GPU之间的通信能力同样决定扩展效率。现代HGX平台已经把GPU之间的高速互联和服务器网络作为整体架构设计的一部分。NVIDIA最新的HGX B300平台资料显示,八张GPU通过NVLink连接,同时每张GPU还可以配套800Gb/s网络连接。
NVMe也不是内存带宽的替代品
原稿把NVMe SSD和内存带宽放在一起比较,这容易让读者误以为只要SSD读取速度够快,就可以直接解决内存带宽问题。
实际上,SSD属于存储层,而DDR和HBM属于运行时内存层。
即使一块NVMe SSD拥有非常高的顺序读取速度,它也无法替代HBM为GPU提供实时、高吞吐的数据访问。
真正合理的架构是让不同层级各司其职。
数据长期存储在SSD或者其他存储系统中,需要运行的数据进入系统内存,再由计算任务将必要的数据送入GPU显存。对于重复使用的数据,可以通过缓存、预取和数据管线减少等待。
因此,AI服务器优化的核心不是把所有东西都换成最快的存储,而是让数据尽量少走昂贵、拥堵的路径。
量化也不仅仅是在“节省显存”
原稿提到INT8可以减少显存占用约4倍,这个说法需要加上条件。
如果单纯比较FP32和INT8,每个元素从32 bit降到8 bit,理论存储需求确实可以下降到四分之一。但大型语言模型实际使用的量化方案远比这个简单,权重、激活值和KV Cache可能采用不同的数据类型和量化策略,实际节省比例取决于具体实现。
量化带来的价值也不只是减少显存占用。
模型参数变小之后,需要从显存读取的数据量也可能下降,因此对于受内存带宽限制的工作负载,量化有机会同时改善显存访问压力和推理吞吐量。
但另一方面,量化还涉及精度、算子支持、解量化开销以及硬件Tensor Core能力,因此不能简单理解成“位数越低性能越高”。
真正决定AI服务器性能的是数据流
从工程角度看,内存带宽最重要的价值不是一个漂亮的TB/s数字,而是它能不能让计算单元持续工作。
一台AI服务器可能拥有非常强大的GPU,但如果训练数据从存储系统进入CPU内存的速度不够,GPU就会等待。
CPU内存带宽足够,如果PCIe传输成为瓶颈,GPU仍然可能等待。
PCIe速度足够,如果GPU之间需要大量同步而NVLink或者其他互联成为瓶颈,多GPU扩展效率仍然会下降。
即使所有外部链路都足够快,如果模型本身属于计算密集型任务,显存带宽增加也未必带来明显收益。
因此,真正的性能分析需要回答三个问题:计算单元在等待什么,数据目前在哪里,以及把数据送到计算单元需要经过哪些链路。
这也是AI服务器和普通PC最大的区别之一。
普通电脑升级内存,很多时候只是为了避免容量不足;而AI服务器的内存系统实际上是一套完整的数据供应链。DDR内存负责大容量系统工作空间,HBM负责GPU本地高带宽数据访问,PCIe负责主机与加速器之间的数据交换,GPU互联负责多加速器协同,网络则负责服务器之间的数据通信。
所以,AI服务器的性能不能用“GPU算力”或者“显存带宽”一个数字解释。
真正高效的AI系统,是让计算、内存、显存、I/O、GPU互联和网络尽可能保持平衡。对于训练和推理任务,最昂贵的状态往往不是GPU正在满负荷计算,而是花了巨额成本买来的GPU在等待数据。
未来AI硬件继续提高算力之后,这个问题只会更加突出。GPU计算能力增长得越快,内存和互联体系就越需要同步升级,否则服务器最终会从“算不动”变成“喂不饱”。这也是今天AI芯片竞争从单纯比较计算核心数量,逐渐转向HBM容量、显存带宽、封装、互联、内存体系和整个数据流架构竞争的原因。
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP