
一台普通服务器安装几十GB甚至上百GB内存,看起来已经相当充裕,但到了人工智能训练环境里,问题往往不再是“内存够不够”,而是“数据能不能足够快地送到计算单元”。
这也是为什么AI服务器的内存系统远比普通电脑复杂。CPU使用DDR内存,GPU拥有自己的显存,而高性能AI加速器通常采用HBM高带宽内存。训练过程中,数据会在存储、CPU内存、GPU显存以及GPU之间不断移动。很多时候,真正限制训练速度的并不是计算单元本身,而是数据搬运速度。
不过,“AI训练需要高速内存”并不意味着所有训练任务都需要极高的CPU内存带宽。不同阶段访问的数据不同,瓶颈所在的位置也不同。理解这一点,才能知道一台AI服务器到底应该把钱花在DDR内存、HBM容量、GPU互联还是高速存储上。
模型训练最基本的循环可以理解为数据准备、前向计算、反向计算和参数更新。实际框架会把这些步骤高度并行化,但从数据流动的角度看,这几个环节非常适合用来理解内存带宽问题。
数据首先来自数据集。数据集可能存放在本地NVMe SSD、网络文件系统、对象存储或者专门的数据服务器上。训练程序读取数据以后,通常要经过解压、解码、tokenization、数据增强、batch组装等处理,然后进入CPU内存,再通过PCIe等通道传递给GPU。
这一阶段最容易受到CPU内存带宽和CPU处理能力影响。
例如,训练图像模型时,CPU可能需要不断读取图像、解码JPEG、调整尺寸、执行数据增强并组织batch。训练大型语言模型时,则可能需要读取已经tokenized的数据、构造batch并执行各种预处理。
如果GPU已经处于等待状态,而CPU的数据加载线程却忙于解码,或者内存带宽已经接近极限,那么GPU即使拥有非常强大的计算能力,也只能“等数据”。
因此,数据加载阶段不能只看SSD速度。假设NVMe可以提供数GB/s甚至更高的读取速度,如果CPU解码、内存复制或者数据预处理跟不上,GPU仍然会出现利用率下降。
这也是为什么大型训练服务器通常会使用多线程DataLoader、prefetch、pinned memory以及数据预取等技术。目标并不是让GPU每次需要数据时才开始读取,而是提前把下一批数据准备好,让计算和数据传输尽可能重叠。
到了前向传播,情况就完全不同了。
Transformer中的矩阵乘法是训练大模型最主要的计算之一。GPU中的Tensor Core会执行大量矩阵运算,而权重和激活值通常首先位于GPU自己的高带宽内存,也就是HBM或者其他GPU显存中。
这里有一个非常重要的区别。
如果正在进行的是GPU上的矩阵乘法,那么主要承受巨大数据流量的通常是GPU内部的显存系统,而不是服务器CPU使用的DDR内存。
这就是HBM存在的意义。
传统DDR内存的带宽通常以几十GB/s到数百GB/s级别计算,而现代AI GPU的HBM带宽已经达到数TB/s级别。以NVIDIA的数据中心GPU为例,不同代产品的HBM容量和带宽差异很大。A100使用HBM2e,而更新一代的数据中心GPU已经采用HBM3、HBM3e等技术,带宽进一步提高。
GPU需要在极短时间内向大量计算单元提供权重、激活值以及中间数据。如果HBM供数速度不足,计算核心就可能出现等待。
这也是“算力”和“内存带宽”必须同时考虑的原因。
一块GPU拥有数百甚至上千TOPS或TFLOPS的理论计算能力,并不意味着任何程序都可以达到这个数字。如果程序需要频繁从显存读取大量数据,而计算量相对较低,就可能受到内存带宽限制。反过来,如果一个操作具有非常高的计算强度,数据加载以后可以在片上缓存和寄存器中进行大量计算,那么它更可能受到计算能力限制。
因此,不能简单地说“GPU越快,就必须配越快的CPU内存”。真正需要匹配的是数据在哪里,以及哪个计算单元正在访问这些数据。
反向传播则让内存系统面临更加复杂的压力。
训练神经网络时,前向传播产生的部分激活值需要保存下来,因为反向传播计算梯度时还要使用这些数据。大型Transformer尤其如此。随着batch size、序列长度和模型规模增加,中间激活可能占据大量显存。
反向传播不仅需要读取激活值,还需要读取权重并生成梯度。随后,优化器还需要维护和更新参数以及各种状态。
以Adam这类优化器为例,训练过程中需要维护额外的优化器状态。也就是说,一个模型的“参数量”并不能直接等于训练时需要的内存容量。训练通常还需要梯度、激活值、优化器状态以及其他临时缓冲区。
这也是为什么一个只有几十GB参数的模型,实际训练时可能需要远远超过几十GB的显存。
混合精度训练可以降低这种压力。FP16、BF16等格式能够减少部分数据的存储空间和内存流量,而FP32可能仍然用于某些需要更高数值精度的计算或状态保存。现代训练系统因此普遍采用混合精度,而不是要求所有数据始终使用同一种格式。
在这里还要区分“容量”和“带宽”。
HBM容量不够时,即使HBM带宽再高也无法解决问题。一个模型如果无法装进GPU显存,就必须采用模型并行、参数分片、激活检查点、CPU offload、GPU间通信等策略。
而如果数据能够放进HBM,但读取速度跟不上计算,那么问题才主要表现为带宽不足。
两者解决方案完全不同。
到了多GPU训练,问题又从GPU内部扩展到了GPU之间。
例如使用数据并行训练时,每张GPU会处理自己的mini-batch,然后需要进行梯度同步。AllReduce就是常见的集体通信操作。
这里需要特别避免一个误区:AllReduce并不意味着数据必须先经过服务器CPU内存。
现代AI服务器通常会尽可能让GPU之间直接通信。单机多GPU系统可能通过NVLink、NVSwitch等高速互联技术交换数据;跨服务器训练则可能通过InfiniBand或高速以太网等网络完成通信。
因此,分布式训练的通信性能通常更应该关注GPU互联带宽、网络带宽、通信拓扑以及通信库,而不是简单规定“CPU内存必须超过100GB/s”。
当然,CPU内存仍然非常重要。
如果GPU需要从CPU内存读取数据,或者训练框架进行了CPU offload,那么DDR内存带宽就会直接影响性能。模型参数、激活值或者优化器状态被频繁在CPU内存和GPU之间搬运时,PCIe带宽和CPU内存带宽都会成为重要因素。
这也是一种典型的“木桶效应”。
GPU有很高的HBM带宽,但PCIe通道不足;或者PCIe足够快,但CPU内存无法及时准备数据;又或者CPU内存和GPU都很快,却因为网络通信速度不够,导致多机训练等待同步。任何一层出现瓶颈,整体训练效率都会受到影响。
所以AI服务器实际上存在多个不同层次的内存与数据通道。
最靠近GPU计算核心的是寄存器、共享内存和片上缓存,然后是GPU显存,例如HBM,再往外是CPU内存,也就是DDR,之后才是NVMe SSD、网络存储以及对象存储。
越靠近计算核心,通常延迟越低、带宽越高,但容量和成本也更加有限。
这也解释了为什么现代AI服务器不会简单地使用一种“超级高速内存”解决所有问题。HBM负责让GPU高速计算单元获得数据,DDR负责CPU以及部分数据处理和offload任务,NVMe承担本地高速持久化数据,网络存储和对象存储则承担大规模数据集和长期数据保存。
真正高效的系统,是让数据尽可能停留在合适的层级。
例如,一个语言模型训练集可能存放在Cloud Storage或者其他对象存储中。训练任务开始后,数据可以通过高速网络进入训练节点,再由CPU进行预处理并进入GPU显存。频繁使用的数据还可以缓存到本地NVMe,进一步减少远程读取。
如果数据集只有几TB,而服务器拥有大量高速本地SSD,那么完全没有必要让每个训练step都去远程存储读取大量小文件。相反,把数据提前整理成适合顺序读取的大文件或shard,再配合预取和缓存,通常更加高效。
这也说明,AI训练性能不能简单用“SSD有多少GB/s”判断。
存储吞吐、CPU内存带宽、PCIe带宽、GPU HBM带宽以及GPU互联带宽,是不同层面的指标。某一层速度提高十倍,并不意味着训练速度也提高十倍。
举一个简单的例子。
如果GPU计算本身已经达到瓶颈,那么把CPU DDR从400GB/s提升到600GB/s,可能几乎没有明显收益。反过来,如果GPU经常因为DataLoader供数不足而处于低利用率状态,那么增加CPU核心、提高内存带宽、优化数据格式和预取机制,可能比升级更昂贵的GPU更有效。
同样,如果多GPU训练主要受AllReduce影响,那么继续升级服务器DDR内存可能没有多少帮助。此时应该观察GPU互联和网络通信是否成为瓶颈。
工程上最可靠的方法不是猜,而是测。
训练过程中可以同时观察GPU利用率、HBM使用量、显存读写、CPU利用率、系统内存带宽、PCIe流量、磁盘吞吐、DataLoader等待时间以及GPU之间的通信效率。如果GPU计算利用率长期很高,而且HBM带宽接近上限,那么GPU内存系统可能是瓶颈。如果GPU利用率不断出现空洞,而CPU和数据加载线程繁忙,则应该检查数据管道。如果多GPU训练时计算阶段结束后长时间等待同步,则需要分析通信链路。
对于AI服务器来说,“高速内存”从来不是一个孤立的硬件指标。
DDR决定CPU能够多快处理和准备数据,HBM决定GPU能够多快获取大规模计算数据,PCIe决定CPU与GPU之间的数据交换能力,NVLink等互联决定GPU之间如何协同,而高速网络则决定多个训练节点能否组成一个高效的计算集群。
模型越大、GPU越多,数据移动的重要性通常越明显。但这并不意味着所有训练任务都应该盲目追求最高带宽。计算密度、batch size、序列长度、模型结构、混合精度、并行策略以及数据处理方式都会改变瓶颈位置。
一台优秀的AI服务器,并不是把所有部件都堆到最高规格,而是让计算、内存、存储和网络形成平衡的数据通路。GPU没有因为等数据而闲着,CPU也没有为了喂饱GPU而持续做无意义的数据复制,网络通信也不会把大量计算时间消耗在等待同步上。对于大模型训练,最终决定效率的往往不是某一个参数有多漂亮,而是从数据进入系统到计算完成的整个链条有没有出现短板。
AI 服务器为什么需要高速内存,模型训练过程中哪些操作最依赖内存带宽
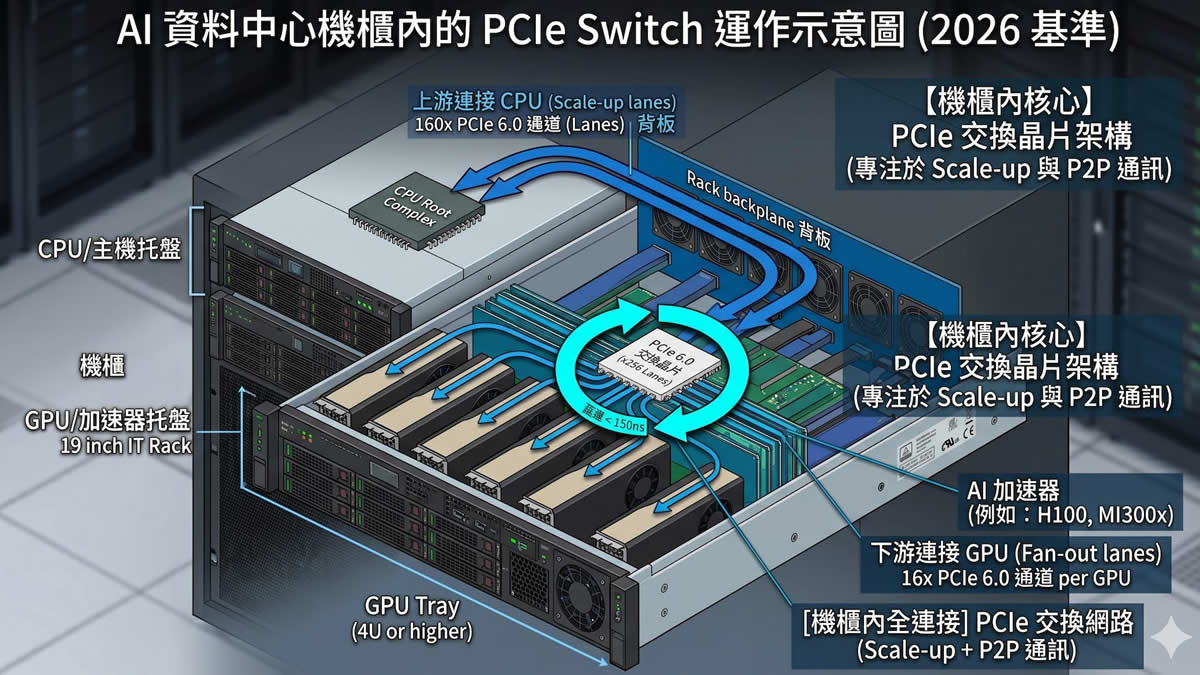
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP