
很多人第一次接触GPU容器时都会产生一个疑问:容器明明有自己的文件系统和用户空间环境,为什么里面运行的CUDA程序却能够直接使用宿主机上的NVIDIA GPU?难道容器把GPU驱动也装进去了吗?
实际上,GPU容器并不是把整套GPU硬件“虚拟搬进”容器,更不是简单地把宿主机驱动复制进去。它真正做的是把容器内的用户态CUDA程序、宿主机上的GPU内核驱动以及GPU设备文件连接起来,再由容器运行时把允许使用的GPU设备暴露给容器。
理解这一点以后,GPU容器的工作方式就清楚了。
一、GPU为什么不能像普通文件一样直接放进容器
Linux容器主要隔离的是进程、文件系统、网络、用户和资源控制等环境。GPU却是实际存在于宿主机PCIe总线上的硬件设备,它由宿主机Linux内核中的GPU驱动负责管理。
以NVIDIA GPU为例,宿主机需要安装对应的NVIDIA驱动。驱动中的内核部分运行在宿主机内核空间,负责与GPU硬件通信、处理中断、管理设备等。
因此,容器并不需要、也通常不会在自己的文件系统里重新加载一个独立的NVIDIA内核驱动。
真正发生的事情更接近于:宿主机负责控制GPU,容器中的应用获得访问这个GPU所需要的设备接口和用户态驱动库。
这也是GPU容器和传统虚拟机在这里一个很重要的区别。容器共享宿主机内核,而虚拟机通常拥有自己的客户机内核和完整的虚拟硬件环境。
二、NVIDIA Container Toolkit到底做了什么
NVIDIA Container Toolkit的核心作用,是让容器运行时能够正确地把NVIDIA GPU相关资源提供给容器。
在Docker等环境中,运行容器时可以通过GPU相关配置指定哪些GPU应该暴露给容器。例如常见的 --gpus 参数,最终由NVIDIA容器运行时根据配置完成设备和相关用户态组件的注入。
这里最容易产生误解的是“驱动注入”。
注入的重点并不是把宿主机的NVIDIA内核模块复制到容器里重新加载,而是让容器获得运行CUDA程序所需要的用户态驱动库、设备节点以及相关接口。
NVIDIA Container Toolkit的文档明确说明,容器中的驱动能力可以通过 NVIDIA_DRIVER_CAPABILITIES 控制,例如 compute 用于CUDA和OpenCL,utility用于NVML和 nvidia-smi,graphics则用于图形相关能力。
所以,一条比较准确的GPU访问链路可以理解为:
容器内CUDA程序 → 用户态CUDA/驱动库 → 宿主机GPU驱动接口 → /dev/nvidia*等设备节点 → NVIDIA GPU。
容器本身并没有获得一块独立的GPU,它只是获得了访问宿主机GPU所需要的接口。
三、为什么容器里面能够看到 /dev/nvidia0
Linux中的设备文件是访问硬件的重要入口。
在安装NVIDIA驱动的宿主机上,通常可以看到类似 /dev/nvidia0、/dev/nvidiactl、/dev/nvidia-uvm等设备节点,具体设备节点会随着驱动版本和功能不同而有所变化。
如果这些设备没有正确暴露给容器,即使容器里面安装了CUDA程序,也无法正常访问宿主机GPU。
因此GPU容器启动过程中,一个重要步骤就是根据运行时配置,把允许使用的GPU设备以容器可以访问的方式提供进去。
现代NVIDIA Container Toolkit还支持通过CDI等机制描述和注入设备,这说明GPU容器的设备暴露已经不只是简单地手工写几个Linux设备节点。
Kubernetes的NVIDIA Device Plugin同样承担类似的资源发现和分配工作。它可以向Kubernetes节点报告GPU资源,并在Pod创建时把相应设备提供给容器。Kubernetes Device Plugin机制本身就是为了让厂商设备能够向kubelet注册资源并把具体设备分配给容器。
四、CUDA镜像里为什么经常有CUDA库,却没有完整GPU驱动
这是GPU容器最容易让初学者困惑的地方。
很多CUDA容器镜像里面已经包含CUDA Runtime、数学库、深度学习框架以及其他用户态组件,但这并不意味着容器自己拥有完整的GPU内核驱动。
例如,一个深度学习镜像可能包含PyTorch、CUDA Runtime、cuDNN等软件,而真正负责直接控制GPU硬件的NVIDIA内核驱动仍然运行在宿主机。
容器启动时,NVIDIA Container Toolkit根据宿主机环境和容器需要,把相应的驱动用户态库等组件提供给容器。
因此,GPU容器通常形成一种“用户空间随镜像、内核驱动随宿主机”的结构。
这也是为什么GPU容器的CUDA兼容性不能简单理解成“宿主机和容器必须安装完全相同版本的CUDA”。
真正需要关注的是宿主机NVIDIA驱动版本、容器内CUDA Runtime以及应用所要求的兼容关系。
五、容器获得GPU以后,是不是就拥有了完整的GPU控制权
不是。
GPU设备能够被容器访问,并不等于容器自动拥有GPU的全部权限。
运行时首先需要决定哪些GPU可以被看到。例如一台服务器有8块GPU,一个容器可能只被分配GPU 2和GPU 5。
容器中的应用随后只能在运行时提供的设备范围内使用GPU。
在Kubernetes环境中,这一步通常由NVIDIA Device Plugin等设备插件参与完成。插件可以向Kubernetes暴露 nvidia.com/gpu 等资源,并根据Pod的资源请求把相应GPU分配给容器。
因此这里应该区分三个概念:GPU发现、GPU分配和GPU实际执行。
Kubernetes负责资源调度和设备分配框架,设备插件负责向系统报告GPU并执行设备分配,而CUDA和NVIDIA驱动负责GPU程序真正的运行。
不能简单地把所有这些功能都称为“Kubernetes GPU调度器”。
六、GPU容器的资源隔离没有CPU容器那么简单
CPU资源可以比较自然地通过CPU配额、cpuset等机制进行控制,但GPU资源复杂得多。
例如两个容器同时使用同一块GPU,并不意味着每个容器天然获得50%的GPU计算能力和50%的显存。
CUDA进程可以在同一块GPU上建立不同的Context,而GPU最终仍然只有一套物理计算资源和显存。
因此,如果多个工作负载共享一块GPU,它们可能发生计算资源、显存、显存带宽以及其他硬件资源的竞争。
“CUDA Context负责显存带宽动态分配”这样的说法并不准确。Context主要用于管理GPU进程执行环境和相关状态,并不是一个通用的GPU资源配额系统。
真正需要资源隔离时,要根据GPU型号和工作负载选择不同技术。
七、MIG和Time-Slicing解决的是不同问题
现代NVIDIA GPU环境中,GPU共享已经不能简单概括为“多个容器共享一张卡”。
例如支持Multi-Instance GPU(MIG)的GPU,可以把一张物理GPU划分为多个相对独立的GPU实例,每个实例具有指定的计算和显存资源。
在Kubernetes中,NVIDIA Device Plugin可以通过MIG策略向集群暴露不同的MIG资源,例如不同容量的GPU实例。
另一种方法是CUDA Time-Slicing。
Time-Slicing允许多个工作负载交替使用同一GPU的计算资源,但它并不自动提供严格的显存隔离。NVIDIA官方Device Plugin文档明确指出,使用Time-Slicing时,共享工作负载处于相同的GPU故障域,某个工作负载发生问题可能影响共享同一GPU的其他工作负载。
MPS又是另一种机制。NVIDIA Device Plugin目前支持通过MPS进行GPU共享,MPS可以对共享资源进行更明确的计算和显存资源管理。
因此,MIG、Time-Slicing和MPS不能简单看成同一种“GPU虚拟化”。
八、GPU容器为什么通常接近原生性能
容器GPU计算性能通常能够非常接近直接在宿主机上运行,重要原因就在于它没有把每条GPU指令都转换成一种完全虚拟的GPU指令。
GPU应用仍然通过NVIDIA驱动访问真实GPU硬件,容器主要负责隔离用户空间和进程环境。
因此,对于CUDA计算本身,容器化并不等于传统意义上的完整硬件虚拟化。
但是,“接近原生性能”不代表所有工作负载都没有额外成本。容器启动、镜像拉取、模型加载、CPU到GPU的数据复制、GPU间通信、PCIe带宽、NUMA拓扑以及网络存储等都可能成为实际瓶颈。
尤其是多GPUAI训练环境,真正影响性能的往往不是“容器”三个字,而是GPU之间如何通信。
九、GPU之间的数据传输不能简单归结为容器网络
原文把“容器间GPU数据传输的网络延迟”列为GPU容器的一般问题,这个说法容易误导。
如果两个进程位于同一台服务器,它们之间的GPU数据交换可能涉及GPU显存、PCIe、NVLink、共享内存以及具体通信库,而不一定经过容器网络。
例如多GPU训练常使用NCCL进行GPU间通信,其性能会受到GPU拓扑、PCIe、NVLink、NIC以及NUMA布局等影响。
只有当工作负载真正跨主机通信时,网络才成为主要的数据传输路径之一。
因此,分析GPU集群性能时,应该把“容器网络”和“GPU互联拓扑”分开看。
十、GPU容器真正困难的地方在于资源生命周期
GPU容器真正复杂的地方,不只是“让容器看到GPU”,而是让GPU资源从节点启动一直到任务结束都能够稳定工作。
例如一个Kubernetes GPU节点可能经历:
GPU硬件初始化 → NVIDIA驱动加载 → 容器运行时配置 → Device Plugin注册 → Kubernetes发现GPU → Pod调度 → GPU设备分配 → 容器启动 → CUDA初始化 → 模型加载 → GPU计算。
任何一个环节出现问题,都可能表现为“容器不能使用GPU”。
大型GPU集群还需要进一步考虑GPU型号差异、MIG配置、GPU拓扑、NUMA、驱动版本、CUDA兼容性、镜像大小、模型加载时间以及GPU节点启动速度。
这也是GPU自动扩缩容比普通CPU节点复杂得多的原因。
GPU节点不是简单地“开一台机器,然后装个Pod”就结束。云平台创建GPU实例、操作系统启动、驱动初始化、容器运行时准备、Device Plugin注册以及模型加载,都可能增加从Pod Pending到真正开始计算的时间。
GPU容器真正的价值,并不是把GPU“虚拟成一个普通容器设备”,而是建立了一条稳定的资源连接链:宿主机内核和GPU驱动负责硬件,容器运行时负责设备与用户态驱动的注入,CUDA负责应用与GPU之间的计算接口,Kubernetes设备插件负责向集群暴露和分配GPU资源。
理解这条链以后,就不难解释为什么一个只有几百MB甚至几个GB的CUDA容器,可以调用服务器上价值数万美元的GPU,却不需要把完整的GPU内核驱动复制进镜像。
GPU容器的核心并不是“把硬件装进容器”,而是让容器获得访问真实硬件所需要的最小接口,同时把硬件控制权继续留在宿主机和驱动层。到了Kubernetes环境,这个问题又进一步扩展成GPU发现、设备分配、资源共享、故障隔离和集群调度。真正成熟的GPU基础设施,最终解决的也不是“容器能不能看到GPU”,而是怎样让有限的GPU计算资源在安全、可观测和可预测的条件下被多个工作负载稳定使用。
GPU 容器是怎样工作的,容器为什么能够访问宿主机 GPU
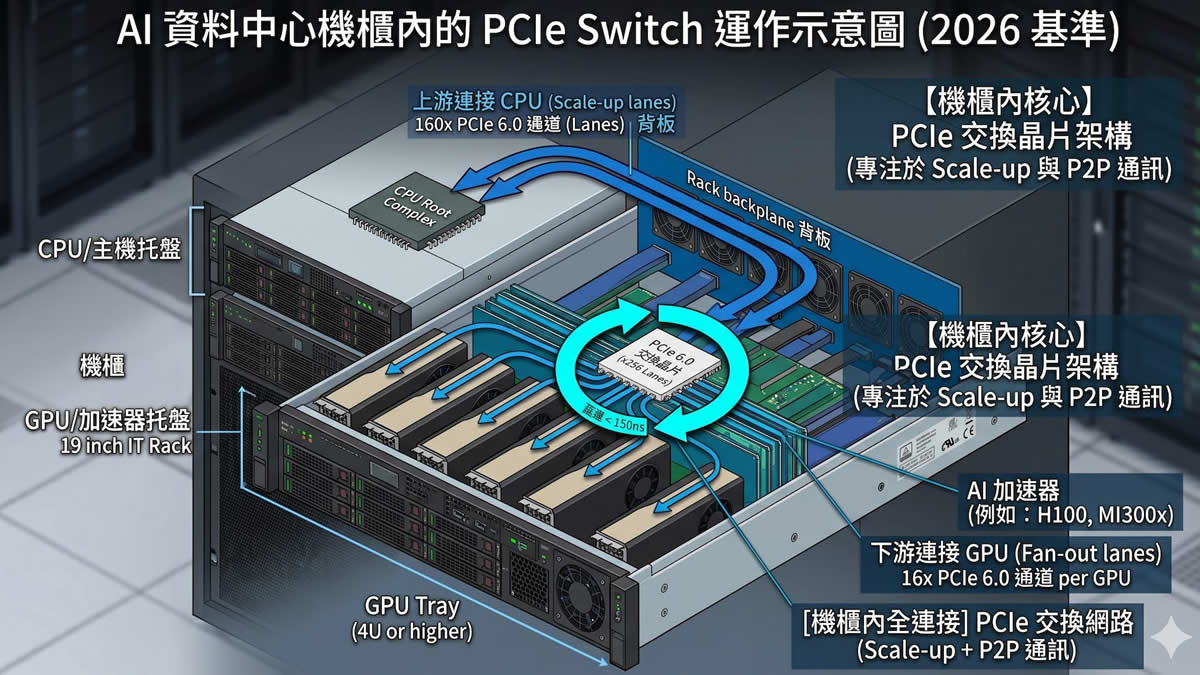
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP