
Kubernetes调度CPU时,通常可以把CPU理解为一组可以切分、超卖和按请求分配的计算资源;GPU则不同。一块GPU不仅包含计算单元,还拥有固定容量的显存以及特定的GPU间互联结构。对于AI训练和推理任务来说,究竟应该把哪个GPU分配给哪个Pod,不能只看“还有几块GPU”,还要考虑GPU型号、显存容量、GPU之间的通信拓扑以及任务本身的资源需求。因此,GPU调度通常比CPU调度复杂得多。
首先需要澄清一个经常出现的误解:Kubernetes原生调度器并不会像管理CPU和系统内存那样直接管理GPU显存。以常见的nvidia.com/gpu扩展资源为例,Pod请求nvidia.com/gpu: 1,主要表达的是需要一块GPU设备。Scheduler根据节点上报告的GPU可分配资源选择节点,而不是实时读取每块GPU已经使用了多少GB显存,再根据这个数字决定是否调度。
这意味着,一个节点可能还有一块尚未分配给Pod的GPU,但Pod启动以后仍然可能因为模型本身需要更多显存而发生CUDA Out Of Memory。Kubernetes Scheduler并不会自动知道这个模型需要多少显存,也不会因为某个模型过去使用过30GB显存,就自动为下一次运行预留30GB。显存需求通常需要由应用配置、GPU型号、模型规模、batch size、精度以及实际工作负载共同决定。
GPU显存还有一个特点,就是容量属于具体硬件。CPU节点可以通过多个内存模块增加容量,也可以使用虚拟内存等机制缓解部分压力,而GPU显存通常是固定的。例如一块24GB GPU并不会因为Pod请求了32GB显存就自动扩展到32GB。模型加载、激活值、中间张量、CUDA runtime以及其他GPU进程都可能消耗显存,因此“GPU数量足够”并不等于“任务一定能够运行”。
这也是为什么GPU共享必须与普通GPU分配区分开来。最简单的方式是一块GPU分配给一个工作负载,这时资源模型比较清楚;如果需要让多个工作负载共享GPU,则必须使用具体的共享技术。例如支持MIG的GPU可以通过Multi-Instance GPU把物理GPU划分为多个硬件隔离的GPU实例;Time-Slicing则允许多个工作负载共享GPU执行时间,但它与MIG的资源隔离方式不同。
因此,不能简单写成“使用Kubernetes LimitRange和ResourceQuota就可以限制容器的显存上限”。这些Kubernetes机制主要用于管理Pod和Namespace层面的资源请求、限制以及配额,并不会自动把一块NVIDIA GPU的显存切割成若干个独立的显存资源。GPU显存的具体隔离能力取决于GPU硬件和相应的软件机制。
cgroups也不能简单承担这个任务。cgroups对于CPU、系统内存等资源具有明确的控制能力,但传统意义上的nvidia.com/gpu: 1并不是通过cgroups把一块GPU切成“20%的计算能力+8GB显存”。如果业务需要更细粒度的GPU资源管理,就需要使用MIG、Time-Slicing、MPS或者其他GPU资源管理机制,并根据具体实现检查其隔离和调度语义。
GPU调度的第二个难点来自硬件拓扑。假设一台服务器安装了8块GPU,这8块GPU并不一定彼此等价。它们可能通过PCIe连接,也可能通过NVLink、NVSwitch形成更高速的GPU互联结构。对于单GPU推理任务,这种差异可能不明显;但对于分布式训练任务,多块GPU之间需要频繁交换梯度和张量数据,此时GPU之间的通信路径就会直接影响整体性能。
尤其是在使用NCCL进行AllReduce等集合通信时,GPU之间的拓扑非常重要。两块GPU之间如果存在高速NVLink连接,通信条件可能与必须经过PCIe甚至跨NUMA节点的路径完全不同。大型服务器还需要同时考虑CPU socket、NUMA、PCIe Root Complex、NIC以及GPU之间的关系。对于跨服务器训练,还需要进一步考虑高速网络、RDMA以及网络拓扑。
这里还要区分两个概念:GPU显存带宽和GPU之间的互联带宽。HBM或GDDR决定GPU访问自身显存的数据带宽,而NVLink、NVSwitch和PCIe主要描述设备之间的数据传输路径。一个任务“需要很高的显存带宽”和“需要高速GPU-GPU通信”并不是同一件事情。因此,不能简单地根据所谓“高显存带宽任务”去选择NVLink,而应该根据任务的内存访问特征和GPU间通信模式分别分析。
普通Kubernetes Scheduler能够处理GPU扩展资源,但并不会自动理解所有复杂的GPU拓扑。实际生产环境中,可以利用节点标签、Node Affinity、Topology Spread等机制表达部分硬件约束;对于更复杂的GPU设备选择,则可以采用专门的GPU调度扩展和资源管理机制。NVIDIA近年来也提供了DRA Driver for NVIDIA GPUs,用于比传统扩展资源模型更加细粒度地描述和选择GPU设备。
因此,一个需要4块GPU的训练任务,并不只是“找一台还有4块GPU的机器”这么简单。如果这4块GPU分布在不同的PCIe拓扑区域,或者GPU之间缺少理想的高速互联,那么任务虽然能够启动,AllReduce通信效率却可能明显不同。对于大模型训练来说,调度器最终需要考虑的是“4块GPU是否能够组成适合这个任务的资源集合”,而不仅仅是GPU数量。
GPU监控也需要特别注意。DCGM、DCGM Exporter、Prometheus等工具可以提供GPU利用率、显存使用量、温度、功耗以及其他设备指标。这些数据对于运维非常重要,但“监控到GPU显存使用量”和“Scheduler根据实时显存自动调度”是两件不同的事情。前者属于监控体系,后者需要额外的调度器扩展、指标适配或应用层资源管理。
例如,一个推理服务可能长期只使用GPU计算能力的一小部分,却占据了大量显存;另一个任务可能显存占用不高,却持续进行大量计算。如果调度策略只看GPU utilization,就可能得到完全不同的结论。因此GPU资源管理不能只依赖一个百分比,而应该结合GPU数量、显存容量、实际显存使用、计算利用率、任务持续时间以及通信需求综合判断。
对于多GPU训练,还应该把GPU、CPU和网络放在一起看。一个Pod获得了4块GPU,并不意味着CPU、内存、NIC和GPU之间的拓扑天然适合它。如果数据预处理全部集中在某个CPU NUMA节点,或者高速网络接口距离GPU较远,最终瓶颈可能根本不在GPU本身。AI基础设施中的性能问题经常发生在GPU之间、GPU与CPU之间以及GPU与网络之间的连接路径上。
因此,GPU调度真正困难的地方不是“Kubernetes不会调GPU”,而是GPU资源本身具有明显的硬件属性。CPU调度更多关注可分配的计算资源,而GPU调度还必须面对固定显存、GPU型号差异、设备共享方式以及多GPU拓扑等问题。
实际部署时,可以把GPU调度理解成三个层次:第一层是资源数量,解决Pod需要几块GPU;第二层是资源类型,解决需要什么型号、多少显存以及是否需要MIG等GPU实例;第三层是资源拓扑,解决多块GPU之间以及GPU、CPU、NIC之间怎样连接。任务越偏向大规模分布式训练,第三层的重要性就越高。
最终,Kubernetes提供的是GPU资源编排的基础,而不是一套能够自动理解所有AI工作负载的万能GPU调度算法。真正成熟的GPU基础设施,需要把Kubernetes Scheduler、Device Plugin或DRA、GPU共享机制、NVIDIA Container Toolkit、NCCL、硬件拓扑以及DCGM监控结合起来。只有把“有没有GPU”进一步提升到“这块GPU是什么、显存够不够、怎样与其他GPU连接、任务真正需要什么”,GPU调度才真正进入AI基础设施的核心问题。
Kubernetes GPU 调度为什么比 CPU 调度复杂,显存和 GPU 拓扑应该怎样考虑
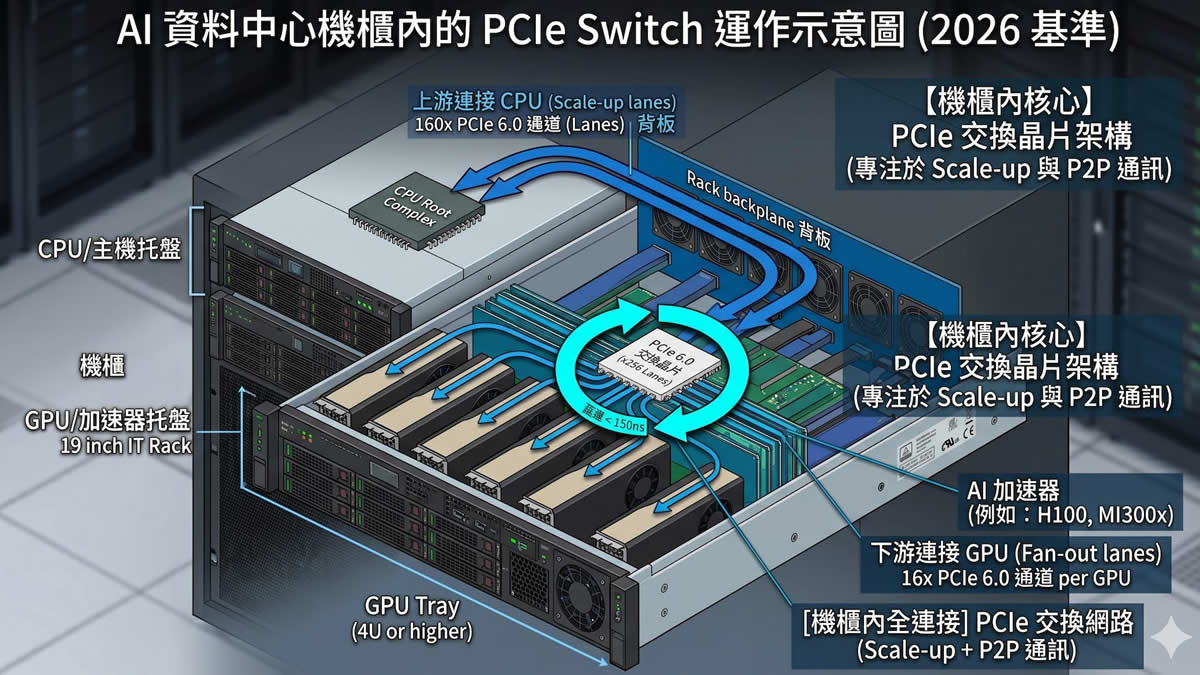
图片说明:示意图 图片来源:Public Domain(公有领域)

喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal):
https://www.paypal.me/observeccp
订阅中国观察电报 Telegram:
https://t.me/s/ObserveCCP