
Kubernetes 管理 AI 任务的 GPU 资源时,经常会把 ResourceQuota、requests/limits、节点选择和调度策略混在一起。实际上,它们解决的是不同层面的问题:Pod 的资源请求决定“这个任务需要多少 GPU”,ResourceQuota 决定“这个 Namespace 最多可以消耗多少资源”,而调度策略决定“满足条件的 GPU 到底应该放在哪台节点上”。如果把这几个概念混为一谈,集群很容易出现配额没有超限、GPU 却调度不到,或者 GPU 节点很多但任务始终无法获得合适拓扑的情况。
首先看单个 Pod 的 GPU 请求。对于 NVIDIA GPU,通常需要 NVIDIA Kubernetes Device Plugin 或 NVIDIA GPU Operator 向 Kubernetes 注册类似 nvidia.com/gpu 的扩展资源。任务可以这样声明:
resources:
requests:
nvidia.com/gpu: 1
limits:
nvidia.com/gpu: 1
这里的 1 表示该 Pod 需要一块 GPU。对于 GPU 这类不可超卖的扩展资源,实际使用时通常让 requests 与 limits 保持一致,而不是写成 requests: 1、limits: 2,然后期待 Kubernetes 在运行过程中自动允许 Pod 从一块 GPU 扩展到两块 GPU。GPU 与 CPU、内存的资源模型并不完全相同,因此不能套用普通 CPU limit 的理解。
如果一个训练任务需要四块 GPU,就应该直接请求四块:
resources:
requests:
nvidia.com/gpu: 4
limits:
nvidia.com/gpu: 4
Kubernetes 调度器随后会寻找能够同时满足这一资源请求的节点。这里还涉及一个重要问题:四块 GPU 是否必须位于同一台机器。如果训练框架要求节点内多 GPU 通信,就不能只看“集群还有四块 GPU”,而必须看单个节点是否具有足够的 GPU,以及 GPU 之间的 PCIe、NVLink 或 NVSwitch 拓扑是否适合该任务。
ResourceQuota 解决的是另一个层面的问题。它通常作用于 Namespace。例如:
apiVersion: v1
kind: ResourceQuota
metadata:
name: gpu-quota
namespace: ai-team
spec:
hard:
requests.nvidia.com/gpu: "10"
这样可以限制 ai-team Namespace 中所有 Pod 的 GPU 请求总量。这里有一个容易写错的地方:对于扩展资源配额,通常应该使用 requests.nvidia.com/gpu 这样的资源名称,而不能简单把 nvidia.com/gpu: 10 当成所有 Kubernetes 版本和配置下都适用的通用写法。
ResourceQuota 的作用是“控制这个 Namespace 能申请多少资源”,而不是告诉调度器“GPU 应该放到哪台机器”。例如一个团队拥有10块 GPU 的配额,并不意味着集群中已经预留10块 GPU 给它。如果其他任务已经把节点上的 GPU 占用,新的 Pod 即使没有超过 Namespace 配额,也可能因为没有满足条件的节点而进入 Pending 状态。
因此,ResourceQuota 与调度策略实际上是两个不同的问题。
调度策略首先解决节点选择。例如集群中同时存在 CPU 节点、A100 节点和 H100 节点,可以通过节点标签和 nodeSelector 或 Node Affinity 让任务进入指定 GPU 节点池:
nodeSelector:
accelerator: h100
更复杂的生产环境通常使用 Node Affinity,因为它可以表达“必须使用某类节点”或者“优先使用某类节点”等条件。
Taints 和 Tolerations 则适合解决反方向的问题。例如给 GPU 节点添加 taint:
accelerator=gpu:NoSchedule
没有对应 toleration 的普通 Pod 就不会被调度到这些节点。这样可以避免 Web 服务、日志组件或普通 CPU 任务跑到昂贵的 GPU 节点上。
PriorityClass 解决的是优先级问题,但也不能理解成“高优先级任务可以直接抢走正在运行的 GPU”。在资源不足时,Kubernetes 可以根据优先级和调度配置进行 Pod 抢占,但已经运行的 GPU 训练任务是否能够安全退出、保存 checkpoint,以及重新启动后从哪里恢复,是训练框架和任务系统需要解决的问题。对于长时间训练,checkpoint 和恢复机制往往比单纯设置 PriorityClass 更重要。
GPU 拓扑则是更专业的一层。对于分布式训练,不能只统计“还有多少 GPU”,还要考虑 GPU 是否在同一节点、GPU 与 NIC 的亲和关系,以及节点之间的网络带宽和 RDMA 路径。NVIDIA GPU Operator、Device Plugin、Node Feature Discovery 等组件可以帮助 Kubernetes 识别和暴露硬件资源,而具体的 GPU 拓扑感知能力则取决于 Kubernetes 版本、调度插件、硬件以及 NVIDIA 软件栈。不能简单写一个所谓的 nvidia.com/gpu-topology 标签,就认为 Kubernetes 已经完成了真正的拓扑优化。
这也解释了为什么一个 AI 集群可能出现这样的情况:Namespace 还有8块 GPU 配额,集群理论上也还有8块空闲 GPU,但一个需要8块 GPU 的训练任务依然 Pending。原因可能是 GPU 分散在多个节点,或者节点上的 GPU 数量、资源类型、taint、affinity 条件无法同时满足任务要求。
所以实际设计时,可以把几个机制理解成四层。
第一层是资源声明。Pod 使用 requests 声明需要多少 GPU,让 Kubernetes 调度器知道任务的资源需求。
第二层是资源配额。Namespace 使用 ResourceQuota 限制团队或项目能够申请的 GPU 总量,防止一个团队提交大量 Job 后把整个集群的资源申请额度耗尽。
第三层是节点与调度。Node Affinity、Taints/Tolerations、PriorityClass 以及专门的调度器或调度插件决定任务应该进入哪类节点,并在资源不足时按照既定规则处理。
第四层才是 AI 工作负载本身的调度。训练平台还需要考虑 gang scheduling、checkpoint、队列、抢占、GPU 拓扑、数据位置以及任务恢复。对于分布式训练尤其如此,因为一个八 GPU 任务只启动其中三四个 Worker 通常没有意义,必须尽可能保证整个任务以一个整体获得资源。
因此,一个比较实际的 Namespace 配置可能是:
apiVersion: v1
kind: ResourceQuota
metadata:
name: training-gpu-quota
namespace: ai-team
spec:
hard:
requests.nvidia.com/gpu: "16"
而单个训练 Pod 则明确请求:
resources:
requests:
nvidia.com/gpu: 4
limits:
nvidia.com/gpu: 4
然后再通过节点标签、Affinity 和 Taints/Tolerations,把任务限制到正确的 GPU 节点池。
监控方面,也不要只看 Kubernetes 中的 GPU allocation。Prometheus 配合 NVIDIA DCGM Exporter 可以进一步观察 GPU utilization、显存使用、功耗、温度、XID 错误等硬件指标,再结合 Pod、Job、队列和训练框架指标判断到底是 GPU 不够,还是数据加载、CPU、PCIe、网络或存储成为瓶颈。
最终需要记住一个非常实用的区别:requests/limits 解决的是“一个 Pod 要多少 GPU”,ResourceQuota 解决的是“一个 Namespace 最多能申请多少 GPU”,调度策略解决的是“这些 GPU 应该从哪些节点获得”。而对于真正的大规模 AI 训练,还需要进一步加入拓扑感知、队列和 gang scheduling、checkpoint 与抢占恢复机制。
GPU 管理做得好,并不是简单地把数字限制住,而是让资源申请、配额、节点选择和训练任务生命周期形成完整的闭环。否则你可能拥有一座装满 GPU 的机房,却发现最需要 GPU 的那个 Job 仍然安静地躺在 Pending 状态里——这在 Kubernetes 集群里并不罕见。
Kubernetes 中如何限制 AI 任务使用的 GPU,资源配额与调度策略有哪些区别
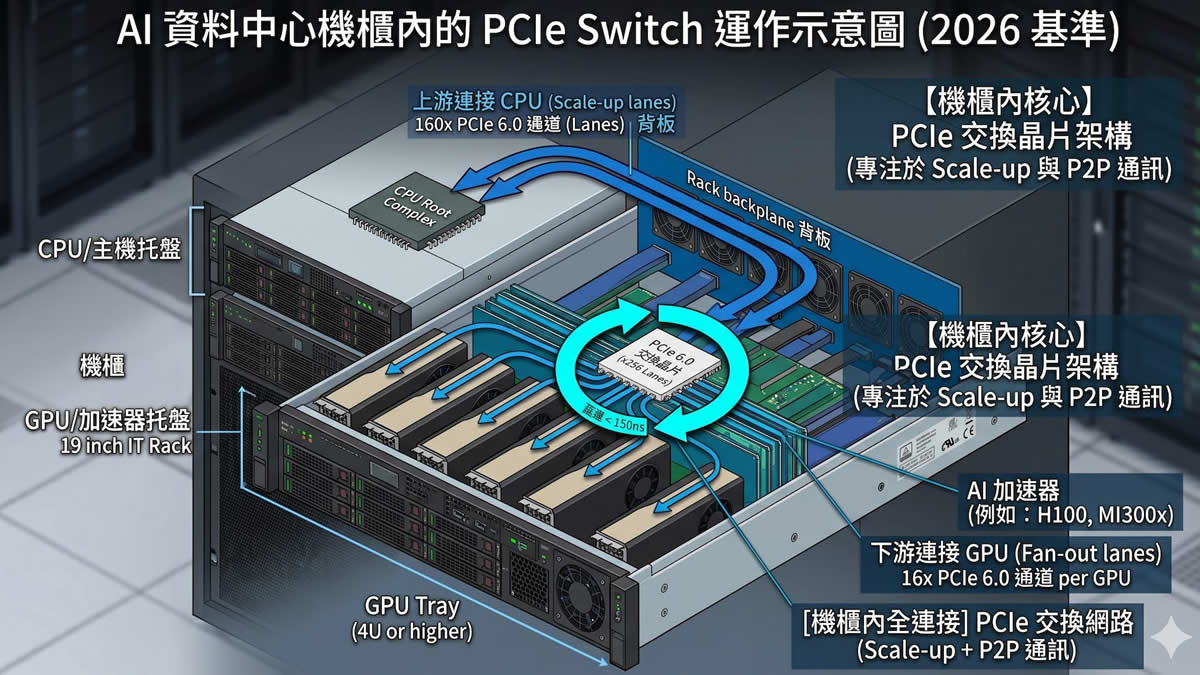
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP