
在 Kubernetes AI 集群中,一个训练或推理 Pod 从 Pending 变成真正能够执行任务,中间并不是简单的“启动容器”。调度器需要找到满足 CPU、内存、GPU、拓扑和节点策略的机器,节点可能需要拉取镜像,容器运行时需要创建容器,GPU 设备插件需要完成资源分配,随后应用还可能加载 CUDA、NCCL、模型权重和配置文件。任何一个环节出现瓶颈,用户看到的结果都可能只是“Pod启动很慢”。
因此,排查这类问题首先不要急着修改 Dockerfile 或增加 GPU。应该先把启动时间拆开测量:Pod 从提交到调度需要多久,从调度到节点开始创建容器需要多久,镜像拉取用了多久,容器启动以后应用初始化用了多久,最后模型加载和 GPU 通信初始化又用了多久。只有把这些阶段分开,才能知道问题到底发生在 Kubernetes、节点、镜像、存储还是应用本身。
镜像通常是最容易观察的瓶颈之一。一个几GB甚至十几GB的 AI 镜像,在节点没有本地缓存时,需要从 Registry 下载并解压多个镜像层。真正影响时间的不只是镜像总大小,还包括 Registry 到节点之间的网络吞吐、并发拉取数量、节点磁盘性能以及镜像层的缓存命中率。
因此,镜像设计应该把变化频繁的内容放在靠后的层,把 CUDA、系统运行库、深度学习框架等相对稳定的依赖尽量复用。多阶段构建适合编译 CUDA 扩展或 C/C++ 依赖,但并不意味着必须把所有层压成一个大层。过度合并可能降低不同 Pod 之间的缓存复用效率。对于大型集群,还应该关注 Registry 是否成为集中式瓶颈,以及节点本地是否已经存在所需镜像。
Debian、Ubuntu、Alpine之间也不能简单用“镜像大几倍”来判断启动速度。AI 环境往往包含 CUDA 用户态库、PyTorch、NCCL、Python依赖以及编译组件,最终大小主要由实际软件栈决定。为了减少启动延迟,更重要的是控制不必要的依赖、合理利用镜像层缓存,并监控实际 image pull time,而不是单纯追求某一种基础镜像。
模型加载则是另一条完全不同的链路。容器已经进入 Running,并不意味着 AI 服务已经可以工作。如果模型权重存放在对象存储、共享文件系统或网络盘中,应用启动后还需要读取大量数据并完成权重加载、格式转换、CPU 到 GPU 的传输以及可能的量化或编译过程。
这里不能简单用“参数超过多少亿就必须分片”判断。模型能否放入一张 GPU,取决于参数精度、量化方式、模型结构、运行时开销以及是否还需要保存 KV Cache、optimizer state 等额外数据。训练和推理的内存需求也完全不同。
对于训练任务,checkpoint、optimizer state 和模型参数可能占用远高于纯推理的空间;对于推理服务,则可能更加关注模型权重加载、KV Cache以及请求并发带来的显存增长。因此,模型加载时间应该通过实际 I/O、CPU内存占用、GPU显存变化和加载阶段日志来判断,而不是简单比较某两个 API 的理论速度。
例如 torch.load 和 Hugging Face Transformers 的 from_pretrained 并不存在一个适用于所有模型的固定速度差异。实际性能取决于权重格式、分片数量、序列化方式、存储位置、内存映射方式以及具体加载流程。对于大型模型,可以考虑合适的权重格式、分片加载、内存映射、节点本地缓存以及模型预热,但这些方案都应该用实际启动时间验证。
GPU 初始化又是第三条链路。首先应该确认节点本身的 NVIDIA 驱动、CUDA 用户态库、NVIDIA Container Toolkit、device plugin 以及 GPU Operator 等组件是否正常。容器中的 CUDA 运行库与宿主机驱动之间需要满足兼容关系,但不能把“CUDA版本不一致”简单理解成容器每次启动都会重新编译 NVIDIA 驱动内核模块。正常的容器 GPU 工作流并不是这样运行的。
如果 Pod 长时间停留在 Pending,应重点查看 scheduler events、GPU extended resource、Node Affinity、Taints/Tolerations、ResourceQuota以及节点实际可分配资源。如果 Pod 已经 Running,但应用迟迟没有开始执行,则应该进一步检查 nvidia-smi、容器日志、GPU device visibility、CUDA 初始化以及 NCCL 初始化。
多 GPU 训练还需要额外检查硬件拓扑。nvidia-smi topo -m 可以帮助确认 GPU、CPU、PCIe 和 NIC 之间的连接关系。多卡任务的性能并不是简单由“GPU型号”决定,PCIe 拓扑、NVLink、NUMA、NIC位置以及 NCCL 通信路径都可能影响启动和训练阶段。
需要特别区分 GPU 初始化和 GPU 通信初始化。单卡任务能够正常启动,并不代表多节点训练一定能够快速建立 NCCL 通信组。后者还涉及网络接口选择、RDMA、InfiniBand 或 RoCE 配置、防火墙、安全策略以及节点之间的连通性。NVLink 也不是一种能够直接减少所有 Pod 启动时间的技术,它主要影响符合条件的 GPU 间数据交换。
对于真正需要解决启动延迟的集群,最有效的方法通常是建立启动时间分解指标。例如记录 Pending → Scheduled、Scheduled → Pulling、Pulling → Pulled、Pulled → Started、Started → Application Ready,再单独记录模型加载和 GPU/NCCL 初始化时间。这样很快就能判断究竟是调度等待、镜像下载、容器启动、模型 I/O,还是 GPU 通信造成延迟。
如果发现大量节点同时拉取大型镜像,应优先解决 Registry 和缓存问题;如果镜像几乎秒级启动而模型加载占据大部分时间,就应该检查模型存储和权重加载路径;如果 Pod 很快启动但 CUDA 或 NCCL 初始化异常,则应转向驱动、GPU 拓扑和网络通信链路。
AI 集群的启动优化最终不是“把所有硬件升级一遍”。GPU越贵并不意味着 Pod 就会越快,NVLink 也不能解决镜像仓库拥堵,换成更小的基础镜像也不能解决十几GB模型权重的网络读取。真正有效的方法,是把 Pod 生命周期拆成可以测量的阶段,再针对最慢的那个阶段优化。对于规模较大的集群,还应该持续记录镜像拉取时间、节点缓存命中率、模型加载时间、GPU初始化时间以及 NCCL 建组时间。只有这样,AI 集群的性能优化才会从“感觉哪里慢”变成可以验证的工程问题。
AI 集群中的 Pod 启动很慢时应该检查什么,镜像、模型和 GPU 初始化分别有什么影响
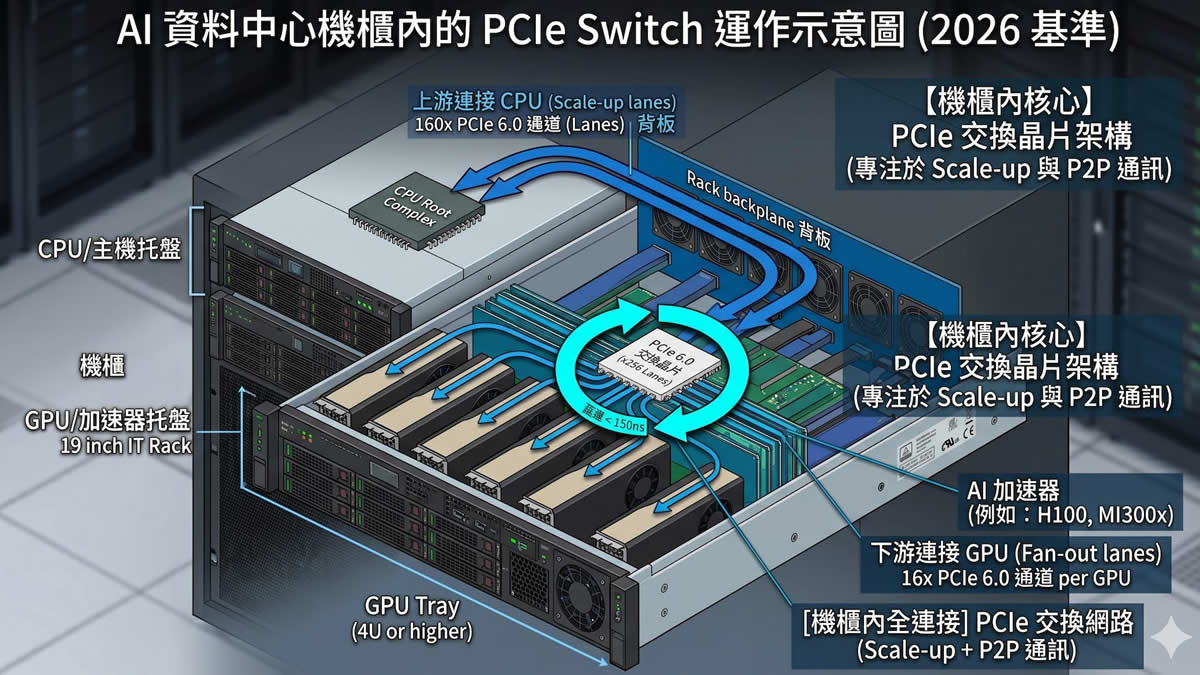
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP