
【中国观察北京时间2026年08月16日】
对于大模型,GPU显存并不是一个简单的“容量越大越好”的指标,而是决定模型能否装入GPU、能够支持多长上下文、能够承载多少并发请求,以及最终推理效率的重要资源。随着模型参数规模扩大,显存压力也从单纯的模型权重存储问题,逐渐演变为参数、KV Cache、激活值、临时缓冲区以及多GPU通信共同作用的系统性问题。
理解大模型的显存需求,首先要从模型参数开始。
模型参数是最基本的显存占用
一个神经网络模型本质上由大量参数组成。以Transformer大语言模型为例,模型权重通常包括注意力层、前馈网络以及其他组件中的矩阵和向量。
如果一个模型拥有1000亿参数,那么仅仅保存这些参数,就已经需要相当可观的显存。
关键在于参数采用什么数据类型。
如果使用FP32,每个参数需要4字节,1000亿参数理论上需要约400GB存储空间。如果采用FP16或BF16,每个参数通常需要2字节,理论权重占用则下降到约200GB。
进一步使用INT8量化,理论上的参数存储需求可以接近100GB;采用4bit量化,则可以进一步下降到约50GB左右。
但这些数字只能作为估算模型权重大小的起点,不能直接等同于实际运行时显存需求。实际部署还需要额外空间。
这也是为什么“一个模型有多少参数”并不能直接回答“需要多大显存”。
推理时并不是只有模型权重
在实际推理过程中,GPU需要同时保存模型权重、运行过程中的中间数据以及缓存。
其中最值得关注的就是KV Cache。
Transformer在处理文本时,注意力机制需要使用此前已经计算过的Key和Value。如果每生成一个新的Token,都重新计算整个历史上下文,那么随着上下文不断增长,计算量会迅速增加。
KV Cache的思路就是把已经计算出来的Key和Value保存下来。
下一次生成Token时,可以直接读取此前缓存的数据,而不需要重新计算整个历史序列。
这可以显著降低自回归生成过程中的重复计算,但代价是:
这些缓存必须占用GPU显存。
因此,模型参数越大,并不意味着KV Cache一定越大;KV Cache更直接受到模型结构、上下文长度、并发量和数据精度影响。
KV Cache到底由什么决定
对于典型的Transformer模型,KV Cache的规模大致可以理解为:
层数 × 每层KV头数量 × 每个头的维度 × 上下文长度 × 2 × 数据类型字节数
这里的“2”代表Key和Value两份缓存。
如果进一步考虑batch size,也就是同时处理多少个序列,那么KV Cache还会随着并发请求数量增加。
因此,一个模型即使参数规模完全不变,只要上下文长度从8K增加到128K,KV Cache的压力就可能明显增加。
同样,一个模型单用户推理时显存充足,并不意味着它能够同时服务几十甚至几百个请求。
这也是大型推理服务特别关注KV Cache管理的原因。
长上下文正在改变显存压力的结构
早期讨论大模型显存时,人们往往首先关注模型权重。
例如,一个70B模型,如果按照FP16或BF16计算,仅权重本身大约需要140GB左右的存储空间。
这已经超过很多单GPU的显存容量,因此需要量化或者多GPU部署。
但是在长上下文场景下,问题会进一步复杂。
假设模型权重已经通过量化压缩到GPU能够容纳的范围,那么随着上下文长度增加,KV Cache仍然可能持续增长。
因此可能出现一种情况:
模型“装得下”,但是模型运行起来以后,因为KV Cache、并发请求以及运行时缓冲区继续增长,最终仍然发生显存不足。
换句话说:
模型权重决定了进入门槛,而KV Cache决定了运行规模。
这两个问题必须分开考虑。
Prefill和Decode对显存的需求也不同
大模型推理通常可以粗略分成Prefill和Decode两个阶段。
Prefill阶段负责处理用户已经输入的大段上下文。此时GPU需要对大量Token进行计算,计算密度通常较高。
Decode阶段则是模型逐Token生成回答。
Decode阶段每生成一个Token,都需要读取模型权重,同时访问已经积累的KV Cache。
随着上下文越来越长,KV Cache越来越大,内存访问的重要性也会不断提高。
因此,大模型推理并不是简单地“GPU算力越强越快”。
在某些场景下,GPU计算单元可能并没有完全饱和,性能却受到显存带宽和数据访问效率限制。
这也是为什么评价AI GPU时不能只看TFLOPS。
显存容量和显存带宽是两个完全不同的问题
显存容量回答的是:
能不能装下。
显存带宽回答的是:
装进去以后,数据能多快地被GPU读取和写入。
一个GPU拥有足够大的显存容量,并不意味着大模型一定运行得快。
如果推理过程中GPU需要持续读取大量权重和KV Cache,而计算速度受到内存访问限制,那么显存带宽就会成为性能瓶颈。
反过来,一块显存带宽非常高的GPU,如果容量不足以装下模型和运行所需缓存,也无法直接解决容量问题。
所以大模型部署实际上面对的是两个不同维度:
Capacity决定可运行规模,Bandwidth影响运行效率。
为什么显存不足不能简单用系统内存替代
当GPU显存不够时,一种看似简单的办法是把部分数据放入CPU内存。
从容量角度看,这确实可以扩大可用内存空间。
但问题在于GPU显存和CPU系统内存并不是同一级别的存储资源。
GPU访问自身显存时具有极高的数据吞吐能力,而GPU访问CPU内存通常需要经过PCIe等互联链路,数据传输的延迟和带宽都存在明显差异。
如果模型推理过程中频繁发生GPU显存与CPU内存之间的数据搬运,GPU计算单元可能不得不等待数据到达。
因此,“内存够大”并不等于“GPU可以把它当显存使用”。
对于某些离线推理或者内存受限场景,CPU offload可以作为一种折中方案,但它通常需要以性能下降换取容量扩展。
多GPU也不是简单的显存相加
当单GPU无法容纳模型时,可以使用多GPU部署。
例如四张80GB GPU,从物理容量上看拥有320GB显存。
但这并不意味着系统拥有一块“320GB、访问方式完全等同于单GPU”的统一显存。
模型必须通过模型并行等技术分布在不同GPU上。
典型方式包括Tensor Parallelism和Pipeline Parallelism。
Tensor Parallelism会把某些矩阵计算拆分到不同GPU,由多张GPU共同完成计算。这要求GPU之间频繁交换数据,因此GPU之间的互联带宽和通信延迟非常重要。
Pipeline Parallelism则把模型的不同层分配给不同GPU。这样可以降低单GPU的权重压力,但同时需要考虑流水线调度以及不同阶段之间的数据传输。
因此,多GPU服务器真正需要解决的是:
显存容量、GPU计算能力、GPU之间的通信能力以及并行策略之间的平衡。
为什么量化如此重要
量化的核心作用,就是降低模型权重的数据精度,从而减少存储需求。
例如,从FP16转换到INT8,可以明显降低权重占用;进一步采用4bit量化,可以把模型压缩到更小的显存空间。
但量化并不是免费的。
低精度表示会改变部分数值计算结果,在某些模型和任务中可能造成精度损失。因此实际部署通常需要在模型质量、显存占用、吞吐量以及硬件兼容性之间进行权衡。
更重要的是:
量化主要解决的是模型权重占用问题,并不会让KV Cache自动按照同样比例消失。
如果系统真正的瓶颈来自超长上下文和高并发,那么单纯压缩模型权重可能并不能解决全部问题。
因此现代推理系统还会使用KV Cache量化、KV Cache压缩、Paged Attention以及其他缓存管理技术。
Paged Attention解决的是显存管理问题
传统KV Cache管理方式容易产生显存碎片,而且不同请求的上下文长度不同,会导致缓存空间难以高效利用。
Paged Attention的核心思想之一,就是借鉴操作系统虚拟内存分页的概念,把KV Cache划分成较小的块进行管理。
这样系统可以更加灵活地分配和回收缓存空间,减少因为连续大块显存分配造成的浪费。
它并不是简单地“减少模型参数”,而是改善推理过程中KV Cache的组织和管理效率。
对于高并发LLM服务,这类优化的重要性非常高。
真正决定显存需求的是整个运行状态
因此,估算大模型显存时,不能只做:
参数量 × 每参数字节数
这样的计算。
更合理的思路应该是:
总显存需求 ≈ 模型权重 + KV Cache + 激活值 + 临时工作空间 + 框架运行开销 + 其他运行时内存
不同推理框架、模型架构、量化方式、上下文长度和并发量都会改变最终结果。
其中模型权重通常是比较稳定的部分,而KV Cache则可能随着请求数量和上下文长度动态增长。
这也是生产环境和个人本地部署之间一个非常重要的区别。
个人运行一个模型时,可能只需要考虑“模型能不能装进去”;而服务器运行大模型服务时,还必须考虑“同时能服务多少请求”。
从显存问题可以看出大模型部署的真正复杂性
GPU显存之所以成为大模型部署的重要限制,并不是因为它单纯容量不足,而是因为现代大模型同时需要大量模型权重、缓存和运行时数据,并且这些数据还必须以足够高的速度被计算单元访问。
模型参数决定基础存储需求,量化可以降低权重占用;上下文长度和并发量推动KV Cache增长;显存带宽影响数据读取效率;多GPU部署又引入GPU之间的通信问题。
因此,大模型部署实际上是一个系统工程。
一块GPU是否能够运行某个模型,不能只看参数量;服务器是否适合高并发推理,也不能只看显存总容量。真正需要综合考虑的是模型架构、权重精度、上下文长度、KV Cache规模、并发请求、显存带宽以及GPU之间的互联能力。
当模型从几十亿参数发展到数百亿、数千亿参数时,显存问题也就不再只是“买一块更大的显卡”这么简单,而变成了硬件架构、模型结构和推理软件共同参与的一场资源优化。
这也是今天大模型基础设施越来越强调HBM容量、内存带宽、高速GPU互联和推理框架优化的根本原因。
GPU 显存为什么会成为大模型部署的重要限制,从模型参数到 KV Cache 详细分析
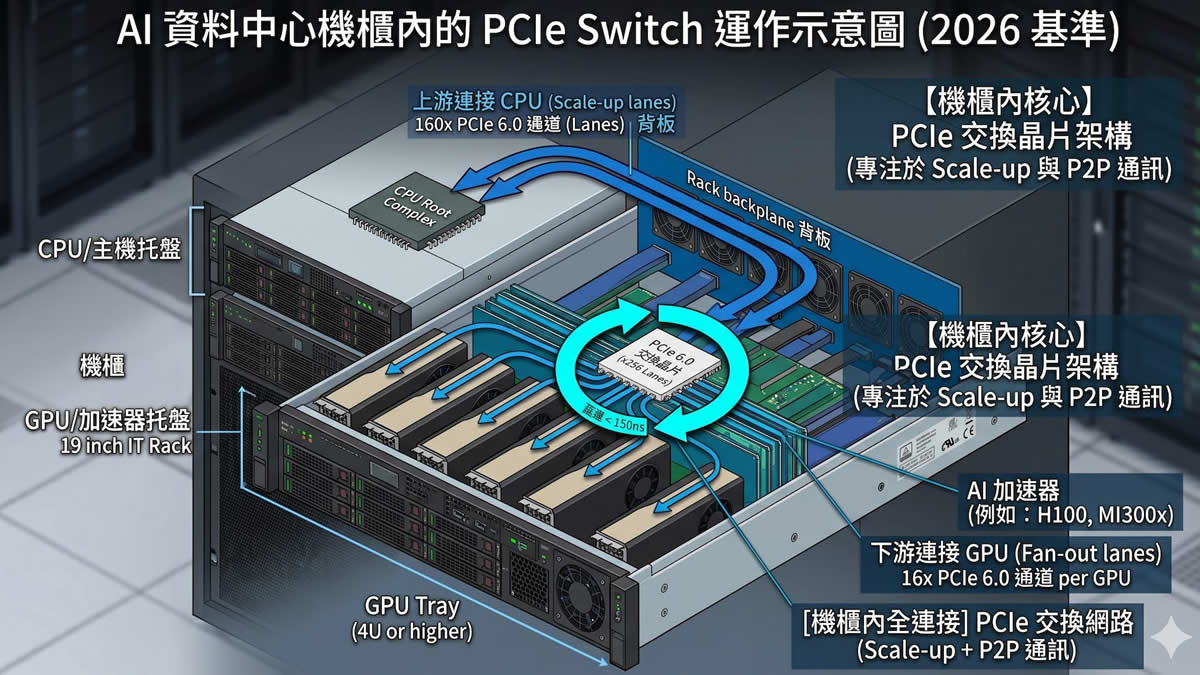
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP