
在深度学习训练和大模型推理过程中,多张GPU能否高效协同工作,不仅取决于GPU本身的计算能力,还取决于GPU之间如何通信。
对于单张GPU,计算能力、显存容量和显存带宽是主要性能指标;但当任务扩展到多GPU甚至数百、数千张GPU时,GPU之间的数据交换就会成为新的瓶颈。尤其是在分布式训练中,模型参数、梯度和中间数据需要频繁在不同GPU之间传输。如果GPU之间的通信路径较慢,即使计算芯片本身性能非常强,也可能出现大量时间消耗在“等待数据”上。
这也是GPU集群为什么需要“拓扑感知调度”的原因。
所谓拓扑,并不是简单意义上的物理距离
这里所说的“GPU距离”,并不是指两张GPU在机房里相隔几米,而是指它们之间的数据通信路径有多短、带宽有多高、经过多少级互联设备,以及通信过程中是否需要跨服务器。
例如,在一台支持高速GPU互联的服务器中,两张GPU可能通过NVLink直接通信;如果多张GPU通过NVSwitch连接,GPU之间可以形成高速交换网络。这样的通信通常比经过服务器PCIe链路再跨越数据中心网络更加高效。
如果两张GPU位于不同服务器中,通信路径则会更加复杂。数据通常需要从GPU显存进入GPU所在服务器的网络接口,再经过InfiniBand或以太网交换网络,最终到达另一台服务器的网络接口,并进入目标GPU。
因此,多GPU系统实际上存在不同层级的通信距离。
同一GPU内部的数据访问速度最快;同一服务器内通过高速GPU互联进行通信,通常也非常快;跨服务器通信则需要依赖数据中心网络;如果进一步跨越机架、交换层级甚至数据中心,通信延迟和网络竞争的影响会进一步增加。
这不是简单的“距离翻倍,延迟也翻倍”,而是通信路径和网络资源发生了变化。
带宽和延迟是两个不同的问题
讨论GPU集群通信时,一个常见错误是把网络带宽和通信延迟混为一谈。
例如,100Gbps代表的是理论数据传输能力,而10微秒代表的是某种通信路径下的延迟。二者并不能直接相互换算。
一条高速网络链路即使拥有400Gbps带宽,如果通信需要经过多个交换设备,或者网络中存在大量并发流量,实际应用性能仍然可能受到延迟和拥塞影响。
反过来,一条延迟很低的链路,如果带宽不足,在大规模梯度同步过程中同样可能成为瓶颈。
对于AI训练,这两个指标都很重要。
如果通信消息很小,延迟可能更加重要;如果需要传输大量模型参数和梯度数据,带宽则更加关键。大模型训练往往同时具有这两方面需求,因此GPU集群设计不能只追求网络带宽。
为什么分布式训练特别依赖拓扑
在数据并行训练中,每张GPU通常运行相同模型的一个副本,但处理不同的数据批次。完成计算后,各GPU需要交换梯度并进行同步。
AllReduce就是分布式训练中常见的集体通信操作。
假设有8张GPU分别计算了一部分梯度,那么训练系统需要让这些GPU交换数据并完成聚合。此时,如果8张GPU之间拥有高速、均衡的通信路径,整体训练效率就会比较高。
但如果其中几张GPU位于同一台服务器,另外几张GPU位于不同服务器,通信性能就可能出现明显差异。
调度器如果完全不考虑GPU之间的拓扑关系,只按照“哪里有空闲GPU就放在哪里”的方式分配任务,就可能把一个需要频繁通信的训练任务拆散到多个网络距离较远的节点上。
结果就是GPU计算能力没有得到充分利用,大量时间反而花在了通信等待上。
拓扑感知调度解决的正是这个问题。
调度器不仅要知道“哪台机器有GPU”,还需要知道“这些GPU之间如何连接”。
GPU拓扑信息从哪里来
现代GPU服务器通常可以通过硬件和软件工具获得比较详细的拓扑信息。
以NVIDIA平台为例,系统可以识别GPU之间是否存在NVLink连接、PCIe连接以及不同GPU与网络接口之间的关系。
在服务器内部,拓扑信息可以帮助系统判断哪些GPU之间通信更加高效。
在跨服务器环境中,调度系统还需要知道GPU对应的网络接口以及网络交换结构。例如,两台服务器是否连接到同一个交换机、是否使用相同的高速网络路径,以及是否存在多个任务共享同一网络链路。
对于采用InfiniBand或RoCE的集群,RDMA可以减少传统网络通信中的CPU和操作系统开销,并提供较低延迟、高吞吐的数据传输能力。
但RDMA本身并不会自动解决所有拓扑问题。网络交换机、网卡、PCIe结构、GPU互联方式以及通信库的配置都会影响最终性能。
NCCL为什么非常重要
在NVIDIA GPU集群中,NCCL是GPU集体通信的重要软件组件。
它能够根据系统检测到的GPU和网络拓扑选择通信路径,并针对不同硬件环境优化AllReduce、AllGather、ReduceScatter等操作。
例如,在同一服务器中,如果GPU之间存在NVLink或NVSwitch连接,通信库可以优先利用这些高速互联;跨服务器时,则可以使用InfiniBand或RoCE等网络进行通信。
因此,GPU调度器和通信库实际上是两个不同层面的系统。
调度器决定“哪些GPU组成一个任务”,通信库则负责“这些GPU之间如何高效交换数据”。
如果调度阶段没有考虑拓扑关系,即使NCCL本身非常优秀,也无法完全弥补GPU被分配到低效通信路径上的问题。
Kubernetes中的拓扑感知
在大型AI基础设施中,Kubernetes经常被用来管理GPU工作负载。
GPU Operator能够帮助Kubernetes集群管理GPU驱动、设备插件、监控以及相关软件组件,但不能简单理解为“安装GPU Operator就自动完成所有拓扑优化”。
真正的拓扑感知调度通常还需要结合节点标签、GPU资源信息、拓扑管理机制以及具体调度策略。
例如,一个训练任务需要8张GPU时,调度系统可能优先寻找能够提供8张GPU的同一节点或同一组高带宽互联节点,而不是把8张GPU随意分散到多个网络距离较远的服务器。
对于大模型训练来说,这种策略尤其重要,因为模型并行和张量并行任务通常需要频繁交换数据。
而对于某些推理任务,情况则不同。
如果推理请求之间相互独立,GPU之间不需要频繁同步,那么跨节点通信对性能的影响可能没有分布式训练那么严重。此时调度系统可以更加重视GPU利用率、负载均衡和服务响应时间。
不同AI任务需要不同的拓扑策略
不能简单认为“GPU距离越近越好”就是所有情况下的最优答案。
例如模型并行、张量并行以及部分大规模训练任务,需要GPU之间进行高频通信,因此更适合部署在高速互联条件较好的GPU集合中。
数据并行任务虽然也需要通信,但通信模式和通信频率有所不同。
而对于彼此独立的推理任务,GPU之间几乎不需要进行高频同步,此时过度追求GPU之间的物理拓扑,反而可能降低整个集群的资源利用率。
因此,真正优秀的调度器应该同时理解“硬件拓扑”和“工作负载特征”。
GPU越多,网络越可能成为瓶颈
当GPU数量从几张增加到几十张、几百张甚至更多时,问题会变得更加复杂。
在小规模集群中,单个GPU的计算速度可能是主要瓶颈;但在大规模分布式训练中,GPU数量不断增加以后,通信量也随之增加。
如果增加GPU数量带来的计算能力提升,最终被通信开销抵消,那么继续增加GPU并不能带来相应的训练速度提升。
这就是大规模AI集群经常面临的扩展效率问题。
例如,一个模型在8张GPU上运行得非常理想,并不意味着增加到64张GPU以后还能获得8倍的性能。随着GPU数量增加,GPU之间的同步、网络通信、数据交换以及任务协调都会产生额外开销。
因此,AI基础设施追求的并不是简单堆积更多GPU,而是在计算能力、GPU互联、网络带宽、通信延迟和调度效率之间取得平衡。
从“资源调度”走向“拓扑调度”
传统GPU调度最关心的问题是“还有多少GPU可以使用”。
现代AI集群则需要进一步回答几个问题:这些GPU在哪里?它们之间如何连接?GPU之间的通信带宽是多少?是否共享相同的网络链路?任务本身需要多频繁的GPU间通信?
这意味着GPU调度正在从简单的资源分配逐渐转向拓扑感知调度。
对于高性能AI训练集群,理想的调度策略应该把计算需求、显存容量、GPU型号、GPU互联方式、网络拓扑和任务通信模式综合考虑。
在这种架构下,GPU不再只是一个孤立的计算设备,而是整个计算、内存和网络系统中的一个节点。
这也是未来大规模AI基础设施的重要发展方向。
随着大模型规模继续扩大,单台服务器内部的高速互联和服务器之间的高速网络将越来越重要。调度系统也需要从“哪里有空闲GPU”进一步发展到“哪些GPU组合最适合这个任务”。
归根结底,GPU集群的性能并不只取决于GPU有多快,还取决于GPU之间能多快地交换数据。计算能力决定任务能够跑多快,而通信网络和拓扑结构则决定这些计算资源能否真正协同起来。
因此,在建设大规模AI基础设施时,GPU型号、显存容量只是其中的一部分。GPU之间的互联方式、服务器内部拓扑、数据中心网络以及调度软件同样决定着最终性能。
对于未来的大模型训练集群,谁能够更准确地理解和利用这些拓扑关系,谁就更有可能把昂贵的GPU计算资源真正转化为有效的训练能力。
GPU 集群为什么需要拓扑感知调度,GPU 之间距离不同会怎样影响性能
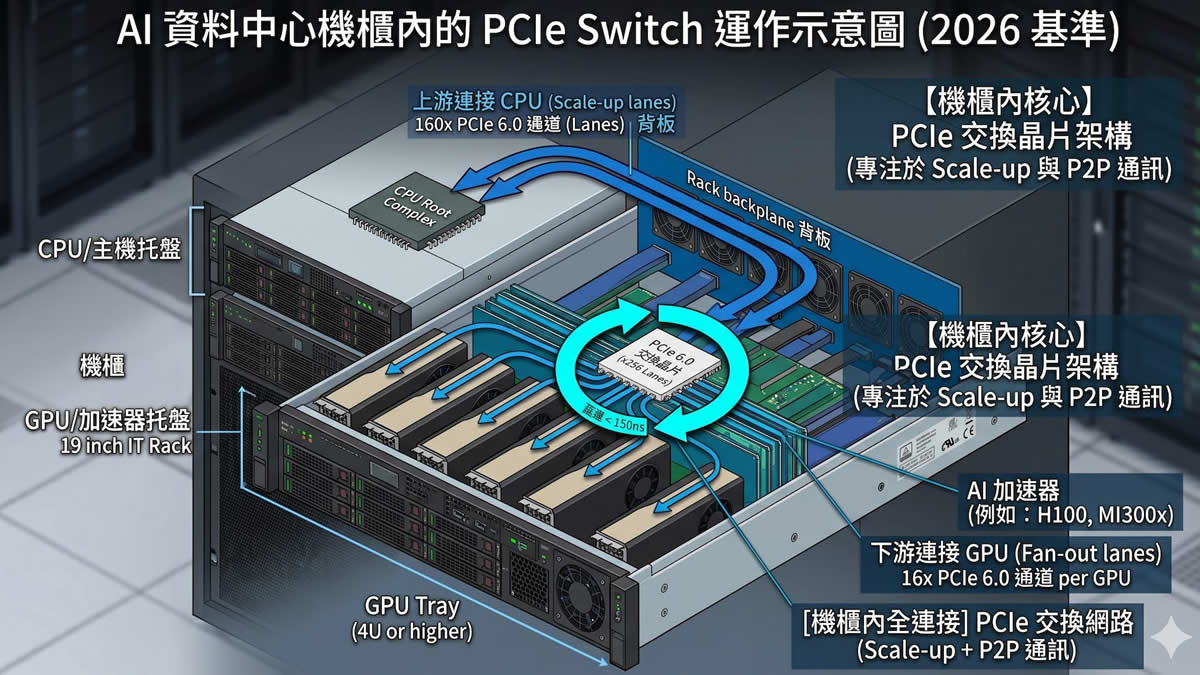
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP