
GPUDirect Storage 如何改变 AI 数据读取方式,高速存储与 GPU 之间怎样协同
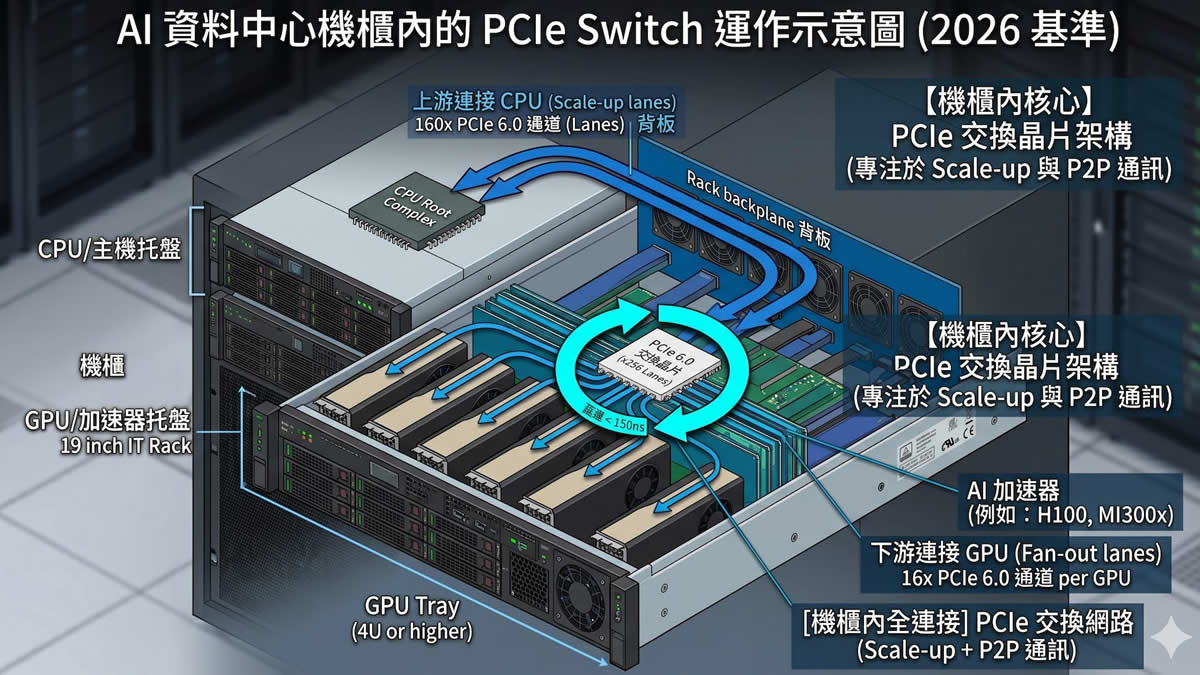
图片说明:示意图 图片来源:Public Domain(公有领域)
大型人工智能模型对计算能力的需求不断提高,但真正限制GPU利用率的并不总是计算能力。对于大规模训练任务,数据能否持续、高速地送到GPU,同样决定着整个系统的效率。如果GPU计算速度远远超过存储系统的数据供应能力,就可能出现GPU等待数据的情况。GPUDirect Storage所解决的正是这一类问题,它并不是简单地把一块SSD“接到GPU上”,而是重新设计CPU、内存、存储和GPU之间的数据传输路径。
传统服务器中的数据读取通常需要经过CPU和系统内存。当训练程序需要读取数据时,操作系统和存储栈首先从NVMe SSD等设备取得数据,再将数据放入主机内存,随后由CPU参与数据处理和搬运,最终通过PCIe等路径把数据送入GPU显存。对于普通应用,这种架构已经足够高效,但在AI训练中,数据规模和访问频率都可能大幅增加,重复的数据复制和CPU参与就会变成额外负担。
GPUDirect Storage的核心变化,是让支持的存储设备能够通过DMA等机制直接把数据传输到GPU显存,从而减少数据在CPU内存中的中间复制。这里最重要的并不是“绕过PCIe”,因为GPU、NVMe设备以及其他高速I/O设备通常仍然通过PCIe连接到系统。真正被优化的是数据路径,也就是尽可能减少CPU和主机内存作为中转站所造成的额外数据搬运。
这一区别非常重要。原始架构可以简单理解为“存储设备、CPU内存、GPU”之间的数据接力,而GDS希望把其中不必要的CPU内存中转和数据复制尽可能取消,让数据更直接地从存储设备进入GPU显存。CPU仍然负责控制和调度工作,但不需要像传统路径那样大量参与数据搬运。
对于AI训练,这种变化的价值主要体现在两个方面。第一是降低CPU开销。当训练数据规模达到数百GB甚至TB级别时,如果大量数据都需要经过CPU和主机内存复制,CPU和内存子系统会承受很高的I/O压力。减少复制之后,CPU可以把更多资源用于训练任务的调度、数据预处理和其他计算工作。
第二是减少内存带宽上的额外压力。传统路径中,同一批数据可能需要在存储设备和主机内存之间传输,再从主机内存进入GPU显存。数据量越大,系统内部需要处理的内存读写就越多。GDS通过更加直接的数据路径减少这些额外搬运,使高速存储设备和GPU之间的吞吐能力得到更充分利用。
但这并不意味着只要安装GDS,AI训练速度就一定会大幅提高。GPU和存储设备之间的性能匹配才是关键。假设一块GPU能够以极高速度处理数据,而底层SSD只能提供有限的读取吞吐,那么GPU最终仍然需要等待数据。反过来,如果存储系统速度非常快,但模型计算本身才是瓶颈,那么GDS带来的改善也可能十分有限。
因此,评价GDS不能只看某一块SSD的标称速度,而应该观察整个I/O链路。NVMe SSD的实际吞吐受到PCIe代际、通道数量、控制器性能、闪存颗粒、队列深度以及并发访问模式等因素影响。服务器中的多个SSD还可能共享PCIe交换芯片、CPU PCIe Root Complex或者其他I/O资源。任何一个环节达到饱和,都可能成为新的瓶颈。
AI训练的数据访问方式也决定了GDS的实际收益。大型模型训练通常需要持续读取海量数据集,尤其是在数据预处理、随机读取和高并发数据加载比较明显的场景中,存储I/O可能成为GPU计算之外的重要限制因素。如果数据加载线程无法及时准备下一批数据,GPU就可能出现空闲周期。通过缩短数据路径并提高I/O效率,GDS可以帮助降低这种等待。
分布式训练则进一步放大了这个问题。当一台服务器拥有多块GPU时,多个GPU可能同时产生大量数据读取请求。如果所有数据都通过传统CPU和主机内存路径传输,CPU、内存带宽和I/O子系统都会受到压力。此时,直接存储访问能够减少部分共享资源上的竞争。不过,多个GPU同时访问存储设备时,存储阵列、PCIe交换结构以及文件系统本身仍然必须具备足够的并发能力。
网络存储环境则是另一种情况。GPUDirect Storage不仅可以用于本地NVMe等存储设备,也可以与支持的网络存储架构结合。在这种情况下,数据可能来自远程存储系统,通过高速网络进入服务器,再直接传输到GPU。其优势仍然是减少不必要的CPU和主机内存数据复制,而不是简单地把网络存储变成“GPU硬盘”。
这里还需要区分GPUDirect Storage与其他GPUDirect技术。NVIDIA的GPUDirect家族包括面向不同数据路径的技术,例如用于GPU之间通信的GPUDirect P2P,以及用于网络设备与GPU之间数据传输的GPUDirect RDMA。GPUDirect Storage关注的核心问题则是存储I/O与GPU显存之间的数据路径。不同技术可以在同一AI服务器中协同工作,但它们解决的是不同层面的数据传输问题。
同样需要注意,NVLink并不是GDS的数据传输替代品。NVLink主要解决GPU之间或者特定处理器与GPU之间的高速互联问题,而GDS解决的是存储I/O到GPU显存的数据路径优化。NVLink、NVLink-C2C、PCIe、NVMe和网络存储分别处于不同的系统层级,把这些技术简单组合成一条“NVMe通过NVLink直接进入GPU”的通道,会误解实际硬件架构。
软件栈同样决定GDS能否发挥作用。应用程序、CUDA、NVIDIA驱动、文件系统、存储设备以及服务器硬件需要形成完整的支持链路。GDS通常不是一个单独安装后就能自动改变所有程序数据路径的功能,而是需要应用和软件栈按照相应方式使用其接口。对于已经高度优化的数据加载框架,实际收益还取决于原有数据路径究竟存在多大的CPU和内存瓶颈。
从性能优化角度看,部署GDS之前首先应该测量系统真正的瓶颈。如果GPU利用率长期偏低,同时CPU并不繁忙,而存储读取吞吐已经接近设备极限,那么升级SSD、增加并行存储设备或者改善数据预取可能比单纯启用GDS更重要。如果CPU负载和主机内存带宽明显受到数据搬运影响,那么减少数据复制的GDS就更具有价值。
对于企业级AI基础设施,这种变化意味着存储系统已经不能再被视为GPU服务器的附属设备。过去服务器性能讨论往往集中在GPU数量、显存容量和GPU互联速度上,而随着模型规模扩大,数据供应能力越来越成为整个系统的一部分。高速NVMe、PCIe拓扑、文件系统、网络存储、数据预取以及GPU数据加载机制,需要被作为一个整体进行设计。
GPUDirect Storage真正改变的并不是某一个硬件部件,而是AI服务器的数据流逻辑。它试图减少CPU和主机内存承担的中转工作,让存储设备产生的数据更加直接地进入GPU计算路径。对于需要持续处理海量数据的AI训练任务,这种设计能够减少数据复制和CPU开销,并在合适的硬件环境下提高数据供应效率。
但GDS并不是解决AI系统I/O瓶颈的万能方案。最终性能仍然取决于存储吞吐、PCIe拓扑、文件系统、并发访问、GPU计算负载以及软件栈之间的匹配程度。真正高效的AI基础设施,不是简单堆叠更快的SSD和更多的GPU,而是让计算、存储、网络和内存之间形成尽可能少的无效数据搬运。GPUDirect Storage的意义,正是在这一系统级优化过程中,把“如何把数据送到GPU”从一个后台问题,提升为AI计算架构本身的重要组成部分。
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP