
GPU服务器使用NVMe SSD到底该看IOPS还是吞吐量
在普通电脑上选择NVMe SSD,很多人习惯直接看一个数字:顺序读取速度多少GB/s。
但到了GPU服务器,这种选法很容易失效。
一台配备多张高端GPU的服务器,GPU计算能力可能已经达到每秒数十TB甚至更高,而数据从存储设备进入CPU内存,再进入GPU显存,中间还要经过PCIe、文件系统、数据加载框架以及CPU和内存等多个环节。SSD标称的7GB/s、12GB/s甚至更高速度,并不意味着GPU训练任务就一定能够获得同样的实际性能。
所以,GPU服务器选择NVMe SSD时,真正需要回答的问题不是“IOPS和吞吐量哪个更重要”,而是:当前工作负载到底是被小IO请求、顺序带宽、IO延迟,还是存储到GPU的数据路径限制住了。
一、先搞清楚IOPS和吞吐量分别解决什么问题
IOPS是每秒可以完成多少次I/O操作。
假设每次只读取4KB数据,即使SSD的总带宽很高,如果大量请求都是随机的小块访问,存储设备仍然可能受到IOPS和延迟限制。
吞吐量则是单位时间能够传输多少数据。
例如一个训练任务连续读取几个TB的大型数据文件,每次I/O都是几百KB甚至几MB,这时候单纯追求几百万IOPS并没有太大意义。因为每个I/O请求本身已经很大,系统更容易受到持续读带宽限制。
两者之间还存在一个经常被忽略的关系:
吞吐量 ≈ IOPS × 每次I/O的数据量。
例如,在理想情况下,100万IOPS、每次4KB,对应的理论数据量大约只有4GB/s;如果每次I/O达到256KB,即使IOPS下降,整体吞吐量也可能非常高。
所以,看GPU服务器的存储性能,不能只盯着厂商宣传的“随机读取几百万IOPS”,也不能只盯着“顺序读取14GB/s”。
必须把IOPS、吞吐量、IO大小和延迟放在一起看。
二、GPU训练最容易遇到的不是SSD速度不够,而是数据供应跟不上GPU
GPU训练过程中,一个常见问题是GPU计算单元已经具备很强的处理能力,但下一批数据还没有准备好。
这时GPU利用率可能下降。
PyTorch的DataLoader可以通过多个worker并行准备数据,并利用prefetch机制提前准备batch,从而让数据加载与训练计算尽可能重叠。PyTorch官方文档也明确指出,当数据来自较慢存储设备,或者观察到GPU因为数据加载而出现空闲时,可以增加DataLoader worker,但worker数量需要根据实际工作负载进行测试,而不是越多越好。
这意味着GPU服务器的存储性能不能脱离软件层单独评价。
如果训练数据由大量小文件组成,例如大量图片、文本文件或者经过切分的数据样本,那么随机读取请求会明显增加。此时IOPS、平均延迟以及高并发情况下的尾延迟都很重要。
但如果数据已经被整理成大块连续的数据集,例如大型shard文件,那么工作负载就可能更接近顺序读取。这个时候,持续吞吐量往往比一个非常漂亮的4KB随机IOPS数字更加重要。
这也是为什么很多AI数据集会采用打包、分片或者流式读取方式,而不是让训练程序不断打开海量小文件。
三、模型加载更看重吞吐量
模型启动阶段通常需要读取大量模型权重。
一个几十GB甚至几百GB的模型,如果存储设备能够持续提供较高读取带宽,就可以明显缩短模型加载和服务启动时间。
这种场景与4KB随机读取完全不同。
如果模型文件是几个大型连续文件,那么一块能够稳定提供高顺序读取带宽的NVMe SSD,往往比一块随机IOPS特别高但持续带宽一般的SSD更加合适。
不过,多GPU服务器还存在另一个问题。
假设服务器安装了8块NVMe SSD,每块SSD都可以提供7GB/s,那么理论上存储设备总带宽已经远远超过单块SSD。
这时候真正的瓶颈可能变成PCIe拓扑、CPU PCIe Root Complex、PCIe Switch或者GPU与NVMe之间的数据路径。
NVIDIA的GPUDirect Storage文档就特别强调了这一点:对于GPU服务器,存储设备数量以及GPU与存储设备之间的PCIe路径会直接影响最终性能。在某些架构中,需要多块PCIe NVMe SSD才能充分利用GPU侧的PCIe带宽。
所以,买了8块高速SSD,并不意味着8块SSD的标称性能可以简单相加。
四、检查点写入不要只看IOPS
大型模型训练通常会周期性保存checkpoint。
这类操作经常涉及几十GB甚至数百GB的数据写入。
如果checkpoint是大块连续写入,那么持续写吞吐量非常重要。
例如一份200GB的checkpoint,如果存储系统可以稳定提供10GB/s写入速度,理论上的数据传输时间约为20秒;如果持续写入只有2GB/s,那么单纯的数据写入就可能需要接近100秒。
对于训练集群来说,这种差距非常明显。
当然,checkpoint也不能只看顺序写入速度。
如果多个训练进程同时保存checkpoint,或者文件系统需要同时处理元数据、日志和其他I/O,那么随机写入、队列深度以及尾延迟同样会影响实际表现。
因此更合理的说法是:checkpoint场景通常首先关注持续写入带宽和写入延迟,再根据实际并发情况考察IOPS。
五、4KB IOPS并不能代表GPU服务器真实性能
这是选择NVMe SSD时最容易出现的误区之一。
消费级SSD和企业级SSD的宣传页面,经常会同时列出:
随机读取IOPS;
随机写入IOPS;
顺序读取速度;
顺序写入速度。
但这些数字通常是在特定测试条件下得到的,例如固定的IO大小、队列深度、线程数量和测试数据集。
GPU服务器真正运行时的I/O模式可能完全不同。
例如:
4KB随机读取和1MB顺序读取,对SSD的要求完全不同;
单GPU和8GPU同时访问,对SSD的要求不同;
一个训练进程和几十个worker并发访问,也完全不同;
本地NVMe和Ceph、NFS等网络存储,更不能直接用同一组指标判断。
所以,如果服务器主要跑AI训练,最好使用与实际业务接近的测试参数,而不是只运行一个4KB随机读取benchmark。
六、NVMe SSD本身只是存储链条的一部分
GPU服务器的存储性能可以简单理解成一条数据路径:
存储介质 → NVMe控制器 → PCIe → CPU/PCIe Switch → 内存或GPU → GPU计算。
其中任何一环都可能成为瓶颈。
这也是为什么“SSD标称14GB/s”并不意味着GPU一定能够拿到14GB/s的数据。
NVIDIA的GPUDirect Storage允许符合条件的系统建立存储设备与GPU显存之间更直接的数据路径,减少传统数据路径中的CPU内存中转,从而降低CPU负担并改善带宽和延迟表现。
在高端AI服务器中,这已经使“SSD有多快”逐渐变成一个不完整的问题。
更准确的问题应该是:
SSD有多快?
这些SSD挂在哪里?
GPU又挂在哪里?
它们之间经过几个PCIe层级?
是否存在PCIe带宽共享?
存储设备和GPU是否具有良好的PCIe拓扑关系?
软件是否能够利用直接数据路径?
这些问题有时比SSD厂商给出的峰值IOPS更加重要。
七、RAID 0并不是免费的性能提升
多块NVMe SSD可以通过RAID或者其他软件存储方式组合起来。
RAID 0可以把多个设备的带宽聚合起来,对于大规模顺序读取和写入非常有吸引力。
但它没有数据冗余。
任何一块盘发生故障,都可能导致整个阵列的数据不可用。
如果GPU服务器保存的是可以从对象存储重新下载的训练数据,那么RAID 0可能是一个合理的性能方案。
但如果存储的是不可重新生成的checkpoint、模型版本或者业务数据,就需要重新考虑数据保护策略。
RAID 10可以提供冗余,同时保持较好的读写性能,但有效容量和成本都会发生变化。
对于大型AI集群,还可能采用Ceph、并行文件系统、对象存储或者NVMe-oF等方案。此时存储性能已经不再是“买哪一块SSD”的问题,而变成整个存储系统架构的问题。
八、网络存储环境下,还要看网络带宽和延迟
如果GPU服务器不是直接读取本地NVMe,而是通过NFS、Ceph、NVMe-oF或者其他分布式存储系统获取数据,那么SSD性能只是其中一个环节。
假设后端NVMe存储可以提供几十GB/s,但GPU服务器与存储集群之间的网络带宽只有25Gbps,那么网络本身就可能成为瓶颈。
反过来,即使网络采用高速以太网或者RDMA,如果后端存储节点无法持续提供足够的IO能力,GPU同样无法获得预期的数据供应。
因此,AI存储系统应该同时考虑:
存储设备性能;
PCIe带宽;
网络带宽;
网络延迟;
存储节点数量;
文件系统;
并发访问;
缓存;
CPU和内存;
GPU与存储之间的拓扑。
其中任何一个环节出现明显短板,都可能让其他昂贵硬件无法发挥性能。
九、QLC、TLC以及企业级SSD也不能只看标称速度
SSD NAND类型同样需要考虑。
TLC和QLC并不能简单理解成“一个好,一个差”。
对于GPU服务器,更需要关注的是持续写入性能、写入放大、缓存耗尽之后的性能、耐久度以及长时间高负载下的稳定性。
尤其是训练服务器。
如果系统每天持续写入大量数据,SSD长期处于高写入负载,那么DWPD、TBW以及厂商给出的企业级工作负载指标就比普通消费级SSD的峰值性能更加有参考价值。
一块SSD跑几分钟benchmark得到10GB/s,并不意味着它可以在数小时甚至数天的持续工作负载中始终保持这个速度。
对于AI服务器来说,“稳定跑多久”往往比“峰值跑多快”更重要。
十、到底应该优先看IOPS还是吞吐量
可以把判断方法简单化。
如果工作负载主要是大量小文件、随机访问、高并发请求,那么优先关注IOPS、平均延迟和尾延迟。
如果工作负载主要是大型模型文件、大型数据集、checkpoint或者其他大块数据传输,那么持续顺序吞吐量通常更加重要。
如果是多GPU训练,则不能只看SSD本身,还必须检查PCIe拓扑、并发能力以及GPU与存储之间的数据路径。
如果采用Ceph、NFS、NVMe-oF等网络存储,则必须把网络带宽和延迟一起纳入测试。
如果使用PyTorch,则还需要观察DataLoader worker、prefetch、CPU解码以及内存到GPU的数据传输是否成为瓶颈。
最后还有一个非常实用的判断方法:看GPU利用率和I/O监控,而不是只看SSD benchmark。
如果SSD的吞吐量只有峰值的一小部分,但GPU已经能够持续满负载运行,那么继续购买更快的SSD可能没有意义。
反过来,如果GPU利用率经常出现周期性下降,同时CPU等待I/O、存储队列深度或者读取延迟明显升高,那么存储系统才可能是训练瓶颈。
GPU服务器的NVMe选型,本质上不是在IOPS和吞吐量之间二选一,而是寻找与实际数据访问模式匹配的存储系统。高IOPS解决的是大量小请求并发,高吞吐解决的是大规模数据搬运,而低延迟、高并发能力、PCIe拓扑和GPU直连数据路径,则决定这些理论性能最终能不能转化成GPU真正能够使用的性能。
对于AI服务器,最昂贵的硬件往往不是SSD,而是GPU。让价值数万美元甚至更高的GPU因为数据供应不足而等待,才是存储系统设计中最应该避免的浪费。
GPU 服务器使用 NVMe SSD 时应该关注哪些指标,IOPS 和吞吐量哪个更加重要
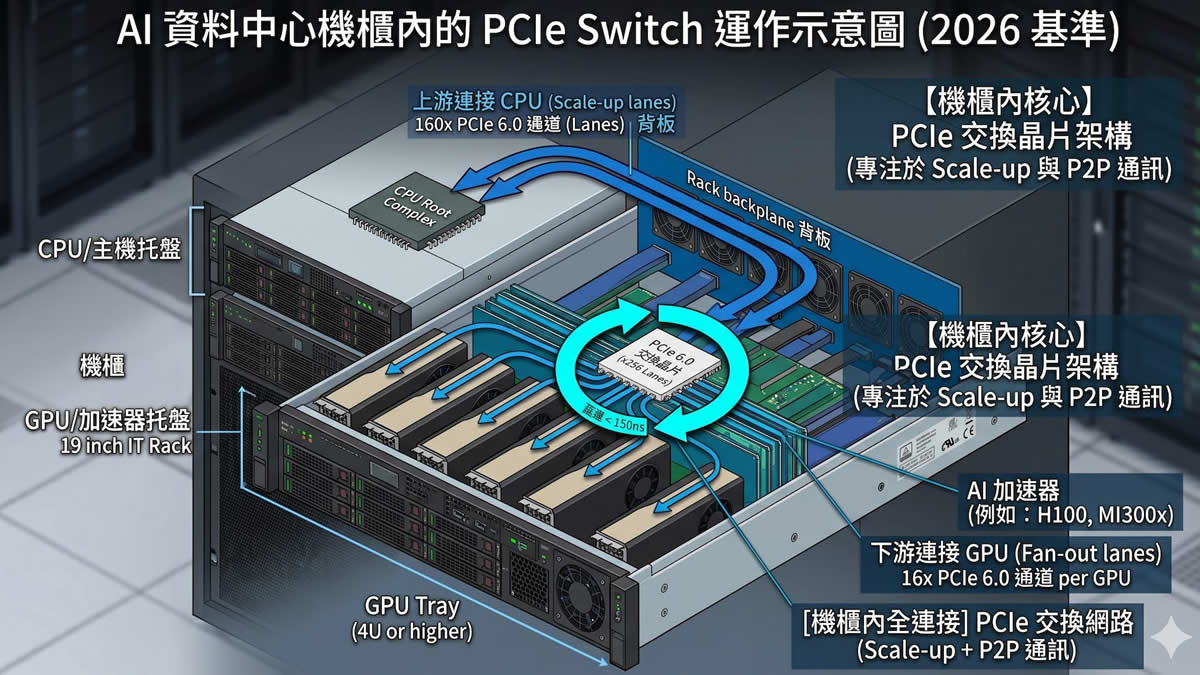
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP