
AI 计算中的数据搬运为什么经常比计算本身更难优化
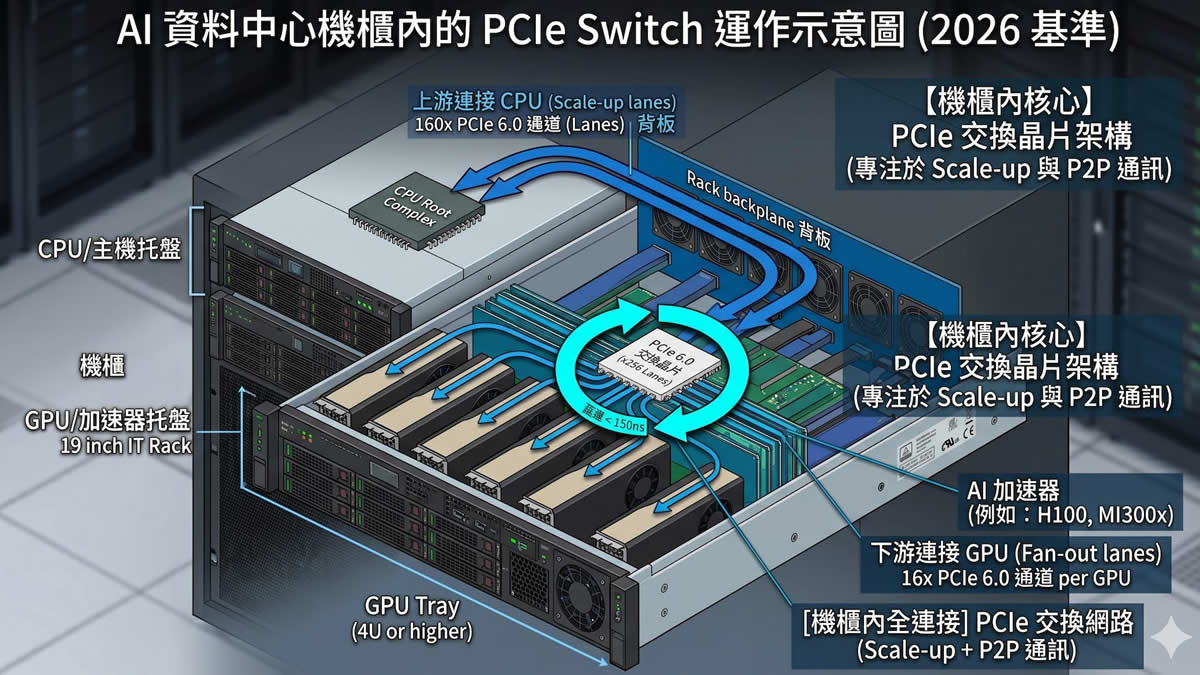
图片说明:示意图 图片来源:Public Domain(公有领域)
在传统计算机系统中,提高处理器频率、增加核心数量或者使用更强的加速器,往往能够直接带来计算性能提升。但到了人工智能计算,特别是大语言模型训练和推理阶段,情况开始发生变化。GPU可以在极短时间内执行海量矩阵运算,可是这些计算单元需要持续获得参数、激活值、梯度和中间结果。如果数据不能以足够快的速度到达计算单元,再强大的GPU也可能出现大量等待。
这就是AI基础设施中经常出现的“数据搬运”问题。这里所说的数据搬运,不只是CPU和GPU之间的数据复制,还包括GPU显存内部的数据访问、GPU之间的通信、服务器之间的网络传输,以及存储设备向计算节点提供训练数据的过程。AI系统的性能因此不再只是一个“每秒能算多少次”的问题,而变成了整个数据流能否顺畅通过系统的问题。
理解这个问题,可以先看GPU内部最基本的关系。以NVIDIA A100为例,其HBM2e显存带宽最高约为1.6 TB/s。这个数字意味着GPU能够以非常高的速率访问本地高带宽显存。但这并不意味着训练任务会把所有数据从主机内存通过PCIe不断搬到GPU。正常情况下,训练所需的模型参数、激活和梯度会尽可能驻留在GPU显存中,GPU首先消耗的是本地显存带宽。
因此,不能简单把A100的1.6 TB/s和PCIe 4.0 x16的约16 GB/s单向带宽放在一起,然后得出“训练时GPU经常因为PCIe带宽不足而等待”的结论。只有在模型或数据确实需要频繁跨越PCIe边界时,这个带宽差异才会成为关键因素。例如,当模型规模超过单GPU显存,需要进行CPU offload、参数分片或者某些特殊的内存管理时,PCIe就可能进入性能关键路径。一旦数据必须从较慢的层级重新进入GPU,计算单元等待数据的时间就会增加。
这也解释了为什么现代AI服务器非常重视GPU之间的高速互联。大型模型通常不会只放在一张GPU上,而是采用数据并行、张量并行、流水线并行或者它们的组合。模型被拆分以后,不同GPU之间必须交换激活、梯度或参数。GPU之间的通信速度和延迟,直接影响这些计算能否连续进行。
NVIDIA的NVLink就是为此设计的高速GPU互联技术。它与PCIe并不是简单的“快一点和慢一点”的关系,而是针对GPU之间的大规模数据交换提供更高带宽、更低通信开销的互联路径。不同GPU架构和系统配置的NVLink能力并不相同,因此讨论具体性能时必须明确GPU型号、NVLink代际以及拓扑结构,而不能用一个固定的“100 GB/s”代表所有NVLink系统。
当GPU数量从一台服务器扩展到多台服务器以后,问题进一步变复杂。此时数据必须通过高速网络在服务器之间传递,网络接口、交换机、链路拓扑和通信库都会影响最终效率。训练大模型时经常使用AllReduce等集体通信操作,让不同GPU交换和聚合梯度。GPU计算完成之后,如果必须等待整个集群的数据同步,网络通信就可能成为训练周期的一部分。
但AllReduce并不是随着GPU数量增加就简单出现“指数级增长”。具体通信量取决于算法、消息大小、参与GPU数量和通信拓扑。以Ring AllReduce为例,每个参与者在算法中需要进行规定次数的数据发送和接收,通信量具有明确的数学关系。真正棘手的地方在于,随着集群规模扩大,网络拥塞、交换机层级、链路利用率、同步等待以及故障恢复等系统问题会越来越突出。
因此,大型AI集群的网络设计并不是简单追求一个最高带宽数字。工程师还要考虑GPU之间的物理拓扑、NIC与GPU之间经过哪些PCIe路径、服务器之间采用什么网络、是否支持RDMA,以及通信库能否有效利用这些硬件。像NCCL这样的GPU通信软件,就是为了让集合通信尽可能贴合GPU和网络硬件的实际拓扑。
数据搬运的问题还存在于存储系统。训练数据最终来自SSD、网络文件系统、对象存储或者其他数据源。如果数据读取速度跟不上GPU消耗速度,就会出现一种很尴尬的情况:GPU拥有极高的计算能力,却在等待下一批训练数据。
这里也不能简单用SSD宣传页面上的“顺序读取3500 MB/s”来判断AI训练性能。SSD性能受到访问模式、块大小、队列深度、读写比例和并发程度影响。大量小文件、频繁元数据操作和低队列深度访问,可能让实际性能与连续大块读取差别很大。
所以AI训练系统通常会通过数据预取、缓存、批量读取以及更适合训练的数据格式来降低存储压力。把大量小文件整理成适合顺序读取的数据文件,可以减少文件系统和存储设备承担的额外工作。数据加载线程提前准备下一批数据,也能够让CPU和存储设备的工作与GPU计算重叠,从而减少GPU空闲时间。
AI推理又带来了另一种数据搬运问题,其中最典型的就是KV Cache。Transformer模型在生成文本时,需要保存此前token产生的Key和Value,以避免每生成一个新token都重新计算整个上下文。随着上下文长度和并发请求增加,KV Cache会快速增长,占用大量显存。
但KV Cache究竟需要多少显存,不能只根据“上下文2048 token”判断。它与Transformer层数、注意力头数量、KV头数量、每个head的维度、数据类型以及batch size都有关系。上下文从几千token增加到几十万token时,KV Cache可能成为推理系统中非常重要的内存压力来源。
这也是为什么现代LLM推理系统非常重视显存管理。系统不仅要保存模型权重,还要同时处理大量请求产生的KV Cache。某些架构采用Paged KV Cache等方法,把KV Cache按照更灵活的方式管理,以减少内存碎片并提高显存利用率。对于长上下文和高并发服务来说,显存管理本身就可能成为决定吞吐量的重要因素。
数据搬运还有一个容易被忽视的特点,那就是它会跨越多个硬件层级。CPU访问内存是一层,CPU和GPU之间是另一层,GPU显存又是一层,GPU之间还有高速互联,跨服务器以后则进入网络,再往后还涉及存储系统。每一层都有自己的带宽、延迟和访问粒度。
假设一个模型需要大量参数访问,但参数已经位于GPU显存中,那么优化重点可能是显存访问模式、数据布局和kernel设计。如果模型跨越多张GPU,则通信拓扑和通信计算重叠更加重要。如果模型进一步跨越多个服务器,网络和集合通信成为重点。如果训练数据读取跟不上GPU,则必须优化数据管道。所谓“数据搬运瓶颈”,因此没有一个统一答案,必须找到数据究竟卡在哪一层。
这也是AI硬件设计越来越重视“内存墙”的原因。GPU的算力增长速度很快,但存储容量、内存带宽和互联带宽并不会以完全相同的速度增长。计算单元越多,理论上每秒能够处理的数据越多,对数据供应系统的要求也越高。如果内存和互联系统没有同步扩展,新增的计算单元就可能无法被充分利用。
从这个角度看,AI芯片的竞争也不只是比较TOPS或者FLOPS。显存容量、显存带宽、GPU之间的互联、网络带宽、通信延迟以及软件栈同样决定系统最终能够达到多少有效性能。一个理论算力更高的GPU,如果无法获得足够的数据供应,在实际模型中的表现完全可能不如理论算力较低但数据通路设计更合理的系统。
软件优化因此变得非常重要。CUDA kernel可以通过合理的数据布局减少无效内存访问,算子融合可以减少中间结果在显存中的读写,混合精度可以降低数据量并提高计算吞吐,通信与计算重叠则可以让GPU在网络传输发生时继续执行其他工作。现代深度学习框架还会通过内存池、异步执行、预取和调度机制尽量隐藏数据移动成本。
Docker和Kubernetes也属于这个系统的一部分,但不能简单认为容器本身就是AI数据搬运的主要瓶颈。在设计良好的GPU集群中,容器化主要解决环境隔离、资源管理和部署问题。真正决定GPU间通信效率的,仍然是底层硬件拓扑、驱动、通信库、网络配置以及调度方式。如果Kubernetes把需要频繁通信的GPU任务安排在网络距离很远的节点上,或者没有考虑GPU与NIC之间的拓扑关系,那么调度策略才可能间接造成明显的通信损失。
因此,AI计算优化不能只看“计算用了多少时间”。工程师需要把一次完整的任务拆成计算、显存访问、GPU间通信、CPU-GPU传输、网络通信和存储读取,然后判断GPU究竟是在计算,还是在等待。
这个区别非常重要。假如GPU利用率只有60%,并不意味着一定需要换更强的GPU。可能是显存带宽不足,也可能是kernel存在大量随机内存访问;可能是AllReduce没有与计算重叠,也可能是数据加载速度跟不上;甚至可能只是任务本身规模太小,无法填满GPU。
AI基础设施发展到今天,性能优化越来越像一项系统工程。计算单元只是数据处理链条中的一个环节,数据必须经过存储、内存、PCIe、GPU显存、高速互联和网络等多个层级才能最终转化成有效计算。任何一个环节出现明显失配,都可能让其他昂贵的硬件资源处于等待状态。
所以,AI计算中“数据搬运比计算更难优化”并不是说数据传输在任何任务中都比矩阵运算更耗时间,而是说数据移动涉及更多层级、更复杂的拓扑和更强的系统耦合。计算性能可以通过增加计算单元直接提高,但数据搬运受到物理距离、内存层级、互联协议、网络拓扑、软件调度和数据布局共同限制。AI系统的下一轮性能竞争,很大程度上也将发生在这些计算单元之间的数据通路上。
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP