
训练一个大模型,很多人第一反应是看 GPU 有多少 TFLOPS、显存有多少 GB,却很少计算另一个同样现实的问题:GPU 每秒到底需要多少训练数据?
如果 GPU 已经开始计算,而数据加载线程还在等待磁盘,昂贵的 GPU 就会出现空闲时间。反过来,如果存储系统能够提供几十GB甚至上百GB每秒的数据,而 GPU 本身根本消化不了这么多数据,那么继续升级存储也不会让训练速度明显提高。
所以,大模型训练中的存储性能并不是越高越好。真正需要解决的是计算、数据读取、数据预处理以及 GPU 内存之间的供需平衡。
估算训练数据读取速度,最简单的方法是从训练吞吐量开始。
假设一个训练集大小为10TB,整个训练过程希望在10分钟内把这10TB顺序读取一遍,那么理论平均读取速度就是:
10TB ÷ 600秒 ≈ 16.7GB/s
这里需要特别注意,这个数字描述的是“在这10分钟里平均需要读取多少数据”,并不代表任何一台 SSD 都必须单独提供16.7GB/s。
如果训练数据被分布在多个 NVMe SSD、多个存储节点或者对象存储与本地缓存组成的分层架构中,那么整个数据系统可以共同提供这个吞吐量。
更重要的是,训练数据通常不会只读取一次。
假设一个10TB的数据集训练100个 epoch,理论上数据可能被读取数百TB甚至更多。但这并不意味着存储系统必须每秒提供一个极高的固定带宽,因为训练过程中可能存在本地缓存、操作系统页缓存、数据预取、数据集分片以及其他缓存机制。
因此,真正应该计算的是单位时间内训练程序实际需要的数据,而不是简单拿“数据集总容量”除以训练时间。
可以从一个更实用的指标开始:
每秒训练多少个样本。
假设一个训练任务每秒处理2000个样本,每个样本在进入 GPU 前需要读取并解码平均20MB数据,那么原始数据需求大约是:
2000 × 20MB = 40GB/s
这时候,存储和数据加载系统理论上至少要能够持续提供接近40GB/s的数据流。
但这仍然只是第一层估算。
因为磁盘上的数据通常不是以“GPU 可以直接使用的形式”保存的。训练数据可能是图片、文本、音频、视频或者经过序列化的数据集。数据从存储系统读取以后,还可能经历解压、解码、随机访问、格式转换、tokenization、数据增强以及 batch 组装。
因此,一个训练任务的实际数据路径可能是:
存储系统 → CPU内存 → 数据预处理 → pinned memory → GPU显存 → GPU计算
每一个环节都可能成为瓶颈。
例如存储系统可以提供50GB/s,但 CPU 数据解码只能处理20GB/s,那么 GPU 最终得到的仍然只有大约20GB/s的数据供给能力。
反过来,如果 CPU 和存储都非常快,而 GPU 每秒只需要10GB的数据,那么继续增加存储带宽也没有意义。
这就是为什么不能简单使用“GPU TFLOPS × 数据吞吐系数”计算所需磁盘带宽。
TFLOPS描述的是 GPU 的计算能力,而训练数据读取量主要取决于 batch size、序列长度、样本格式、训练吞吐量以及数据预处理方式。两者之间存在联系,但不是一个简单的乘法关系。
例如,一块 GPU 可以拥有数百甚至上千 TFLOPS 的理论计算能力,但训练过程中每秒从数据集读取的数据可能只有几GB到几十GB。GPU 通过大量计算把这些输入数据转化成梯度和模型状态,而不是每执行一次浮点运算都从 SSD 读取数据。
因此,在设计训练系统时,更有意义的关系是:
存储与数据管道吞吐量 ≥ 训练任务实际数据消耗速度
同时:
数据管道处理能力 ≥ GPU 实际训练吞吐所要求的数据供给速度
如果这两个条件成立,存储就不太可能成为主要瓶颈。
GPU 数量增加以后,问题会进一步复杂。
假设一台服务器有8块 GPU,每块 GPU 每秒需要5GB训练数据,那么整个节点的数据供给需求大约就是40GB/s。
如果增加到64块 GPU,而每块 GPU 的训练吞吐量和数据需求保持类似,那么整个训练集群的数据供给需求可能达到数百GB/s。
这时候,一块普通 PCIe NVMe SSD 显然不够。
解决方法可以是使用多个 NVMe SSD,通过 RAID、分布式文件系统或者本地缓存构建更高的聚合吞吐量,也可以使用专门面向 AI/高性能计算的数据存储系统。
这也是为什么大规模 AI 集群经常采用本地 NVMe 加共享存储的分层架构。
共享存储负责保存完整的数据集,本地 NVMe 则负责缓存当前训练任务需要频繁访问的数据。
这样做的好处,是让昂贵的高速本地存储承担“热点数据”,让容量更大的共享存储承担“数据仓库”。
对于小型模型或者单机训练环境,一两块高速 NVMe SSD 往往已经足够。此时真正的瓶颈可能根本不是存储,而是 GPU 显存、CPU 数据预处理或者训练代码本身。
当 GPU 数量增加以后,存储架构的重要性才会迅速提高。
例如8块高端 GPU 同时训练时,如果所有 GPU 都依赖一台普通网络文件服务器读取数据,那么网络带宽可能比 SSD 本身更早成为瓶颈。
假设服务器到存储系统只有25Gbps网络,那么理论网络带宽大约只有3.125GB/s,实际可用吞吐还会受到协议开销、网络栈、存储系统以及访问模式影响。
这意味着即使后面的存储系统能够提供100GB/s,训练节点最终也可能只能拿到远低于100GB/s的数据。
如果换成100Gbps网络,理论带宽约12.5GB/s;400Gbps则约50GB/s。到了大规模 GPU 集群,网络已经不再只是“连接服务器的东西”,而成为整个训练数据管道的一部分。
不过,训练数据访问方式也非常重要。
很多训练任务并不是简单地从一个巨大文件里连续读取数据,而是不断读取大量小文件。如果数据被拆成数百万个小文件,那么元数据操作、文件打开关闭、目录查询以及随机 I/O 都可能造成严重影响。
这时候,即使存储设备拥有很高的顺序读取速度,实际训练吞吐仍然可能很差。
因此,大模型训练通常会对数据格式进行优化,例如将大量小文件打包成更适合顺序读取的数据分片,并结合预取和缓存降低随机访问开销。
这也是为什么“SSD标称读取速度是多少”并不能直接代表训练数据加载速度。
假设某块 NVMe SSD 标称顺序读取速度为7GB/s,并不意味着 PyTorch DataLoader 就一定能够稳定获得7GB/s。
实际速度还受到文件大小、访问模式、线程数量、CPU 解码速度、文件系统、缓存命中率以及数据格式等因素影响。
PyTorch 的 DataLoader 本身也可能成为瓶颈。
如果 num_workers 设置过低,CPU 来不及准备下一批数据,GPU 就可能出现等待。如果 worker 太多,又可能造成 CPU 竞争、内存压力和 I/O 抖动。
因此,训练性能优化经常需要同时观察 GPU utilization、CPU utilization、磁盘吞吐、I/O wait、内存带宽以及 DataLoader 等指标。
如果 GPU 长时间只有50%左右的利用率,同时 CPU 正在忙于解码数据,那么升级 SSD 未必有效。
如果 CPU 很空闲、GPU 也在等待,而存储吞吐已经达到上限,那么存储系统才更像真正的瓶颈。
还有一个非常容易被混淆的问题,就是“模型太大导致需要不断从 SSD 读取模型参数”。
正常训练时,模型参数和大量训练状态会尽可能驻留在 GPU 显存或者其他高速内存体系中。对于超大模型,如果单块 GPU 放不下,训练框架会采用数据并行、张量并行、流水线并行、参数分片以及其他显存优化技术。
这类情况下发生的是 GPU 与 GPU、GPU 与主机内存之间的数据交换,以及分布式训练过程中的通信,并不意味着每一次参数计算都要从 SSD 读取模型参数。
如果模型因为显存不足而不得不频繁进行 CPU offload、NVMe offload,那么存储系统的重要性才会明显增加。此时 NVMe 的延迟和吞吐都可能直接影响训练速度,但这已经属于一种特殊的内存层级设计,而不是普通训练数据读取问题。
GPU 之间的通信同样不能忽略。
在多 GPU 训练中,梯度同步、参数交换以及模型并行通信可能产生非常大的数据流量。这部分流量主要发生在 GPU 间互连和网络上,例如 NVLink、PCIe 或高速 InfiniBand/Ethernet 网络,而不是传统意义上的“硬盘读取”。
因此,一个拥有8块 GPU 的训练服务器,即使存储速度非常快,如果 GPU 之间的通信性能不足,训练仍然可能无法达到预期效率。
最终可以把整个系统理解成几条连续的数据通道。
第一条是存储到 CPU 内存。
第二条是 CPU 内存到 GPU 显存。
第三条是 GPU 与 GPU 之间的通信。
第四条是 GPU 自身的计算和显存访问。
任何一条通道出现明显瓶颈,都可能让昂贵的 GPU 计算资源闲置。
对于单机训练,可以先测量实际训练过程中每秒读取多少数据,再观察 GPU 利用率。如果 GPU 长时间接近满载,而磁盘读取量远低于 SSD 理论上限,那么没有必要为了“AI训练”这个标签盲目购买更快的 SSD。
如果 GPU 利用率周期性掉到很低,而每次掉速都伴随磁盘吞吐达到上限,则应该考虑增加 NVMe 数量、优化数据格式、提高并发读取能力或者增加缓存。
对于多 GPU 甚至多节点训练,则需要进一步计算整个集群的数据供给需求。
例如64块 GPU,每块 GPU 实际训练吞吐对应的数据需求为5GB/s,那么理论数据供给需求就是320GB/s。此时,一套只能提供10GB/s的共享存储显然无法满足持续满负载训练。工程师需要考虑本地 NVMe 缓存、并行文件系统、分布式存储、高速网络以及数据预取等手段。
但这也不是说存储必须永远达到320GB/s。
如果数据已经被预取到本地缓存,训练过程中大部分读取都来自本地 NVMe,那么共享存储只需要负责补充缓存,而不是直接承担所有 GPU 的实时读取请求。
这就是 AI 基础设施中经常出现的分层存储思想。
慢而便宜的存储负责保存完整数据集,高速共享存储负责提供集群级数据访问,本地 NVMe 负责热点缓存,而 GPU 显存负责保存当前计算最需要的数据。
这样设计以后,系统就不需要让最昂贵的存储设备承担所有工作。
所以,大模型训练中的存储性能估算,第一步不是看 GPU 有多少 TFLOPS,而是测量训练任务每秒实际消耗多少数据。然后沿着“存储、CPU内存、数据预处理、GPU显存、GPU计算、GPU间通信”这条链路逐层寻找瓶颈。
对于普通单机训练,高性能 NVMe SSD 往往已经能够满足需求;对于几十块甚至数百块 GPU 的训练集群,问题则会逐渐从“SSD够不够快”变成“整个数据管道能不能持续供应计算集群”。
GPU 越快,系统越容易暴露其他环节的不足。昂贵的 GPU 如果因为等待数据而空转,购买更多 GPU 并不能自动提高训练效率。好的 AI 基础设施并不是把每一个组件都堆到最高规格,而是让存储、网络、CPU、内存和 GPU 之间形成合理的数据流。最终决定训练速度的,往往不是某一个硬件的理论峰值,而是整个系统能否持续、稳定地把数据送到计算发生的地方。
大模型训练的数据读取速度应该怎样估算,存储吞吐与 GPU 计算能力如何匹配
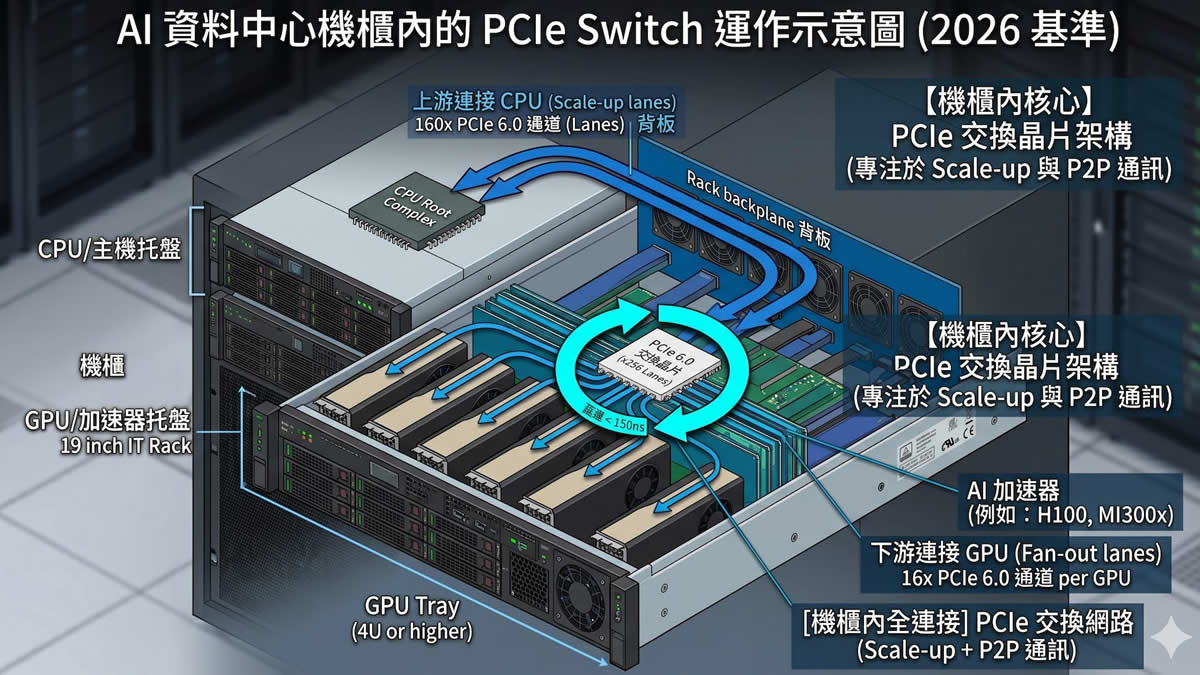
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP