
大模型上下文窗口不断扩大后,GPU 显存和推理成本为什么会明显增加
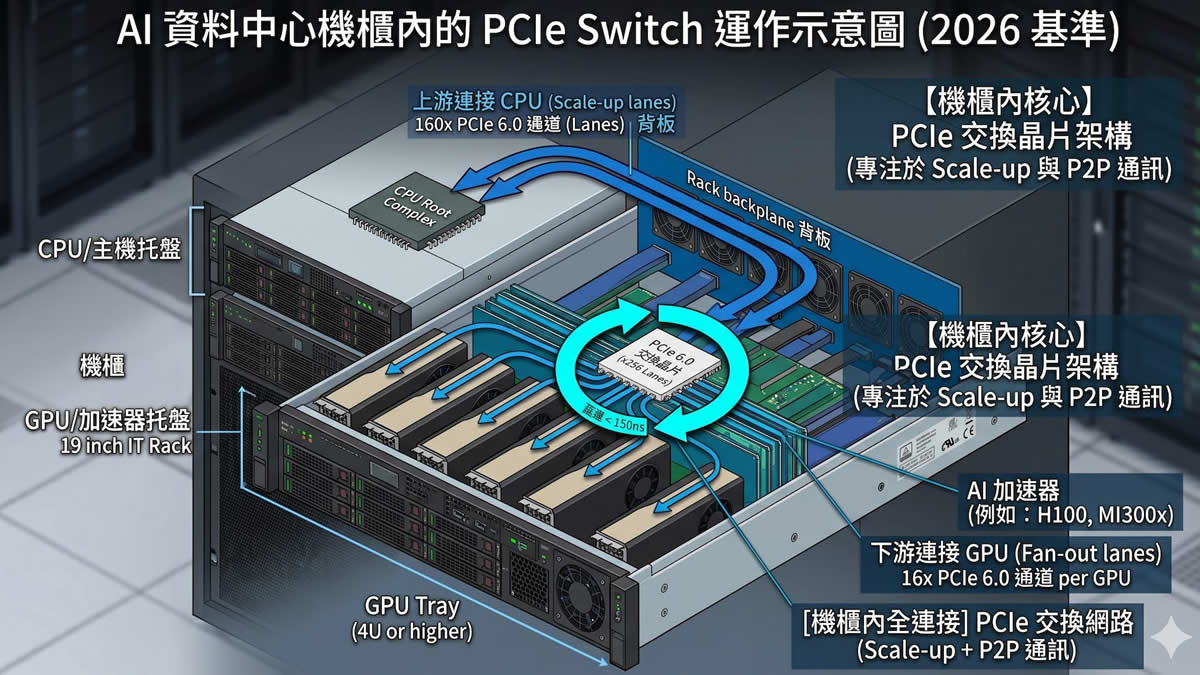
图片说明:示意图 图片来源:Public Domain(公有领域)
大模型的上下文窗口从几千 tokens 扩展到几十万,甚至百万级 tokens,表面上只是“模型一次能读更多内容”,但在 GPU 服务器里,这意味着一项非常昂贵的资源被持续拉长:每一个请求需要保留的注意力状态越来越多。对于大模型推理系统来说,长上下文带来的压力并不是简单地“多占一点显存”,而是同时改变显存容量、显存带宽、注意力计算、批处理能力以及多 GPU 调度方式。
其中最容易被误解的是 KV Cache。它并不是一个随着上下文长度呈平方增长的东西。对于采用标准全注意力的 Transformer,KV Cache 的存储量通常与上下文 token 数量近似线性增长;真正具有平方级复杂度的是全注意力在 Prefill 阶段的计算。两者叠加以后,长上下文才会出现越来越明显的成本拐点。
KV Cache为什么会成为显存大户
大模型推理时,GPU 显存首先要容纳模型权重,然后还要为正在处理的请求保存 KV Cache,以及运行过程中产生的临时工作区、激活和各种运行时缓冲区。对于自回归生成,KV Cache尤其重要,因为模型已经处理过的 token 不需要在每生成一个新 token 时重新计算全部 Key 和 Value,系统可以把这些中间结果保存下来继续使用。
KV Cache 每个 token 到底占多少显存,并不存在一个统一的“16字节”答案。它取决于模型层数、Key/Value 头数量、每个头的维度以及 KV Cache 使用的精度。对于典型的多头注意力结构,可以近似写成:
KV Cache每token字节数 ≈ 2 × 层数 × KV头数 × Head维度 × 每元素字节数。
这里的“2”来自 Key 和 Value 两组数据。
假设一款模型拥有80层、8个KV头、每个头128维,并且KV Cache使用FP16,那么每个token需要保存的KV数据大约是327680字节,也就是320 KiB。这样计算下来,10万个token已经大约需要31 GiB的KV Cache;100万个token则可能达到约312 GiB。实际模型会因为注意力结构、KV头数量、缓存精度、部分层采用不同注意力机制等因素产生明显差异,但这个例子足以说明为什么百万token上下文不能简单理解成“显存多占几十MB”。
这也是为什么近年来推理框架越来越重视KV Cache管理。vLLM的PagedAttention就是针对这一问题设计的,它把KV Cache划分为块进行管理,减少连续显存分配带来的碎片和浪费,并允许系统更灵活地处理不同长度的请求。vLLM官方文档目前也已经提供KV Cache容量、块大小、KV Cache精度以及CPU offload等配置。
因此,所谓“支持100万token上下文”,并不意味着模型启动以后立刻把100万个token对应的KV Cache全部塞进GPU。真正占用多少显存,取决于当前请求实际使用了多少上下文、同时运行多少请求以及推理引擎如何管理缓存。上下文窗口是最大能力,实际请求长度才是运行时资源消耗的重要变量。
长上下文真正复杂的地方是计算
如果只讨论KV Cache,情况其实还没有那么糟,因为KV Cache的存储量基本上随token数量线性增加。麻烦来自注意力计算。
传统Transformer的全注意力需要让序列中的token彼此建立关联。对于长度为L的序列,标准自注意力的计算和中间注意力矩阵规模都具有O(L²)特征。这也是为什么上下文长度从8K增加到16K,并不只是“数据量增加一倍”这么简单。FlashAttention等技术通过分块计算和减少GPU HBM与片上高速存储之间的数据搬运,大幅降低了IO开销,但它并没有把标准全注意力本身从平方复杂度变成线性复杂度。
还必须区分Prefill和Decode两个阶段。
用户一次输入很长的文档、代码库或者聊天历史时,模型首先要进行Prefill,也就是把整个输入上下文处理一遍。对于长上下文,这一阶段的计算压力非常大,而且容易受到注意力计算和GPU内存访问的限制。
进入生成阶段以后,情况发生变化。模型通常一次只生成一个或少量新token,每一个新token都需要访问已经保存的KV Cache。因此Decode阶段单个新token的注意力工作量大体上随着已有上下文长度增长,而KV Cache本身也继续增加。
这解释了一个很重要的工程现象:长上下文不仅让“读进去”变慢,也会让之后的每一个生成token承担更大的注意力访问成本。
## 为什么显存带宽有时候比显存容量更重要
很多人看到长上下文以后,第一个反应是购买更大容量的GPU。例如从48GB换到80GB,从80GB换到141GB,或者增加GPU数量。这当然可以解决容量问题,但容量增加并不等于推理速度一定同步提升。
Decode阶段尤其容易遇到内存带宽问题。每生成一个token,GPU需要从HBM中读取与当前请求有关的Key和Value,并进行注意力计算。如果KV Cache越来越大,GPU计算单元并不一定始终是瓶颈,读取大量缓存数据本身就可能成为限制因素。
这也是FlashAttention以及各种KV Cache优化技术的重要意义。核心目标不仅是减少“需要多少显存”,还包括减少GPU内存层级之间的数据搬运,让有限的HBM带宽产生更多有效计算。
因此,长上下文服务器不能只看“显存多少GB”,还要看显存带宽、GPU计算能力、注意力Kernel效率以及实际batch和请求长度。
长上下文为什么会降低一张GPU能同时服务的请求数量
这可能是长上下文推理成本中最容易被忽视的一部分。
假设一张GPU有80GB显存,模型权重已经占用了相当大的空间,剩余显存才能用于KV Cache。如果一个短上下文请求只消耗几百MB甚至更少的KV Cache,那么同一张GPU可以同时容纳大量请求。
当单个请求变成长上下文以后,一个请求可能就消耗数GB、几十GB甚至更多KV Cache。结果不是简单地“这个请求慢一点”,而是整个服务器能够同时运行的请求数量下降。
于是GPU的经济模型发生变化。
短上下文情况下,一张GPU可以通过连续批处理同时服务大量请求,让计算资源保持较高利用率。长上下文情况下,KV Cache把显存切走以后,batch size受到限制,能够同时容纳的请求数量减少。即使GPU理论算力没有变化,单位GPU能够处理的请求数也可能下降。
所以AI基础设施真正关心的指标通常不是单个请求用了多少显存,而是tokens per second、time to first token、inter-token latency、每秒请求数以及每百万token的实际GPU成本。
多GPU并不能免费解决长上下文问题
当模型权重或者KV Cache超过单张GPU能够容纳的范围时,就需要进行Tensor Parallel、Pipeline Parallel、数据并行或者其他分布式方案。
但增加GPU以后,问题不会自动消失。
Tensor Parallel需要不同GPU共同完成模型层中的计算,因此GPU之间需要频繁交换数据。GPU之间的互联带宽和拓扑就会开始影响性能。NVLink、NVSwitch以及PCIe的能力不同,多GPU服务器内部的拓扑也可能不同。
这里不能简单说“百万token KV Cache必须在GPU之间传输多少MB”,更不能给出一个固定的“10至20微秒”作为所有系统的答案。实际通信量和延迟取决于模型结构、并行方式、KV Cache如何分片、请求调度、GPU拓扑以及通信Kernel。
尤其需要区分Tensor Parallel中的集体通信与KV Cache本身的迁移。AllReduce、AllGather、ReduceScatter等操作是否出现、出现在哪里以及通信规模多大,都由具体模型和并行实现决定,并不是“长上下文以后所有GPU都要把整个KV Cache互相传一遍”。
跨节点以后问题更加明显。PCIe、InfiniBand、RoCE等网络的理论带宽只是基础条件,实际性能还受到拓扑、拥塞控制、RDMA实现、通信模式以及计算与通信重叠程度影响。因此,“100Gbps以后一次传输必然从0.5ms增加到5ms”这类固定数字没有普遍意义。
## 为什么KV Cache管理技术越来越重要
长上下文时代,推理框架实际上开始越来越像一个“GPU内存操作系统”。
传统做法如果按照请求连续分配显存,很容易出现碎片问题。不同用户的上下文长度完全不同,一个请求可能只有几千token,另一个可能几十万token。当请求不断进入和退出时,显存中就会出现大量无法高效利用的空间。
PagedAttention的思路类似操作系统管理虚拟内存,把KV Cache分成固定大小的块,再通过块表管理实际物理位置。这样可以减少内存碎片,也更容易支持动态请求和连续批处理。相关研究显示,这类设计对于长序列、大模型以及复杂解码场景尤其有价值。
现在的推理系统还进一步加入Prefix Caching、KV Cache量化、CPU offload以及不同注意力机制的专门管理。vLLM目前已经支持KV Cache容量控制、KV Cache数据类型、Prefix Caching以及CPU offload等机制。
KV Cache也不一定永远采用FP16或BF16。使用更低精度的KV Cache可以减少显存容量和内存带宽压力,但代价是需要评估精度损失以及具体模型对量化误差的敏感程度。现代推理框架已经开始提供FP8等KV Cache相关选项。
上下文越长,推理成本为什么可能增长得比想象中更快
如果只计算KV Cache容量,它主要是线性增长的。
但实际GPU成本不是这么简单。
第一层成本来自KV Cache本身。上下文从100K增加到1M,单请求KV Cache理论上也可能接近增加10倍。
第二层成本来自Prefill。标准全注意力在长序列上的计算复杂度具有平方特征,因此输入长度增加以后,Prefill时间可能比单纯的token数量增长更加明显。
第三层成本来自Decode。上下文越长,每生成一个新token,需要处理的历史KV数据越多,内存访问压力也越大。
第四层成本来自并发下降。单请求占用的KV Cache越多,一张GPU能够同时容纳的请求越少。
第五层成本来自多GPU和跨节点通信。当单GPU容纳不了模型权重和KV Cache以后,系统必须增加并行度,而GPU之间的通信又会产生额外开销。
所以“上下文长度增加十倍,推理成本增加十倍”也不能作为普遍规律。实际成本可能低于,也可能明显高于这个比例,取决于模型架构、注意力实现、KV Cache精度、并发量、batch策略、GPU类型以及请求的输入输出比例。
这也是为什么AI厂商不会简单地把“上下文窗口越大”理解成纯粹的产品升级。一个模型从128K支持到1M,并不意味着服务器只需要把软件中的最大token参数改大八倍。
长上下文正在推动模型架构本身发生变化
如果所有模型都继续采用最传统的Multi-Head Attention,那么上下文长度不断扩大以后,KV Cache和注意力计算最终都会成为非常昂贵的资源。
因此,现代模型开始采用不同的结构减少这种压力,例如MQA和GQA通过减少Key/Value头数量降低KV Cache规模;滑动窗口注意力只让部分层或者部分token保持有限注意力范围;稀疏注意力则试图避免让每个token都与整个上下文发生计算;一些新架构还使用不同于传统KV Cache的注意力机制和缓存设计。
这意味着“百万token上下文”不能只看一个数字。两个都声称支持百万token的模型,如果一个采用标准全注意力、另一个大量使用GQA、滑动窗口、稀疏注意力或者其他缓存压缩机制,它们实际需要的GPU数量和推理成本可能完全不同。
未来的大模型竞争,也会因此从单纯比较参数量和上下文长度,逐渐转向比较单位GPU能够处理多少有效token、每个请求需要多少KV Cache、Prefill和Decode分别消耗多少资源,以及在真实并发条件下每百万token究竟需要多少GPU时间。
长上下文的价值当然很大。它可以让模型一次处理更长的代码库、法律文件、企业知识库、科研资料和复杂对话历史,但“能装进去”与“经济地运行起来”是两回事。对于AI基础设施,百万token上下文真正昂贵的地方并不是一个漂亮的上下文窗口数字,而是每一个新增token都可能继续占用缓存、消耗带宽、增加注意力计算,并挤压原本可以同时服务其他用户的GPU资源。未来谁能在保持模型效果的同时减少KV Cache、降低内存访问、提高批处理效率,并把长上下文的GPU成本压下来,谁才更有可能把超长上下文从技术演示变成真正具有商业规模的基础设施能力。
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP