
多个 AI 模型共享 GPU 时应该怎样调度,模型之间会产生哪些资源竞争
当多个AI模型共享同一块GPU资源时,调度策略会直接影响系统性能和资源利用率。这种场景常见于混合工作负载的AI服务器,例如同时运行多个推理服务、微调任务或其他计算作业。资源竞争的本质是有限的硬件资源与不同工作负载需求之间的矛盾,需要从显存、计算资源、带宽以及调度机制等方面进行分析。
在GPU硬件层面,显存容量是最直接的限制因素之一。当多个模型同时加载时,如果模型权重、KV Cache以及运行时所需的其他数据占用过多显存,就可能无法加载新的模型。例如,12B参数模型在FP16下,仅模型权重理论上约需24GB显存,实际运行还需要额外空间;更大的模型则需要更多显存。因此,不能只按照参数量计算最终显存需求,还要考虑推理或训练过程中的额外开销。
显存带宽同样会影响多个模型同时运行时的性能。当模型需要频繁读取权重、激活值或KV Cache时,不同任务可能争用显存带宽,使GPU计算单元等待数据。对于Transformer模型,部分推理负载尤其容易受到内存访问效率的影响。如果多个模型同时运行,显存带宽成为瓶颈后,即使GPU计算单元还有空闲资源,整体吞吐量也可能下降。
GPU计算资源也存在竞争。现代NVIDIA GPU包含CUDA Core、Tensor Core等不同类型的计算资源,不同模型和算子的使用特点并不相同。例如,大量矩阵乘法通常能够较好地利用Tensor Core,而其他算子可能主要消耗CUDA Core或受到内存访问限制。多个任务同时执行时,GPU硬件调度器会在可用资源之间进行安排,因此不同工作负载之间可能出现吞吐量下降或延迟波动。
软件层面的调度策略直接影响资源分配效率。常见方法包括:1)公平调度,根据任务需求分配计算时间;2)优先级调度,为延迟敏感或重要任务提供更高优先级;3)动态资源分配,根据实时负载调整资源配置;4)容器化隔离,通过Docker、Kubernetes等工具管理任务。需要注意的是,普通的容器化并不等于完整的GPU资源隔离,实际隔离能力还取决于GPU调度方式和底层硬件支持。
资源竞争通常集中在几个方面:1)显存容量竞争,可能导致模型无法加载;2)计算资源竞争,使任务吞吐量下降;3)显存带宽竞争,增加数据访问等待时间;4)CPU资源竞争,影响数据预处理和任务调度;5)网络带宽竞争,在分布式训练或多节点推理场景中影响通信效率;6)存储I/O竞争,影响模型加载和数据读取。例如多个任务同时从网络存储读取模型文件,就可能形成明显的I/O瓶颈。
实际工程中,资源竞争可能表现为GPU利用率波动、显存接近上限、推理延迟增加或者训练吞吐量下降。不过这些现象不能简单对应某一种故障。例如GPU利用率较低,可能是CPU数据准备、显存带宽或I/O速度不足,而不一定意味着GPU计算能力不足。因此,需要结合显存使用率、GPU计算利用率、内存带宽、CPU负载以及I/O等指标综合判断。
调度优化需要结合硬件和软件环境。在硬件层面,可以通过更高带宽的PCIe接口以及NVLink等高速互联技术改善数据传输和GPU之间的通信。在软件层面,可以使用vLLM、DeepSpeed等针对特定工作负载进行优化的框架,并通过量化、批处理、模型并行等方式降低资源压力。在集群环境中,还可以结合Kubernetes及相应的GPU调度组件,对不同任务进行资源分配和隔离。
GPU利用率低并不一定代表系统存在严重性能问题。例如某些推理任务本身计算量较小,GPU可能在等待CPU准备数据或等待请求;另一些任务则可能受到显存带宽限制。与此同时,显存容量和显存带宽属于不同的资源瓶颈,不能简单认为模型参数增加后一定首先受到显存容量限制,实际情况取决于模型结构、批量大小和具体工作负载。
实际部署中,可以优先采取以下措施:1)根据模型实际显存需求合理安排任务,避免显存过度超配;2)对适合的模型采用FP16、BF16或INT8等低精度方案降低资源占用;3)通过批处理和动态批处理提高GPU利用率;4)优化CPU数据加载和预处理流程,减少GPU等待;5)对延迟敏感和吞吐量优先的任务采用不同调度策略;6)持续监控显存、计算利用率、带宽和延迟等指标,根据实际负载调整资源分配。
多个AI模型共享GPU,本质上是在有限的计算、显存和带宽资源之间进行调度。合理的方案并不是简单追求GPU利用率最大化,而是根据不同任务的优先级、延迟要求和吞吐量目标进行资源配置。对于单机环境,应重点关注显存和计算资源竞争;对于多GPU或集群环境,则还需要考虑GPU之间的通信、网络和存储I/O。只有结合具体硬件和工作负载进行调度,才能在资源利用率与服务质量之间取得合理平衡。
多个 AI 模型共享 GPU 时应该怎样调度,模型之间会产生哪些资源竞争
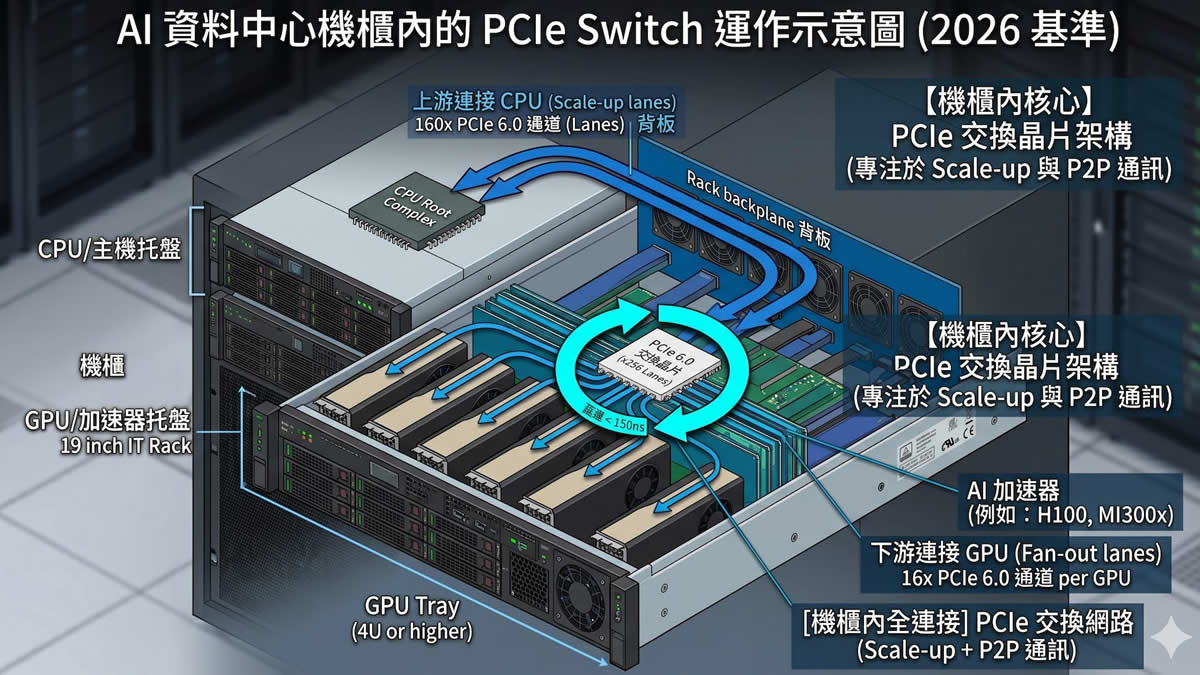
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP