
AI服务器如何平衡GPU、CPU、内存与网络,避免算力堆起来却跑不满
AI服务器的性能并不是简单由GPU数量决定。对于训练大模型、运行推理服务或处理高吞吐数据任务,GPU、CPU、系统内存、显存、存储和网络实际上构成了一条完整的数据处理链。任何一个环节明显落后于其他组件,都可能让昂贵的GPU无法发挥应有的性能。
因此,AI服务器的硬件设计不能简单理解为“GPU越多越好”,而应该根据具体工作负载确定各类资源之间的比例和通信方式。尤其是在多GPU和多服务器环境中,CPU处理能力、内存带宽以及GPU之间的互联网络,往往会成为决定实际效率的关键因素。
GPU是核心,但并不意味着其他硬件可以明显缩水
GPU承担矩阵运算、张量计算等主要任务,是AI服务器最重要的计算资源。在深度学习训练过程中,模型前向计算、反向传播以及大量张量运算都依赖GPU完成。
但是,GPU并不是一个完全独立运行的计算单元。训练数据需要从存储设备读取,经由系统内存和CPU进行数据加载、解码、预处理后,再传送到GPU。如果CPU处理能力不足,或者数据读取速度跟不上GPU的消耗速度,就会出现GPU等待数据的情况。
这也是为什么增加GPU数量之后,系统性能并不一定按照GPU数量同比增长。假设一台服务器原本只有两张GPU,CPU和存储系统能够满足需求;当GPU增加到八张甚至更多时,如果CPU核心数量、内存带宽和数据加载能力没有同步提高,就可能出现GPU利用率下降。
因此,CPU资源应当根据数据预处理复杂程度、数据加载方式、GPU数量以及应用框架进行配置,而不能仅仅按照“每张GPU对应多少个CPU核心”这样的固定比例机械设计。
显存容量与显存带宽必须同时考虑
对于AI计算,GPU显存与显存带宽同样重要。
显存容量决定模型、激活值、梯度以及优化器状态能否放入GPU,而显存带宽则决定数据在显存和计算单元之间移动的速度。容量不足和带宽不足属于两种完全不同的问题。
例如,NVIDIA A100提供40GB或80GB HBM2显存,并不是128GB。不同型号GPU的显存容量和带宽存在明显差异,因此不能简单以某一个GPU的参数代表整个AI服务器市场。
当模型或者训练状态超过单张GPU的显存容量时,也不能简单理解为“系统会自动把数据交换到内存中”。如果没有启用相应的显存管理、CPU内存卸载或模型分片机制,最直接的结果往往是显存不足并导致程序报错。
在大模型训练中,常见解决方案包括数据并行、张量并行、流水线并行、参数分片以及优化器状态分片等。对于部分推理和训练场景,也可以利用CPU内存甚至NVMe存储进行数据卸载,但这通常会带来明显的性能代价。
因此,选择GPU时不能只看FP16、FP8等理论算力,还必须关注显存容量、显存带宽以及GPU之间的高速互联能力。
CPU与系统内存决定数据能否持续供应
GPU计算速度越来越快以后,CPU和内存系统的重要性反而更加突出。
在训练任务中,CPU通常负责数据读取、解压缩、预处理、批次组织以及部分通信和任务调度工作。如果数据集存储在高速NVMe SSD上,而CPU核心数量不足,或者内存带宽无法满足多个GPU同时读取数据的需求,那么GPU就可能出现周期性等待。
这种情况下,即使GPU利用率只有50%甚至更低,也不能直接得出“GPU性能不足”的结论。问题可能发生在数据管道,而不是计算单元。
因此,在AI服务器设计中,应同时观察CPU利用率、内存带宽、存储吞吐量、数据加载队列以及GPU利用率。只有找到真正的瓶颈,才能决定应该增加GPU、CPU、内存还是存储性能。
多GPU环境下,网络往往成为新的瓶颈
当AI任务从单GPU扩展到多GPU之后,GPU之间的数据交换会迅速增加。
数据并行训练通常需要进行梯度同步,AllReduce就是其中最典型的通信操作。模型并行和张量并行则需要在不同GPU之间交换激活值、部分计算结果或其他模型状态。
当GPU数量增加时,计算时间可能不断缩短,但通信时间不会自动按照相同比例下降。如果GPU计算速度提高到原来的数倍,而GPU之间的互联带宽没有同步提升,通信等待就会在整个训练时间中占据越来越大的比例。
这也是大型AI服务器普遍采用NVLink、NVSwitch以及高速网络的重要原因。对于跨服务器训练,还可能使用InfiniBand或者基于以太网的RoCE技术。需要注意的是,InfiniBand和RoCE并不是同一种网络技术。RoCE是在以太网上实现RDMA,而InfiniBand则属于独立的高速互联网络体系。
此外,100Gbps网络的理论传输速率约为12.5GB/s,而不是100MB/s。实际吞吐量还会受到协议开销、网络拓扑、交换机、拥塞控制以及通信模式等因素影响,因此评估网络性能时不能只看标称带宽。
资源失衡时,最明显的表现是GPU利用率下降
AI服务器出现资源失衡时,最常见的现象之一就是GPU利用率长期偏低。
如果CPU无法及时完成数据预处理,GPU会等待输入;如果存储吞吐不足,数据加载队列就会成为瓶颈;如果显存带宽不足,计算单元可能等待数据;如果多GPU之间通信效率低,大量时间就会消耗在同步和数据交换上。
在多服务器训练中,网络问题尤其容易造成这种现象。部分GPU可能已经完成计算,但必须等待其他GPU完成通信和同步,最终形成“GPU看起来很强,实际训练速度却上不去”的情况。
这种情况下继续增加GPU往往不是最佳解决方案。因为新增GPU同时会增加通信和同步压力,如果网络、CPU或数据管道没有同步扩容,投入的硬件成本可能无法转化为相应的训练性能。
AI服务器设计不能套用固定硬件比例
实际上,很难给AI服务器规定一个适用于所有场景的固定GPU、CPU和内存比例。
大型模型训练更加关注GPU算力、显存容量、GPU互联以及跨节点网络;在线推理则更加关注单请求延迟、并发量、显存容量和网络吞吐;数据处理和传统机器学习任务则可能更加依赖CPU、系统内存和存储性能。
因此,合理的设计方法应该从工作负载反推硬件配置。
如果主要任务是单机多GPU训练,应重点关注GPU之间的高速互联、CPU数据供应能力和内存带宽。如果是大规模分布式训练,则必须进一步考虑节点之间的网络带宽、通信延迟、交换机架构以及拓扑设计。如果主要运行推理服务,则需要根据模型大小、并发请求数量以及延迟目标决定GPU数量和网络配置。
软件层面的优化同样重要
硬件配置合理之后,还需要通过软件把资源真正利用起来。
在深度学习训练中,可以通过数据预取、并行数据加载、混合精度、梯度累积以及计算与通信重叠等方式减少等待时间。对于分布式训练,还可以根据模型特点选择数据并行、张量并行、流水线并行等策略。
在服务器管理层面,Kubernetes等平台可以配合GPU相关插件实现GPU资源调度,但HPA等自动扩缩容机制并不是简单地“检测GPU负载后自动增加物理GPU”。真正实现GPU节点自动扩容,还需要底层集群具备相应的节点自动扩展、云资源或基础设施编排能力。
因此,AI基础设施的优化实际上是硬件、网络和软件共同作用的结果。
AI服务器真正追求的是整体吞吐量
衡量一台AI服务器是否设计合理,不能只看GPU型号和数量,更应该观察GPU实际利用率、每秒处理样本数、训练吞吐量、显存占用、CPU利用率、内存带宽、存储吞吐量以及GPU间通信效率。
如果增加一倍GPU只能获得30%甚至更低的性能提升,那么问题通常并不在“GPU不够多”,而在于系统中存在新的瓶颈。
AI计算的发展已经从单纯追求GPU算力,逐渐转向整个计算系统的协同优化。真正高效的AI服务器,并不是把最多的GPU塞进机箱,而是让计算、显存、CPU、内存、存储和网络形成匹配的数据通路。只有各个环节能够持续为GPU提供数据并及时完成通信,昂贵的GPU算力才能真正转化为实际的训练和推理性能。
AI 服务器如何设计 GPU、CPU、内存和网络的比例,资源失衡会带来什么问题
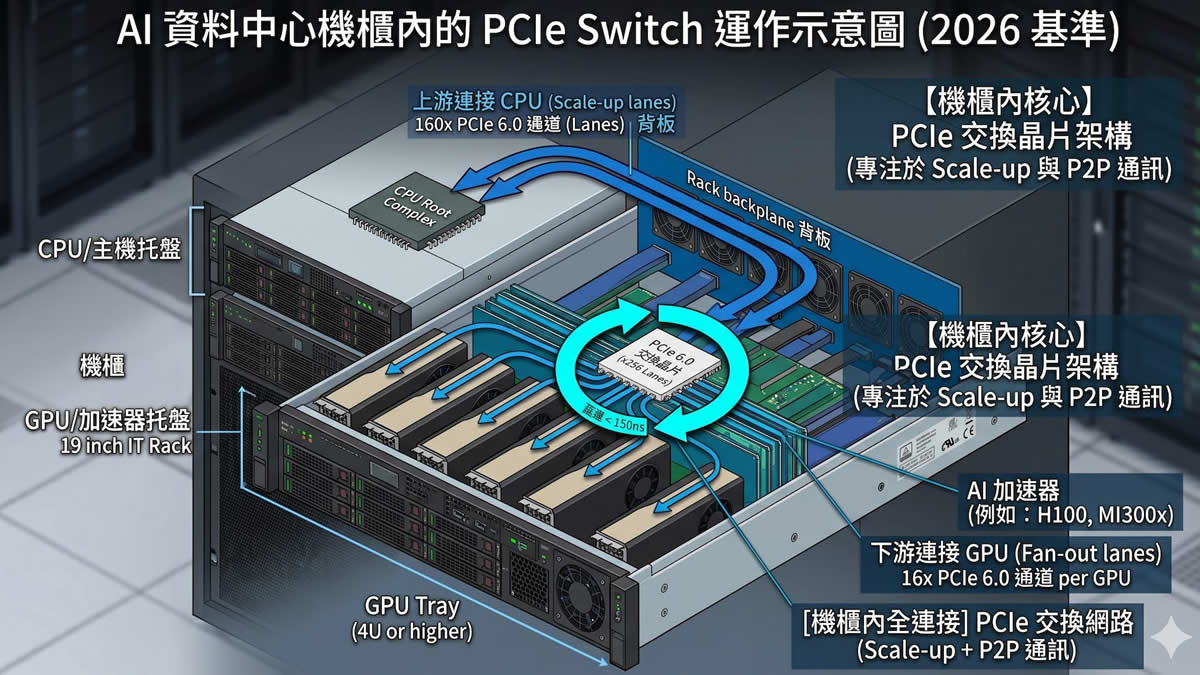
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP