
大型模型遇到HBM容量不足时,问题并不是简单的“显卡显存不够”,而是模型参数、运行时状态、激活值、KV Cache以及训练状态共同超过了当前GPU本地高速内存能够容纳的范围。工程上真正需要解决的是如何重新安排这些数据的位置,以及哪些数据必须留在GPU附近,哪些数据可以放到其他层级的内存中。HBM容量决定了GPU能够以最高效率直接访问多少工作集,但它并不是整个AI系统唯一可以使用的内存。CPU内存、GPU之间的高速互联、PCIe、NVMe以及网络存储都可以参与数据供给,只是距离GPU越远,访问成本通常越高。
HBM容量和模型参数量之间的关系可以先从最简单的推理场景理解。50 billion参数的模型,如果权重全部以FP16或BF16保存,仅权重本身就需要大约100GB,而不是1.25TB。1.25TB对应的是50 billion参数按照每个参数5字节左右计算的情况,并不符合FP16参数的基本存储关系。FP16和BF16都是2字节,因此50B参数约需要100GB权重空间。这个数字仍然只是模型权重,并没有计算KV Cache、临时workspace、CUDA运行时分配以及其他缓冲区。训练则完全是另一回事,因为梯度、优化器状态和激活值可能让实际显存需求远高于权重本身。
因此,面对HBM容量限制,第一步并不是寻找一个所谓“显存压缩开关”,而是先判断到底是哪一类数据占满了HBM。推理服务主要受到模型权重、KV Cache和运行时缓冲区影响;训练则还需要考虑激活值、梯度以及优化器状态。不同类型的显存压力对应完全不同的解决方案。如果是权重容量不足,量化、模型分片和CPU offload可能有效;如果是KV Cache增长导致OOM,应该从batch size、上下文长度、KV Cache精度、Paged Attention和缓存管理入手;如果是训练激活值占用过大,则activation checkpointing、micro-batch和模型并行更加直接。
多GPU模型并行是突破单张GPU HBM容量限制最直接的办法之一。Tensor Parallelism可以把一个Transformer层中的矩阵计算拆分到多个GPU,让参数和计算工作集分散在不同GPU上;Pipeline Parallelism则可以把不同模型层分配给不同GPU;在更复杂的训练系统中,还可以采用Tensor Parallelism、Pipeline Parallelism和数据并行的组合。这里需要区分“数据并行”和“模型并行”。数据并行主要让不同GPU处理不同输入批次,每张GPU通常仍然需要保存模型副本;模型并行则直接解决单GPU放不下模型的问题,但代价是GPU之间必须频繁交换数据。
这也是为什么多张GPU的显存不能简单理解成一块可以随意使用的“总显存”。例如8张80GB GPU理论上拥有640GB HBM,但一个普通程序不会因为机器里插了8张GPU,就自动获得一个640GB的统一高速地址空间。模型需要通过分片、并行策略或者专门的运行时系统把不同参数和计算任务安排到不同GPU,同时处理GPU之间的数据交换。NVLink、NVSwitch以及PCIe能够显著改善这种通信条件,但它们并不会消除模型并行产生的通信成本。
量化则是在不增加GPU数量的情况下减少模型权重占用的重要办法。FP16和BF16权重通常每个参数占2字节,INT8则通常可以将权重存储压缩到每参数1字节左右,4-bit量化则进一步降低到约0.5字节,但实际模型占用不会严格等于参数量乘以这个数字,因为还需要考虑scale、zero point、元数据、未量化层以及运行时缓冲区。更重要的是,“INT8就是FP16的四分之一”只适用于权重存储这一层面的粗略计算,不能直接理解成整个推理系统的显存需求也变成四分之一。
量化也并非简单的“精度越低越好”。不同模型、不同层以及不同推理框架对量化误差的敏感程度不同。权重量化、激活量化和KV Cache量化解决的是不同问题,W8A8、W4A16等方案的计算路径也并不相同。对于大型语言模型,4-bit权重量化能够显著降低模型进入GPU所需要的存储空间,但如果上下文很长,KV Cache仍然可能成为新的显存瓶颈。因此,看到一个模型能够以4-bit方式装入GPU,并不意味着长上下文、高并发场景也一定能够正常运行。
剪枝和蒸馏属于另一类方法。剪枝减少模型中的参数或计算结构,蒸馏则通过较小模型学习大型模型的行为,两者都可能降低部署成本,但它们不是解决运行时OOM的即时手段。剪枝是否能够获得实际收益,还取决于剪掉的结构是否能够被底层GPU和推理框架有效利用。如果只是删除了一些参数,却没有形成硬件友好的稀疏结构,理论上的参数减少未必能够转化成同等比例的显存和计算收益。
训练阶段则需要完全不同的显存管理策略。ZeRO、FSDP等参数分片技术可以把参数、梯度以及优化器状态分散到多个GPU或不同存储层级,使单张GPU不必承担完整训练状态。这里不能简单说“ZeRO把显存降低到三分之一”。具体节省多少取决于使用的是哪一级ZeRO、数据类型、优化器以及并行方式。以Adam类优化器为例,模型参数、梯度和优化器状态本身就可能产生远大于模型权重的内存需求,因此训练大型模型时,真正需要优化的往往不是单纯的“模型参数显存”。
Activation Checkpointing也是训练中非常重要的方法。它并不是把完整激活值全部保存下来,而是只保存部分检查点,反向传播时重新计算其他中间结果,以计算时间换取显存空间。这种方法的本质是减少同时驻留在GPU内存中的activation数量。它通常比所谓“把训练数据压缩一下”更加直接,因为训练OOM很多时候并不是数据集文件太大,而是单个micro-batch在前向和反向传播过程中产生的中间激活值太多。
梯度累积也需要纠正一个常见误解。梯度累积并不会简单地把单批次显存占用变成原来的三分之一,也不是“累积3个批次就降低到1/3”。它的主要作用是让GPU以较小的micro-batch进行多次前向和反向计算,然后再执行一次参数更新,从而在有限显存下获得较大的effective batch size。它可以避免为了追求大batch而一次性把更多样本放进GPU,但每一个micro-batch仍然需要自己的激活和工作空间,因此显存降低幅度取决于具体训练实现。
另一个经常被误认为是“显存压缩”的方法,是使用Zstandard之类的通用压缩算法。Zstandard非常适合压缩模型文件、检查点和数据集文件,但不能因此得出“压缩40%就能让HBM多出40%空间”的结论。GPU进行矩阵计算时需要能够直接使用适当格式的tensor,压缩后的Zstd字节流不能直接当成普通FP16权重参与Tensor Core计算。系统必须先解压,再完成必要的数据转换和GPU传输。因此,文件压缩解决的是磁盘容量和I/O问题,不等于运行时HBM压缩。
当单GPU HBM不足时,CPU系统内存就成为一个重要的第二层容量。现代GPU计算框架可以使用pinned host memory、Unified Memory、mapped host memory以及各种CPU offload机制,把部分数据放在主机内存中,需要时再传输到GPU。这样可以让原本无法完全装入HBM的模型运行起来,但代价是数据移动速度和访问延迟通常远逊于GPU本地HBM。如果某个模型层频繁访问被放在CPU内存中的数据,GPU就可能出现等待数据的情况,最终性能下降到无法接受。
这也是AI基础设施中经常出现的一个工程判断:能够运行和能够高效运行是两个完全不同的问题。一个100GB模型通过CPU offload在80GB GPU上启动,并不意味着它等同于一张拥有100GB HBM的GPU。真正决定性能的,是哪些数据被offload、数据移动频率是多少、CPU内存带宽如何、PCIe或其他互联是否成为瓶颈,以及计算和数据传输能否重叠执行。如果offload发生得过于频繁,GPU Tensor Core再快也可能大量时间处于等待状态。
GPU之间的互联同样需要放到这个层级体系中理解。PCIe、NVLink和NVSwitch解决的是不同规模的数据交换问题。PCIe 5.0 x16的理论单向带宽约为64GB/s,双向合计约128GB/s,而具体实际有效吞吐还会受到协议开销、平台拓扑和设备实现影响。NVLink的带宽则取决于具体代际和GPU平台,不能拿一个固定的“900GB/s”数字代表所有NVLink系统。尤其是大型GPU服务器,还必须考虑GPU之间究竟是直接NVLink连接、通过NVSwitch互联,还是部分流量需要经过PCIe Root Complex。拓扑结构本身就可能决定模型并行的效率。
存储系统主要承担更低层级的数据供应和持久化任务。NVMe SSD可以用于模型文件、数据集、checkpoint、缓存和部分offload场景,但SSD不应该被理解成“HBM的慢速替代品”。即使高端NVMe SSD拥有数GB/s甚至更高的顺序吞吐,其随机访问延迟和CPU/GPU数据路径仍然与HBM存在数量级差异。对于训练系统,更有效的办法通常是通过本地NVMe缓存、数据预取、分片文件以及高效DataLoader,让数据提前进入CPU内存和GPU可访问区域,而不是让GPU在计算过程中频繁等待SSD读取。
对于大型训练集群,网络存储又是另外一个问题。如果几十甚至上百张GPU同时读取数据,单个存储节点或者网络链路很容易成为瓶颈。工程上通常需要把数据集进行sharding,减少大量小文件产生的元数据和随机I/O压力,并结合本地缓存和预取机制,让计算节点尽量保持稳定的数据供应。否则即使每张GPU都有足够HBM,也可能因为数据读取速度不足而导致GPU利用率长期偏低。
模型部署还必须区分“权重容量”和“运行时容量”。例如一个70亿参数模型使用FP16保存权重,理论权重容量大约是14GB,而不是“至少80GB HBM”。实际推理时还需要为KV Cache、CUDA workspace、框架开销以及并发请求预留空间,所以一张16GB GPU是否能够稳定运行,取决于上下文长度、batch size、量化方式、推理框架和模型结构。如果采用8-bit或4-bit权重量化,权重部分可以进一步缩小,但高并发和长上下文仍然可能让KV Cache成为主要消费者。
对于推理服务器,HBM容量设计最终应该围绕实际工作集计算,而不是只看模型参数量。单用户短上下文推理和高并发长上下文服务,即使使用完全相同的模型,显存需求也可能相差很大。尤其是在大语言模型服务中,随着并发请求增加,KV Cache会持续占用GPU内存。如果服务框架没有良好的缓存分页、复用和淘汰策略,模型权重本身没有变化,GPU却仍然可能因为请求数量增加而OOM。
所以,HBM不足并不存在一个万能方案。模型权重太大,可以考虑量化、模型分片和多GPU;训练激活值太大,可以考虑Activation Checkpointing、micro-batch和梯度累积;训练状态太大,可以使用ZeRO、FSDP等分片方案;KV Cache过大,则应该从上下文长度、并发控制、KV Cache精度和缓存管理入手;GPU本地容量不足但CPU内存充足,可以考虑offload;数据供应速度不足,则应该优化NVMe、本地缓存、网络存储和预取,而不是继续增加HBM容量。
对于专业工程环境,诊断显存瓶颈时最好同时记录GPU HBM使用量、权重占用、KV Cache占用、activation占用、GPU利用率、Tensor Core利用率、HBM带宽利用率、PCIe吞吐、GPU间通信吞吐、CPU内存压力以及数据加载等待时间。只有把这些指标放在同一条时间线上,才能判断系统到底是容量瓶颈、内存带宽瓶颈、GPU计算瓶颈还是数据供应瓶颈。很多所谓“显存不够”的问题,最后发现并不是GPU容量本身太小,而是模型并行方式、缓存策略、batch设计或者数据流设计没有匹配硬件拓扑。
HBM的价值就在于它把GPU最频繁访问的数据放在极高带宽、低延迟的本地内存中。大型模型突破HBM容量限制的工程思路,并不是把所有数据都强行塞进HBM,而是建立合理的内存层级,让最热的数据留在GPU本地,把可以接受更高访问成本的数据放到CPU内存、NVMe或更远的存储系统,同时利用并行计算和数据预取隐藏传输延迟。大型模型时代,决定系统能力的已经不只是GPU有多少GB显存,而是整个计算平台能否把容量、带宽、互联和计算资源组织成一个有效的数据流。
HBM 容量有限时大型模型应该怎样处理,显存不足有哪些常见解决方案
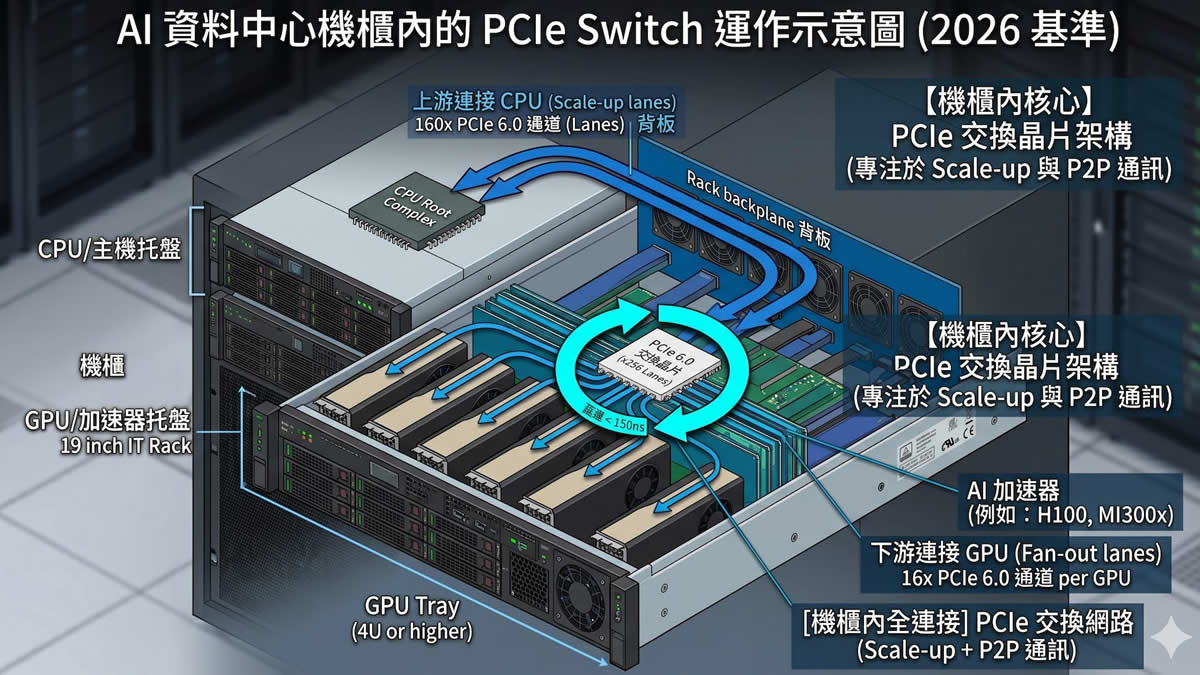
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP