
很多人测试本地大语言模型时,会看到一个非常直观的数字,比如每秒生成20 Token、40 Token或者100 Token,然后自然地认为显卡越快,Token生成速度就一定越高。实际情况没有这么简单。
大语言模型推理并不是一个单纯的GPU算力问题。模型参数需要存放在显存或者其他内存层级中,矩阵计算需要计算单元参与,生成过程中还要维护KV Cache,多个GPU之间可能需要通信,而在线服务还会受到Batch、并发请求、上下文长度、调度策略以及CPU和网络延迟影响。
因此,“每秒多少Token”只是最终表现,背后可能对应完全不同的瓶颈。
理解Token生成速度,首先需要把LLM推理拆成两个阶段,也就是Prefill和Decode。两者使用的硬件资源和性能瓶颈并不完全一样。
一、Prefill和Decode决定了为什么同一块GPU表现会完全不同
用户输入一段提示词后,模型首先需要处理整个输入上下文,这个阶段通常称为Prefill。
例如用户一次输入5000个Token,模型需要处理这批输入并建立后续生成所需要的状态,其中包括KV Cache。
Prefill通常具有较高的计算并行度,因此GPU Tensor Core等计算资源更容易得到充分利用。在很多情况下,Prefill更接近计算密集型工作负载。
进入生成阶段以后,情况发生变化。
模型通常一次生成一个或者少量Token,每生成新的Token,都需要利用已经存在的KV Cache来完成后续计算。
这个阶段就是Decode。
Decode阶段的计算规模和Prefill不同。对于很多模型和典型Batch配置来说,Decode更容易受到显存带宽、KV Cache访问、内存容量以及调度效率影响。
因此一块GPU可以在Prefill阶段显示很高的计算利用率,但在Batch较小的Decode阶段,GPU利用率看起来并不高,Token生成速度却已经接近当前工作负载能够达到的水平。
这也是为什么不能简单看到“GPU利用率只有50%”就断定GPU没有发挥性能。
二、GPU算力当然重要,但不是唯一决定因素
现代GPU通常拥有大量CUDA Core、Tensor Core以及非常高的FP16、BF16、FP8等矩阵计算能力。
Transformer中的线性层和注意力计算都包含大量矩阵运算,因此GPU计算能力会直接影响推理性能。
但是理论算力并不等于实际Token生成速度。
例如两张GPU理论FP16算力差距很大,如果当前模型的Decode阶段主要受HBM访问限制,那么更高的理论TFLOPS并不能按照相同比例转化成更高的Token/s。
这属于典型的计算受限和内存受限差异。
计算受限时,提高Tensor Core计算能力可能明显提高性能。
内存受限时,更高的显存带宽、更加紧凑的数据表示以及更好的缓存访问模式可能更加重要。
所以评价一张GPU是否适合LLM推理,不能只看TFLOPS或者TOPS,还应该同时看显存容量、HBM带宽、支持的数据类型、互联带宽以及软件栈。
三、显存带宽为什么会影响Decode速度
LLM模型包含大量参数。
以70B参数模型为例,如果使用16-bit浮点数,仅参数本身就需要大约140GB的存储空间,不包括KV Cache、运行时缓冲区以及其他开销。
如果采用8-bit或者更低精度表示,参数占用可以显著降低。
但是量化并不是简单地“把所有数字除以2”。
不同量化方案可能采用不同的分组方式、缩放参数以及计算路径,有些方案还需要在特定层保持较高精度。
因此实际显存占用和性能提升需要根据具体模型、量化格式和推理框架测试。
对于Decode来说,如果GPU需要反复从HBM读取大量模型权重,而每次生成的Token带来的计算量相对有限,就可能形成典型的内存带宽瓶颈。
这时候GPU计算单元可能没有完全饱和,但HBM已经承担了大量数据搬运。
因此“GPU利用率不高”与“显存带宽已经成为瓶颈”可以同时成立。
四、KV Cache是长上下文推理中的重要资源
Transformer生成文本时,不需要每次都从头重新计算所有历史Token。
模型会把注意力机制中的Key和Value保存下来,这部分缓存就是KV Cache。
随着上下文不断增长,KV Cache也会增长。
其实际占用取决于模型层数、KV头数量、每个头的维度、数据精度以及当前活跃序列长度等因素。
因此不能简单说“70B模型生成512个Token就一定需要100GB KV Cache”。
KV Cache并不是由参数量直接决定的。
两个参数量都接近70B的模型,如果一个使用标准多头注意力,另一个使用Grouped-Query Attention或者Multi-Query Attention,两者的KV Cache占用可能出现很大差异。
这也是现代LLM架构设计中GQA等技术的重要意义之一。
减少KV头数量可以在一定程度上降低KV Cache的容量和访问压力。
五、上下文越长,性能问题越复杂
假设一个模型正在处理非常长的上下文。
随着上下文增长,KV Cache会越来越大。
这会带来两个问题。
第一个问题是容量。
GPU显存必须能够容纳模型参数、KV Cache以及推理运行时所需的其他缓冲区。
第二个问题是访问成本。
即使KV Cache能够放进GPU显存,随着缓存规模扩大,注意力计算仍然需要处理越来越多的历史Token。
因此长上下文不仅影响显存容量,也会影响计算量、内存访问以及最终的Token生成延迟。
当KV Cache无法全部留在高速GPU显存中时,如果推理系统需要把部分状态放到CPU内存甚至其他存储层级,性能可能进一步下降。
不过现代推理框架通常会通过Paged KV Cache、缓存管理以及调度策略尽可能避免低效的数据搬运。
六、不要把Decode阶段简单说成O(n²)
原稿把Transformer自注意力的O(n²)复杂度直接等同于每个Token生成过程,这是一个常见但过于粗略的说法。
对于Prefill阶段,输入序列中的Token之间需要进行注意力计算,序列长度增长确实会显著增加注意力相关计算量。
但在使用KV Cache进行自回归Decode时,新生成的Query通常只需要与已经缓存的Key和Value进行注意力计算,而不是每次都从头计算完整的历史序列。
因此Decode阶段随着上下文长度增长,计算和内存访问仍然会增加,但不能简单描述成“每生成一个Token都重新执行完整的O(n²)注意力”。
理解这一点对于分析长上下文推理性能非常重要。
七、Batch Size会直接改变Token生成速度
单用户、单序列推理和高并发服务的性能完全不同。
如果一次只服务一个请求,GPU可能没有足够大的矩阵计算规模来充分利用计算资源。
增加Batch或者并发序列以后,可以把多个请求的计算组合起来,从而提高GPU计算资源利用率和整体吞吐量。
但是Batch并不是越大越好。
随着Batch增大,KV Cache占用、调度复杂度、显存压力以及单个请求等待时间也可能增加。
对于在线聊天服务,用户关心的是TTFT、ITL和P99延迟。
TTFT是Time to First Token,也就是用户发送请求之后等待第一个Token出现的时间。
ITL通常表示生成Token之间的时间间隔。
而服务端还会关注tokens/s、requests/s以及P50、P95、P99延迟。
如果一味增加Batch导致GPU吞吐量提高,但用户等待时间明显增加,那么对于在线服务来说未必是优化。
八、GPU利用率不是Token速度的直接答案
很多监控软件都会显示GPU utilization。
这个指标非常有用,但不能单独拿来判断LLM推理性能。
例如Decode阶段可能受到HBM访问限制,GPU计算单元并没有持续满负荷运行。
这时GPU利用率可能低于某个计算密集型任务,但Token/s已经达到当前工作负载的瓶颈。
反过来,GPU利用率很高,也不意味着用户体验一定好。
如果Batch非常大,GPU可能获得很高吞吐量,但单个请求的延迟可能明显增加。
因此LLM性能测试应该同时观察GPU计算利用率、HBM带宽、显存容量、KV Cache占用、SM或Tensor Core活动、Token吞吐量以及用户侧延迟。
九、多GPU推理时,GPU之间怎么通信非常重要
当模型无法放入一张GPU时,就需要采用模型并行、张量并行、流水线并行或者其他分布式策略。
这时候问题从“单GPU性能”扩展成“多GPU协同性能”。
如果采用Tensor Parallelism,一个模型层中的计算可能被拆分到多张GPU上。
这些GPU需要在计算过程中交换数据。
GPU之间的互联方式就变得非常重要。
在同一台服务器内部,NVLink、NVSwitch等高速互联可以提供远高于普通PCIe链路的GPU间通信能力。
如果跨服务器,则通常需要依靠InfiniBand或者高性能以太网/RoCE等网络。
因此同样是8张GPU,放在一台具有高速GPU互联的服务器中,与分散在不同服务器中通过网络连接,实际推理性能可能完全不同。
十、网络并不是所有LLM推理的瓶颈
原稿把网络通信描述得过于普遍。
如果模型完全运行在一台服务器的一张GPU上,那么用户电脑到服务器之间的网络延迟通常不会决定GPU内部的Token计算速度。
网络主要影响请求进入服务器、结果返回以及分布式推理中的跨节点通信。
如果采用跨服务器Tensor Parallelism,网络就可能成为关键因素。
但如果模型使用的是数据并行,也就是每张GPU或者每台服务器各自运行完整模型,不同请求被分配到不同实例,那么跨GPU同步需求可能与模型并行完全不同。
因此看到“多GPU”不能直接推断存在严重网络通信瓶颈,必须先确认具体并行方式。
十一、不要把AllReduce当成推理中的默认通信方式
AllReduce在分布式训练中非常重要,因为训练过程中需要同步梯度。
推理阶段并不需要同步梯度,因此通信模式与训练明显不同。
模型并行推理更常见的是根据具体并行策略进行All-Gather、Reduce-Scatter、点对点通信以及其他集合通信操作。
例如Tensor Parallelism中的某些计算阶段需要在GPU之间交换中间结果。
NCCL可以负责GPU集合通信,而底层可能使用NVLink、PCIe、InfiniBand或RoCE等不同互联路径。
因此讨论“推理网络通信”时,不能简单用“训练需要AllReduce,所以推理也主要依靠AllReduce”来解释。
十二、网络带宽和延迟必须结合通信规模来看
假设网络是100Gbps。
这只是链路理论带宽,并不能直接告诉你某个模型的Token生成速度。
实际通信效率还受到消息大小、消息数量、网络拓扑、拥塞、协议栈、DMA、GPU Direct RDMA、交换机配置以及通信计算重叠程度影响。
同样,100微秒延迟也不能单独判断系统一定慢。
如果某项通信每次只发生一次,那么100微秒可能影响有限。
如果某个模型每生成一个Token都需要进行多次跨节点通信,那么这部分延迟就可能不断累积。
因此网络性能应该放在具体并行算法和通信模式中分析。
十三、模型结构本身也决定了硬件怎么被使用
不同模型架构对GPU资源的需求并不一样。
传统Dense Transformer在每次推理时需要执行大量模型参数对应的计算。
MoE,也就是Mixture of Experts,则只激活部分专家,因此可以在保持较大总参数规模的同时降低每个Token实际参与计算的参数数量。
但是MoE并不是免费获得性能。
Token需要经过Router分配给不同专家。
如果专家分布在不同GPU甚至不同服务器上,就可能产生额外的数据交换。
因此MoE性能不仅取决于“每个Token激活多少参数”,还取决于专家布局、负载均衡、通信方式以及推理框架。
十四、量化到底为什么可以提高推理效率
量化最直接的作用之一,是降低模型参数的存储需求。
例如FP16模型参数使用16-bit表示,而某些INT8、FP8或更低比特量化方案可以使用更紧凑的数据表示。
模型变小之后,一方面更容易放入GPU显存,另一方面在特定硬件和推理框架上,可以减少内存带宽压力,并使用对应的低精度计算路径。
但量化并不等于“精度越低,速度一定越快”。
不同GPU对FP16、BF16、FP8、INT8、INT4等格式的硬件支持不同。
推理框架也必须提供高效kernel。
某种量化格式如果需要大量额外转换操作,实际速度提升可能并不明显。
同时,量化可能影响模型输出质量,因此需要结合任务进行验证。
十五、CPU也可能成为瓶颈
虽然LLM主要计算发生在GPU上,但CPU并不是无关紧要的。
请求解析、Tokenization、调度、数据准备、网络处理以及部分缓存管理工作仍然可能由CPU承担。
如果同时运行大量并发请求,而CPU核心数不足,或者Tokenization成为瓶颈,就可能出现GPU等待CPU提交工作的情况。
这时GPU利用率可能下降,但增加GPU数量并不能解决根本问题。
因此高性能推理服务器需要同时观察CPU使用率、CPU核心分布、NUMA布局、PCIe拓扑、内存带宽以及GPU利用率。
在多GPU服务器中,GPU连接到哪个CPU NUMA节点同样可能影响数据传输效率。
十六、推理框架的效率可能比换一张GPU更重要
现代LLM推理并不是简单调用一个模型文件然后让GPU运行。
推理框架会负责Kernel选择、KV Cache管理、Batch调度、量化、张量并行、流水线并行以及通信。
不同框架和不同版本的Kernel实现可能产生明显性能差异。
FlashAttention等优化可以减少注意力计算中的中间内存访问。
Paged KV Cache可以改善大量动态请求下的KV Cache管理。
Continuous Batching可以在不同请求陆续到达时动态组合正在运行的序列,从而提高GPU利用率。
这些优化往往比单纯增加一个“GPU利用率”指标更能说明推理系统是否设计合理。
十七、Token速度应该怎么测
如果要认真比较两套LLM推理系统,不应该只运行一句话然后看终端显示的Token/s。
至少应该记录输入Token数量、输出Token数量、TTFT、ITL、总生成时间、吞吐量、并发数以及P50、P95、P99延迟。
还应该固定模型版本、量化方式、上下文长度、采样参数以及最大输出长度。
否则一个系统使用短Prompt、另一个系统使用长上下文,直接比较Token/s没有太大意义。
同样需要区分Prefill吞吐量和Decode吞吐量。
有些系统第一个Token出来很快,但后续Token生成速度一般。
有些系统首Token延迟比较高,但连续生成速度非常快。
对于聊天机器人,这两种性能特征对用户体验的影响并不相同。
十八、实际排查时怎样判断到底哪里出了问题
如果Token生成速度很低,可以先观察GPU计算利用率和HBM活动。
如果GPU计算单元长期高负载,同时显存带宽并未明显成为瓶颈,那么更高的计算能力或者更好的Kernel可能有帮助。
如果GPU计算利用率不高,但HBM带宽已经非常繁忙,则需要重点检查模型权重访问、KV Cache以及数据精度。
如果显存容量接近极限,则应该检查模型量化、KV Cache容量、Batch以及上下文长度。
如果单GPU运行正常,多GPU运行明显变慢,则需要检查GPU互联拓扑、Tensor Parallelism、通信量以及NCCL性能。
如果跨服务器运行明显慢于单机运行,则进一步检查InfiniBand或RoCE链路、交换机、NUMA、RDMA以及通信计算是否能够重叠。
如果GPU利用率长期很低,同时CPU负载很高,则需要检查Tokenization、请求调度、数据准备和应用层代码。
如果Batch增加以后吞吐量提高但P99延迟急剧增加,则说明系统可能已经从追求吞吐量转向牺牲在线服务延迟。
这才是工程上真正有价值的性能分析。
十九、Token生成速度没有一个固定的“最佳配置”
不同模型、不同GPU、不同上下文长度以及不同业务场景,对硬件的需求完全不同。
一个小型7B模型运行在单张消费级GPU上,主要问题可能是Kernel效率和单序列Decode性能。
70B级模型运行在多张数据中心GPU上,问题可能转变成HBM容量、KV Cache管理和GPU间通信。
如果进一步扩展到多服务器推理,网络拓扑、RDMA、交换机以及通信计算重叠就可能成为重要因素。
而在线AI服务与离线批处理又是两种不同的优化目标。
在线聊天通常更关注TTFT、ITL和P99延迟。
离线批量生成则更关注总Token吞吐量。
因此没有一个“Batch越大越快”“GPU利用率越高越好”或者“网络带宽达到100Gbps就足够”的通用答案。
Token生成速度本质上是一个系统级指标。
GPU计算能力决定可以做多少计算,HBM带宽决定大量模型数据和缓存数据能够多快被访问,显存容量决定模型和KV Cache能否在合适的存储层级中运行,模型架构决定需要进行多少计算以及多少通信,CPU和调度系统决定GPU能否持续获得工作,而多GPU和多服务器场景中的互联则决定这些计算资源能否高效协同。
所以,当一台机器从每秒20 Token提升到每秒40 Token时,最有价值的问题不是简单问“换什么显卡”,而是先确认当前瓶颈究竟是计算、HBM带宽、显存容量、KV Cache、CPU调度、GPU互联还是网络通信。
只有先确定瓶颈,再选择量化、Kernel优化、Batch调整、KV Cache管理、GPU升级或者网络升级,性能优化才有明确方向。对于LLM推理来说,最昂贵的错误往往不是硬件不够快,而是花钱升级了一个根本没有成为瓶颈的部分。
Token 生成速度受哪些因素影响,GPU、显存、网络和模型结构如何共同决定性能
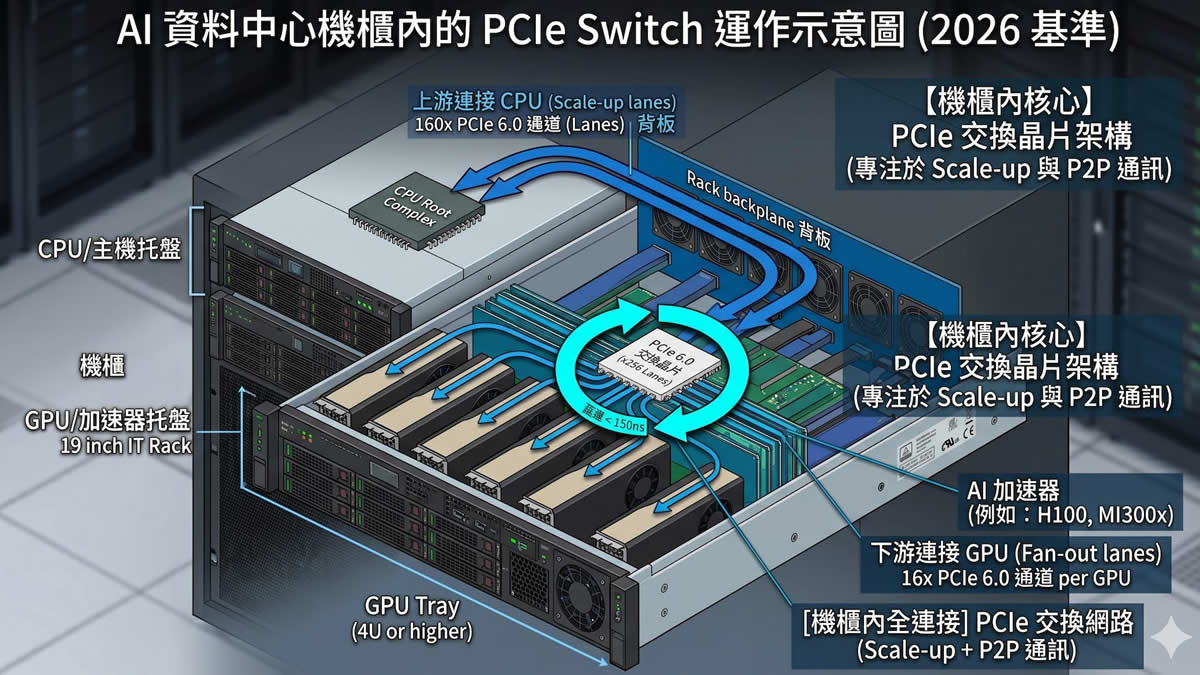
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP