
训练和运行大模型时,很多人首先想到的是 GPU 算力,但真正让大模型无法运行的第一个问题,往往是显存容量。
例如,一台服务器安装了一张 80GB 显存的 NVIDIA A100,GPU 本身的计算能力并不意味着它就能够运行任意一个参数规模达到数百亿甚至上千亿的模型。如果模型权重、运行时缓存以及计算过程中产生的中间数据加起来超过 80GB,即使 GPU 还有大量计算能力,也没有办法把整个模型直接装进去。
这就是模型并行首先要解决的问题:当一张 GPU 的显存装不下一个模型时,把模型拆开,让多张 GPU 共同保存和计算这个模型。
为什么参数量只是第一层显存压力
以一个 1750 亿参数的模型为例,如果采用 FP16 或 BF16,每个参数通常占用 2 字节,仅模型权重本身就需要大约 350GB 显存。这个数字已经远远超过单张 80GB GPU 的容量。
但训练大模型时,350GB 还不是全部。
训练过程中还需要保存梯度,并且 Adam 一类优化器通常需要额外的优化器状态。再加上激活值、临时计算缓冲区以及通信所需要的内存空间,实际训练所需要的 GPU 内存远远大于“参数数量乘以每个参数多少字节”。
因此,一个几百 GB 权重规模的模型,并不意味着准备几百 GB 显存就能够直接开始训练。真正的训练显存需求通常要大得多。
推理则是另一种情况。
如果只是运行已经训练好的模型,通常不需要保存训练阶段的梯度和优化器状态,但生成式模型在长上下文推理过程中还会产生 KV Cache。用户连续输入几千甚至几万 token 后,KV Cache 会随着上下文和并发请求增长,最终成为非常现实的显存压力。
因此,判断一张 GPU 能不能运行某个模型,不能只看模型参数量,还要看精度、上下文长度、批量大小、并发量以及具体推理框架的显存管理方式。
数据并行为什么不能解决这个问题
假设一个模型需要 120GB 显存,而服务器有两张 80GB GPU。
很多人第一反应是使用数据并行。
数据并行的基本思路是每张 GPU 都保存一份完整模型,然后把不同的数据批次交给不同 GPU 处理。例如 GPU 1 处理第一批图片,GPU 2 处理第二批图片,计算完成后再同步梯度。
这种方法非常适合提高吞吐量,但这里存在一个根本问题:每张 GPU 都必须先放下完整模型。
如果模型需要 120GB,而每张 GPU 只有 80GB,那么即使有两张、四张甚至八张 GPU,单纯的数据并行仍然无法解决“单卡装不下模型”的问题。
这时候就需要把模型本身拆开。
模型并行是怎么工作的
模型并行并不是只有一种方式。
最常见的方式之一是张量并行,也就是 Tensor Parallelism。以一个大型线性层为例,如果权重矩阵太大,可以把矩阵的一部分放到 GPU 1,另一部分放到 GPU 2。两个 GPU 分别完成自己的矩阵计算,然后通过高速互联交换必要的数据。
对于 Transformer 来说,注意力层和前馈网络中的大型矩阵运算都可以采用类似方式进行切分。
这样,一个原本需要 120GB 显存的模型,就可能被分布到两张或者更多 GPU 上。每张 GPU 保存的只是模型的一部分,而不是完整模型。
但张量并行有一个代价:GPU 之间需要频繁通信。
如果两张 GPU 位于同一台服务器中,而且通过 NVLink 等高速互联连接,通信通常比较容易控制。如果模型被拆到不同服务器上,就必须考虑 PCIe、InfiniBand 或其他高速网络的延迟和带宽。
因此,模型并行并不是“GPU 越多越快”。如果通信量太大,增加 GPU 数量反而可能让计算时间大量消耗在等待数据交换上。
Pipeline Parallelism 解决的是另一种问题
另一种常见方法是流水线并行,也就是 Pipeline Parallelism。
例如,一个 Transformer 模型包含很多层,可以把前面的一部分层放在 GPU 1,中间部分放在 GPU 2,后面的层放在 GPU 3 和 GPU 4。
输入首先经过 GPU 1 的几层计算,然后把中间结果交给 GPU 2,再继续向后计算。
这样,每张 GPU 不需要保存整个模型,而只需要保存自己负责的模型层。
这种方法特别适合层数很多的大型 Transformer 模型。不过,如果设计不合理,就会出现流水线空闲的问题。GPU 1 在等待新的输入时,GPU 2 和 GPU 3 可能没有工作可做,导致昂贵的 GPU 资源利用率下降。
因此,实际训练通常会把一个批次进一步切成多个 micro-batch,让不同 GPU 尽可能同时工作。
大模型训练通常不是只选择一种并行方式
真正的大模型训练往往会把数据并行、张量并行和流水线并行组合起来。
例如,一台服务器内部有多张 GPU,可以使用 Tensor Parallelism 把一个模型拆到多张 GPU 上;多台服务器之间再使用 Pipeline Parallelism;在更高一层,又可以复制整个模型副本,让不同副本处理不同的数据批次。
这类组合通常被称为 3D Parallelism。
假设一个训练集群有 64 张 GPU,并不是简单地让 64 张 GPU 同时运行完全相同的模型。工程师需要决定哪些 GPU 属于一个张量并行组,哪些 GPU 负责流水线阶段,又有多少个完整模型副本承担数据并行。
这个设计直接决定了通信量、显存占用和整体训练效率。
如果只是推理,解决办法会更多
当问题从“训练模型”变成“运行模型”时,选择会更加丰富。
第一种方法是量化。
例如把 FP16 或 BF16 权重转换成 INT8、INT4 等更低精度格式,可以显著降低权重占用的显存。一个原本无法装进单张 GPU 的模型,在量化之后可能就能够运行。
当然,量化并不是免费午餐。不同模型、不同量化算法和不同任务对精度的影响并不相同,而且推理性能是否提高还取决于 GPU 是否针对相应低精度计算进行了优化。
第二种方法是模型分片,也就是把权重分布到多张 GPU 上。
例如一台服务器有四张 48GB GPU,一个模型需要大约 100GB 权重,那么可以把模型分布到多张 GPU,而不要求任何一张 GPU 保存完整模型。
第三种方法是把部分数据放到 CPU 内存。
某些推理框架允许模型权重或者缓存的一部分放在 CPU RAM 中,需要计算时再搬到 GPU。这可以突破单卡显存限制,但 PCIe 等设备之间的数据传输速度远低于 GPU 本地显存,因此通常需要在显存占用和推理速度之间进行权衡。
第四种方法是使用更大显存的 GPU。
这听起来最简单,却往往是最有效的工程方案。
如果一个模型需要 70GB 显存,一张 80GB GPU 可能就可以运行;如果模型需要 100GB,那么换成更大显存的 GPU,有时比设计复杂的多 GPU 模型并行架构更加简单。
因此,模型并行并不是默认答案,而是硬件资源、模型规模和性能要求共同决定的工程选择。
KV Cache 还会制造第二个显存瓶颈
很多人在模型能够装进 GPU 后,会发现运行长上下文或者高并发请求时,显存仍然不断上涨。
原因之一就是 KV Cache。
Transformer 在自回归生成过程中,需要保存已经计算过的 Key 和 Value,避免每生成一个 token 都重新计算全部历史上下文。上下文越长、并发请求越多,KV Cache 占用的显存通常越大。
例如,一个模型在单用户短上下文测试中只占用几十 GB 显存,但到了生产环境,同时服务几十个用户,每个用户又拥有很长的上下文,KV Cache 就可能成为新的瓶颈。
这时候,仅仅把模型权重拆到更多 GPU 上还不够,还需要考虑 KV Cache 的管理、批处理策略以及显存复用。
为什么 NVLink 和高速网络如此重要
模型并行真正难的地方,不是把模型文件切成几份,而是让这些 GPU 在切开模型之后仍然能够高效率地协同工作。
如果 GPU 1 计算完一部分结果,需要把几十 MB 甚至更多的数据发送给 GPU 2,而 GPU 2 又需要等待数据到达,那么 GPU 本身再快也没有意义。
因此,大模型服务器非常重视 GPU 之间的互联技术。
同一台服务器内部可以通过 PCIe 或 NVLink 等方式连接 GPU;跨服务器训练则通常需要高速网络,例如 InfiniBand。通信库还会利用 AllReduce、AllGather 等集合通信操作完成参数、激活值或梯度的交换。
这也是为什么两台普通 GPU 服务器简单通过普通以太网连接,并不一定能够获得理想的模型并行性能。
当单个模型无法放进一张 GPU 时应该怎么办
真正的工程判断通常可以按照几个步骤进行。
首先计算模型权重到底需要多少显存,并明确使用 FP32、FP16、BF16、INT8 还是 INT4。
其次区分任务到底是训练还是推理。训练需要考虑梯度、优化器状态和激活值;推理则需要重点考虑权重、KV Cache、批量大小和上下文长度。
如果模型经过量化后可以放入单张 GPU,推理任务往往优先考虑量化,因为架构最简单。
如果量化之后仍然放不下,就可以考虑模型分片,把模型部署到多张 GPU。
如果是大规模训练,则通常进一步考虑 Tensor Parallelism、Pipeline Parallelism、Data Parallelism 以及它们的组合。
最后才是评估硬件本身。如果模型规模和业务需求已经明确,而现有 GPU 显存始终无法满足要求,那么增加显存容量、增加 GPU 数量或者采用更适合大模型的计算节点,往往比不断修改软件配置更加有效。
模型并行真正解决的,是“计算能力还在,但单个计算设备已经装不下整个模型”这一矛盾。它把原本必须由一块 GPU 独立承担的模型参数和计算任务拆分到多个计算设备上,使大模型能够突破单卡显存的物理限制。但模型拆开之后,通信、同步、负载均衡和显存管理又成为新的工程问题。
因此,大模型的 GPU 集群并不是简单地把更多显卡堆在一起。真正决定性能的,是模型如何切分、GPU 如何互联、数据如何流动,以及每一次通信是否值得付出相应的时间成本。对于越来越大的模型而言,显存容量只是第一道门槛,而如何让几十张甚至数千张 GPU 像一个高效的计算系统一样协同工作,才是模型并行真正困难的地方。
模型并行解决了什么问题,当单个模型无法放进一张 GPU 时应该怎么办
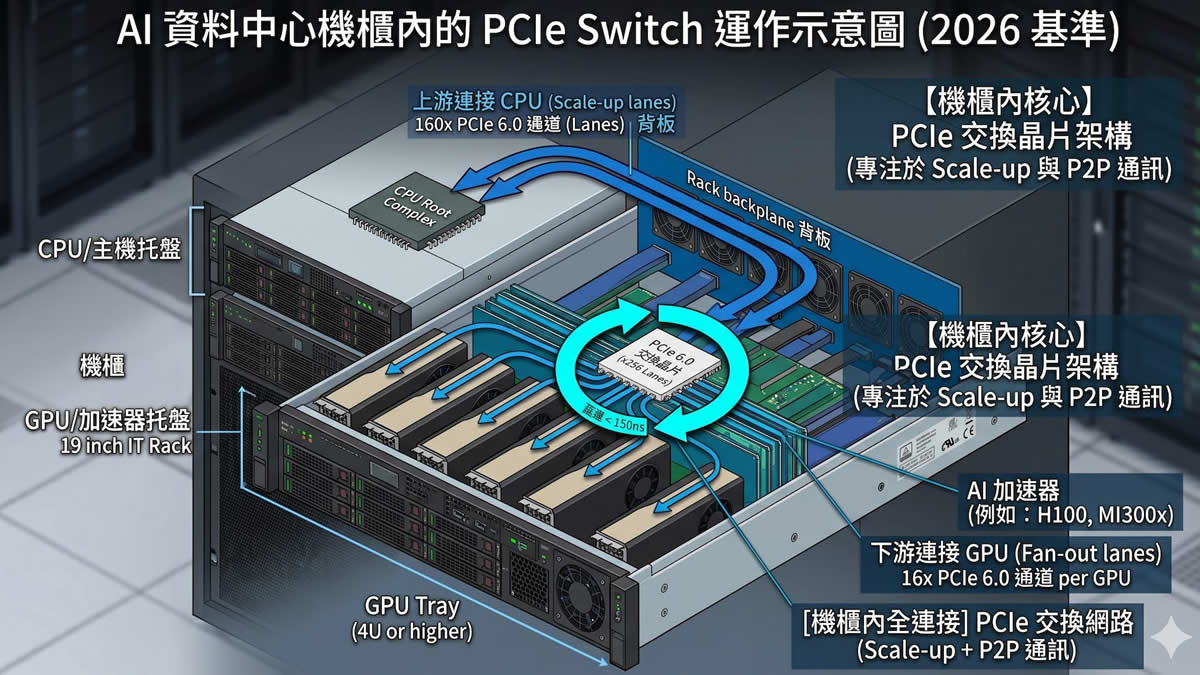
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP