
张量并行如何拆分模型计算 大型语言模型为什么需要多张GPU协同工作
随着大型语言模型的参数规模和计算需求不断增长,单张 GPU 即使拥有较强的计算能力,也可能无法容纳完整模型的权重、运行时激活值以及训练所需的梯度和优化器状态。即使模型能够勉强装入显存,计算吞吐量、内存带宽和推理延迟也可能成为新的瓶颈。张量并行(Tensor Parallelism)正是解决这类问题的重要技术之一。它将一个神经网络层中的大型矩阵运算拆分到多张 GPU 上,让不同设备共同完成原本由单个设备承担的计算。
张量并行并不是简单地把模型文件平均分成几份,再让每张 GPU 独立运行。它需要根据 Transformer 的矩阵结构划分权重和计算任务,并通过 GPU 之间的通信交换中间结果。拆分方式是否合理、通信能否与计算有效重叠,以及 GPU 之间的互连带宽是否充足,都会影响最终性能。因此,理解张量并行,关键是弄清楚模型中的矩阵如何切分、切分之后哪些结果必须合并,以及为什么增加 GPU 并不一定带来同比例的速度提升。
一、张量并行解决的是什么问题
Transformer 模型包含大量线性层和矩阵乘法。例如,自注意力模块需要根据输入隐藏状态计算查询(Query)、键(Key)和值(Value),再根据注意力权重汇总信息;前馈网络则通过多个线性变换扩展和压缩隐藏维度。这些操作在模型规模增大时,会产生庞大的权重矩阵和计算负载。
假设某一线性层的权重矩阵为 (W),输入为 (X),其核心计算可以表示为:
[
Y=XW
]
如果 (W) 的维度很大,单张 GPU 就必须保存相应权重,并承担整个矩阵乘法的计算。张量并行可以沿矩阵的某个维度拆分 (W),将不同的权重分片放到不同 GPU 上。每张 GPU 只保存自己负责的部分权重,并执行对应的局部计算。
假设使用 (N) 张 GPU,将矩阵划分为 (N) 个分片。在理想情况下,每张 GPU 需要保存的这一部分权重约为原矩阵的 (1/N)。但这并不代表整张 GPU 的显存占用必然降至原来的 (1/N),因为输入、输出、中间激活值、通信缓冲区、临时工作空间以及其他模型组件仍然需要占用显存。
此外,训练和推理的显存构成也不相同。训练时还需要考虑梯度、优化器状态和反向传播所需的激活值;自回归推理时,则可能需要保存键值缓存(KV Cache)。因此,张量并行能够降低部分模型状态在单卡上的占用,但实际显存节省幅度取决于具体模型、训练框架和并行配置。
二、Transformer 的矩阵究竟怎样拆分
张量并行最常见的两种基本策略是列并行和行并行。它们不是简单地选择一个方向切割矩阵,而是根据矩阵乘法的计算结构,决定哪些操作可以独立执行,以及在哪些位置需要跨设备通信。
以线性层 (Y=XW) 为例,如果沿输出维度切分权重矩阵,可以将其写成多个列分片:
[
W=[W_1,W_2,\ldots,W_N]
]
每张 GPU 分别计算:
[
Y_i=XW_i
]
各设备得到的结果对应不同的输出特征,可以沿输出维度拼接,形成完整的 (Y)。这种方式常用于 Transformer 注意力模块中的查询、键、值投影,以及前馈网络中扩展隐藏维度的线性层。
另一种方式是沿输入维度拆分权重矩阵。此时,输入也需要按照相应维度分片,每张 GPU 计算部分乘积,最后通过求和等方式组合各设备的局部结果。以常见的行并行线性层为例,可以写成:
[
Y=\sum_{i=1}^{N}X_iW_i
]
这里的 (X_i) 和 (W_i) 是对应的输入与权重分片。各 GPU 完成局部矩阵乘法后,需要通过跨设备规约操作得到完整输出。
列并行和行并行经常在 Transformer 中配合使用。前一层按输出维度生成分片,后一层再按输入维度处理这些分片,从而减少不必要的数据拼接与重复计算。具体实现还会考虑偏置项、残差连接、归一化以及激活函数的位置,不能只看权重矩阵的切分方向。
三、为什么 QKV 投影和注意力输出适合张量并行
在多头自注意力机制中,隐藏状态需要经过线性投影,形成查询、键和值。对于包含多个注意力头的模型,可以将不同的注意力头分配给不同 GPU,使各设备负责一部分头的计算。
例如,一个具有多个注意力头的层,可以让每张 GPU 计算其中若干个头的查询、键和值,并独立完成这些头的注意力分数计算和加权汇总。由于不同头的计算在这一阶段具有较强的独立性,这种切分能够有效利用多张 GPU 的并行计算能力。
不过,注意力计算并不意味着整个模块可以完全独立运行。各设备完成局部注意力计算后,通常还需要经过输出投影,将各头的结果组合起来。实际框架会根据张量布局、并行组和具体算子安排通信操作,有时采用 All-Reduce,有时采用 Reduce-Scatter、All-Gather 或其他通信模式。
在标准多头注意力中,QKV 投影常采用列并行,注意力输出投影常采用行并行。对于分组查询注意力(GQA)、多查询注意力(MQA)以及不同的注意力实现,具体分片方式可能有所不同。特别是在推理场景中,KV Cache 的布局、每张 GPU 保存的键值头数量以及缓存读写带宽,也会影响张量并行的实际收益。
四、All-Reduce 为什么重要,但并非所有通信都靠它
张量并行的难点之一,是局部计算完成后如何获得后续算子所需的完整结果。不同设备持有不同的权重分片,因此某些计算结果必须拼接,另一些则必须求和或交换数据。
All-Reduce 是一种常见的集合通信操作。它会对多个设备提供的数据执行规约,例如求和,并将规约结果分发给参与通信的设备。在某些张量并行实现中,All-Reduce 用于组合局部矩阵乘法的结果,使后续层能够继续执行。
但不能将张量并行中的所有参数分发、梯度同步和结果合并都归结为 All-Reduce。列并行产生的分片结果可能需要 All-Gather;分片求和的某些流程可以使用 Reduce-Scatter;数据并行中的梯度同步也经常使用 All-Reduce。实际采用哪种操作,取决于张量切分方式、数据布局以及框架的通信优化策略。
在训练过程中,前向传播需要传递中间结果,反向传播则需要计算并传递相应梯度。通信次数、每次传输的数据量以及通信与计算之间能否重叠,都会影响整体训练效率。如果矩阵规模较小,通信时间可能占据较高比例;如果计算量足够大、互连速度足够高,张量并行才更容易体现优势。
五、为什么多张 GPU 不一定让训练速度线性增长
张量并行可以把计算分散到多张 GPU,但增加设备数量也会增加通信和调度成本。假设原本由一张 GPU 完成的矩阵运算被拆分到八张 GPU,每张设备承担的局部计算减少了,但设备之间必须交换中间结果。如果通信所花费的时间接近甚至超过节省的计算时间,整体性能就不会明显改善。
GPU 之间的互连是影响张量并行效率的重要因素。NVLink 等高速互连技术可以提高设备之间的通信带宽,降低部分通信瓶颈。在多机环境中,还需要考虑节点间网络、交换设备、拓扑结构和通信库的性能。即使每张 GPU 的计算能力都很强,如果跨节点通信速度不足,张量并行仍可能受到明显限制。
因此,张量并行通常优先在互连速度较高、拓扑结构适合的 GPU 组内使用。对于需要跨越多个服务器的模型,工程团队还需要测试不同并行规模下的吞吐量、延迟和通信占比,而不是单纯根据 GPU 数量判断性能。
实际部署时,应重点观察 GPU 利用率、显存占用、集合通信耗时、矩阵乘法效率以及端到端吞吐量。只有通过基准测试确定瓶颈,才能判断继续增加张量并行规模是否值得。
六、张量并行与数据并行有什么区别
张量并行和数据并行都用于分布式训练,但它们解决的瓶颈不同。
张量并行将单个模型层的计算拆分到多个设备上,主要目标是降低单卡承担的模型计算与部分显存负担,使大型矩阵运算能够跨设备完成。数据并行则通常让多个设备持有相同模型的副本,每张设备处理不同的训练样本或微批次,再对梯度进行同步,以提高整体训练吞吐量。
对于一个能够完整放入单卡显存的模型,数据并行可能已经足以提升训练吞吐量;对于单卡无法容纳或难以高效计算的模型层,张量并行则可以将该层拆分到多张 GPU 上。大规模训练系统往往将两者组合起来:先用张量并行划分模型,再用数据并行处理不同的数据分片。
此外,流水线并行(Pipeline Parallelism)会将模型的不同层分配给不同设备或设备组,通过微批次流水执行来提高资源利用率。对于超大规模模型,还可能结合专家并行(Expert Parallelism),将混合专家模型中的不同专家分配到不同设备。不同并行方式并非相互替代,而是针对模型规模、网络拓扑和训练目标进行组合。
七、训练与推理中的张量并行有什么不同
训练时,张量并行需要处理前向传播、反向传播和梯度相关计算。模型权重、梯度、优化器状态和激活值共同决定显存需求,因此张量并行往往与数据并行、流水线并行及其他显存优化技术配合使用。
推理时,主要目标通常是提高生成吞吐量、降低单请求延迟,并让模型能够装入可用显存。张量并行可以将权重分布在多张 GPU 上,适用于单卡无法容纳的模型,也可以在合适的硬件和工作负载下提升计算速度。不过,自回归生成具有逐步产生 Token 的特点,每一步都可能涉及跨设备通信。对于小批量、短序列或通信条件不佳的任务,张量并行带来的通信成本可能抵消部分计算收益。
推理系统还需要考虑 KV Cache 的容量与分布。随着上下文长度和并发请求增加,KV Cache 可能成为显存占用的重要组成部分。张量并行能否有效降低整体显存压力,取决于模型的注意力结构、缓存分片策略和推理框架实现,而不是只看模型权重被切成了多少份。
八、如何选择合适的张量并行规模
部署大型语言模型时,不能简单认为 GPU 越多越好。企业或研究团队应先确认模型权重、运行时激活值或 KV Cache 是否能够满足单卡或单节点的显存预算,再评估计算吞吐量和通信开销。
如果模型无法放入单卡显存,张量并行可能是必要的选择。如果模型可以放入单卡,但需要处理大量并发请求,则应通过基准测试比较单卡、多卡张量并行和多副本部署的吞吐量与延迟。对于可以通过数据并行增加副本的工作负载,增加模型副本有时比让所有请求共享一个大型张量并行组更合适。
还应结合 GPU 显存容量、设备间互连带宽、服务器拓扑、框架支持情况以及应用的批量大小进行测试。常见的实践是先在单节点内寻找有效的张量并行规模,再根据显存需求和吞吐量目标决定是否扩展到多节点,并同时评估跨节点通信成本。
张量并行的核心价值,是将单个模型层的权重和计算拆分到多个设备,让原本受单卡显存或计算能力限制的模型能够运行,并在合适的硬件条件下提升计算效率。但它并不能消除所有显存瓶颈,也无法保证设备数量增加后性能线性增长。真正高效的大模型系统,需要根据模型结构、数据流、通信拓扑和业务目标,合理组合张量并行、数据并行与流水线并行,才能在显存、吞吐量和延迟之间取得平衡。
张量并行如何拆分模型计算,大型语言模型为什么会使用这种方式
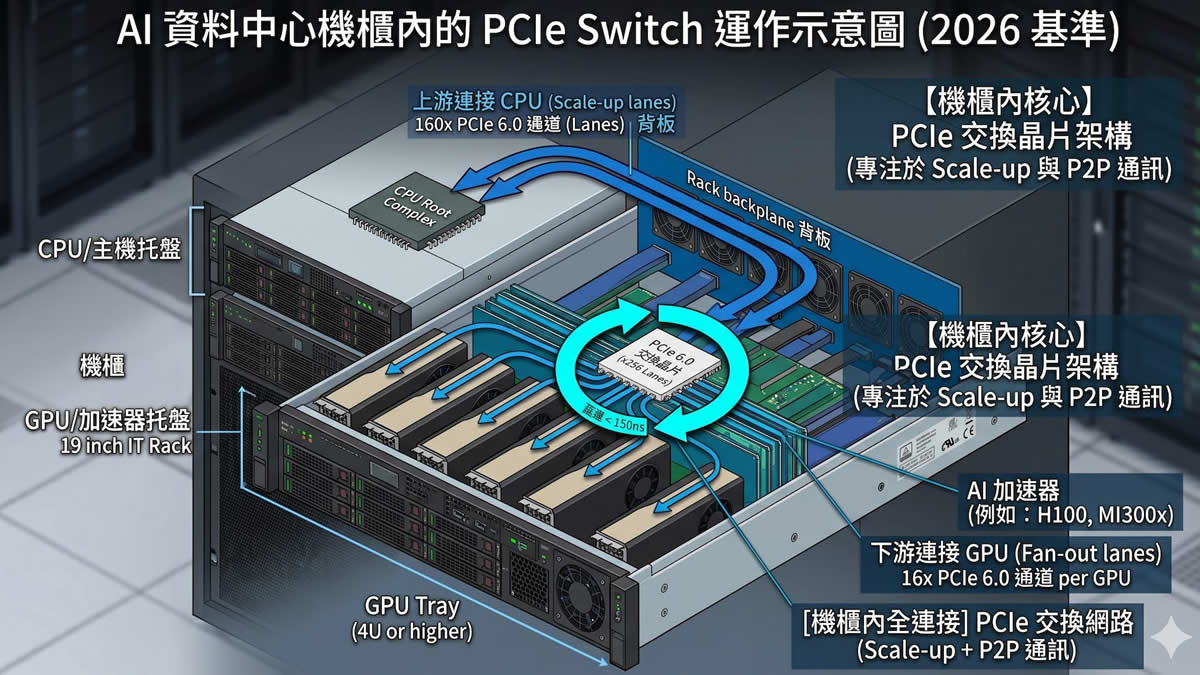
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP