
当一个大语言模型的参数量和运行时显存需求超过单张 GPU 的承载能力时,工程团队往往需要把模型拆分到多张 GPU 上运行。流水线并行(Pipeline Parallelism)就是其中一种重要方案。它将模型中的不同层或模块分配给不同 GPU,再把一批输入拆成多个微批次,让不同 GPU 尽可能同时处理不同数据。部署效果不仅取决于模型能否装进显存,更取决于各阶段能否连续接力,以及通信、计算和显存管理能否协调工作。
模型怎样分配到不同 GPU
流水线并行首先要确定模型的切分位置。以由许多 Transformer 层组成的大语言模型为例,可以把前面若干层放在 GPU 0,中间部分放在 GPU 1,后面的层放在 GPU 2 和 GPU 3。输入经过第一阶段后,产生的中间结果通常称为激活值(Activations),这些数据通过设备间通信传给下一阶段,直至完成整个前向计算。
切分模型时,不能简单地按照层数平均分配。不同层的计算量、张量尺寸、注意力机制、序列长度和显存需求可能不同;即使每张 GPU 分到相同数量的层,实际执行时间也未必相同。更合理的做法是测量各层在目标硬件、目标批次和目标序列长度下的执行时间,再综合显存容量、通信量和设备连接方式确定切分点。对于跨服务器的流水线,还要考虑网络带宽和通信延迟,因为阶段之间传递的激活值可能成为重要开销。
实际部署通常先采用静态划分,再根据性能分析结果调整切分方案。运行过程中动态迁移模型层并非不能实现,但涉及参数搬移、显存重新分配、调度变化和同步成本,不能把它当作随时自动调整的通用解决办法。对于大多数训练任务,提前测量并合理划分阶段,往往比频繁改变模型分布更容易控制。
流水线空闲时间从哪里来
如果每张 GPU 只处理同一个批次的数据,那么第一阶段完成计算后,后续阶段才能开始工作;等数据逐级传递到最后一张 GPU 时,前面的 GPU 可能已经暂时无事可做。这种启动和收尾阶段出现的空档,以及阶段执行速度不一致造成的等待,通常统称为流水线气泡(Pipeline Bubble)。
解决这个问题的关键是把一个较大的批次拆成多个微批次。例如,GPU 0 处理第一个微批次时,GPU 1 可能还没有可用输入;当 GPU 0 开始处理第二个微批次时,GPU 1 就可以接手第一个微批次。随后,GPU 2 处理更早的微批次,而前两张 GPU 继续推进后续数据。流水线进入稳定运行阶段后,多张 GPU 可以同时执行不同微批次,从而提高整体利用率。
微批次数量会影响流水线气泡的比例。一般来说,在其他条件相近时,增加微批次有助于缩短启动和收尾空档,但微批次过多也会增加调度开销,并可能带来更多通信操作或更复杂的显存管理。因此,不能只追求微批次越多越好,而应结合总批次大小、阶段数量、每个微批次的计算时间和显存容量进行测试。
训练调度如何减少空档
不同流水线调度策略会改变前向计算、反向计算和梯度处理的顺序。GPipe 采用先执行各微批次前向计算、再执行反向计算的填充与排空方式,容易理解,但某些阶段可能需要保留较多激活值。1F1B(One Forward, One Backward)调度则在进入稳定阶段后,交替执行微批次的前向与反向计算,通常有助于控制激活值的存储需求。交错式流水线还可以让同一 GPU 承担多个虚拟阶段,以改善负载安排,但调度和通信管理也会更加复杂。
部分零气泡调度尝试利用原本容易闲置的时间执行权重梯度计算等任务,从而进一步填补空档。不过,“零气泡”是特定调度和执行时间条件下的目标,并不意味着真实集群能够完全消除所有等待。不同阶段的前向、反向和通信时间并不总是相等,实际效果仍需通过性能测量验证。
工程人员还应区分计算依赖和可重叠工作。某个阶段所需的输入尚未到达时,GPU 不能直接执行依赖该输入的计算,但系统可以在条件允许时,把通信与其他已就绪的计算任务重叠起来,也可以提前准备数据、复用缓冲区或安排其他阶段的工作。异步通信的价值在于让 CPU 或 GPU 不必在每次传输启动后立即停下来等待,而不是让尚未获得输入的计算凭空提前完成。
负载均衡与通信优化
流水线的持续吞吐量通常受到最慢阶段的限制。如果 GPU 0 每个微批次需要 8 毫秒,GPU 1 需要 12 毫秒,而 GPU 2 只需 6 毫秒,那么中间阶段就可能成为瓶颈。即使其他 GPU 性能充足,它们也无法无限加快整个流水线的处理速度。此时需要重新调整层的分配、测量实际执行时间,并检查是否存在某些算子、长序列或显存访问造成的额外开销。
通信同样需要单独分析。单台服务器内部,可以利用 NVLink 等高速互连改善 GPU 之间的数据传输;跨服务器部署时,InfiniBand 等高速网络可能有助于降低通信开销。硬件升级并不能替代合理的模型切分:如果阶段之间传递的数据量过大、通信调用过于频繁,或者某个阶段计算严重不均衡,即使网络带宽很高,整体效率仍可能不理想。
数据预处理也需要关注,但它与流水线气泡不是同一个问题。如果输入数据准备不及时,第一阶段可能缺少任务;如果阶段间通信受阻,后续 GPU 可能等待激活值;如果计算阶段本身速度不均,则可能形成持续的排队和空闲。只有结合 GPU 利用率、各阶段执行时间、通信等待时间、显存占用和数据加载耗时,才能判断主要瓶颈在哪里,而不是一律通过缓存或异步加载解决。
与数据并行等策略配合
大规模训练通常不会只使用一种并行方式。流水线并行负责把模型分布到不同阶段,数据并行则让多个模型副本处理不同的数据分片;张量并行还可以把单个层中的矩阵运算拆分到多张 GPU 上。不同策略可以组合使用,但也会增加通信量、同步要求和调度复杂度。具体方案要看模型大小、训练批次、GPU 显存、服务器拓扑以及目标吞吐量。
推理部署也可以使用流水线并行,但优化目标与训练有所不同。训练既要处理前向计算,也要处理反向传播和梯度;推理更关注请求延迟、并发请求数量、批处理效率和显存占用。对单个请求,流水线阶段仍需依次传递结果,未必能降低端到端延迟;当多个请求或多个微批次能够并行推进时,流水线才更有机会提高整体吞吐量。
流水线并行的实际价值,不是简单地把模型层平均放到多张 GPU 上,而是让模型切分、微批次调度、通信和显存管理相互配合。部署时应先测量各阶段的真实成本,再选择适合的调度方式,并通过持续监控验证优化是否有效。GPU 利用率只是一个指标,最终还要看单位时间完成的训练样本或推理请求数量、端到端延迟、显存峰值和系统稳定性。只有这些指标共同改善,流水线优化才真正转化为计算资源的有效利用。
流水线并行怎样把模型分布到不同 GPU,实际部署中如何处理流水线空闲时间
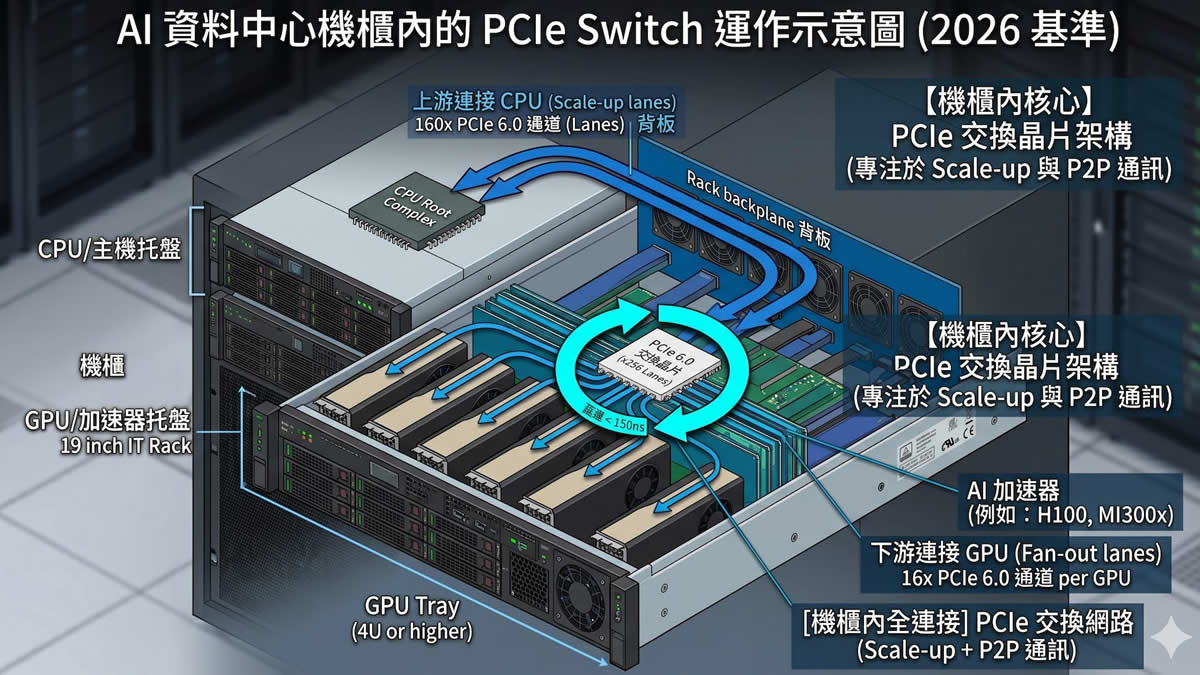
图片说明:示意图 图片来源:Public Domain(公有领域)
喜欢这篇报道?
使用下面的功能,方便以后继续阅读和分享 MNewsTV
关于文章收藏
收藏不需要注册帐号,收藏信息仅保存在当前浏览器中。
删除收藏请进入「我的收藏」进行管理。
捐助(Paypal): https://www.paypal.me/observeccp 订阅中国观察电报 Telegram : https://t.me/s/ObserveCCP